
Почему вычисления ИИ устроены как прямоугольники: CEO Modal объяснил после раунда на $750 млн
Эрик Бернхардссон, основатель платформы Modal, в интервью подкасту Latent Space объяснил, почему контракты на GPU (графические процессоры, главную вычислительную силу нейросетей) устроены неэффективно и как его компания решает эту проблему после раунда на 750 миллионов долларов.
Modal пересекла отметку в миллиард долларов годовой выручки и привлекла 750 миллионов долларов при оценке в 16 миллиардов. Рост построен на простой идее: реальная нагрузка ИИ никогда не совпадает с тем прямоугольником мощности, который покупает клиент, и кто-то должен закрыть этот разрыв.
Два года назад Бернхардссон описывал Modal как бессерверную инфраструктуру: разработчик запускает код, не арендуя кластер и не платя за простой. Сейчас компания обслуживает тысячи клиентов, запустила почти три миллиарда песочниц (sandbox, изолированная среда для безопасного запуска кода) и вышла на рынок ИИ-агентов. В интервью Бернхардссон разложил экономику и архитектуру, которые за этим стоят. Для тех, кто работает с нейросетями в России, его логика объясняет, почему облачные GPU стоят столько, сколько стоят, и как формируется цена инференса (inference, процесс, когда обученная модель выдаёт результат на ваш запрос).
Почему прямоугольник не совпадает с реальностью?
Стандартный контракт на GPU выглядит так: клиент покупает фиксированное количество процессоров на фиксированный срок. Если нарисовать это на графике «мощность и время», получится прямоугольник. Но реальная нагрузка ведёт себя иначе: она растёт, падает, выстреливает пиками и проваливается ночью.
Купить мощность под пик означает платить за простой в остальное время. Купить меньше означает терять запросы в часы нагрузки. Бернхардссон называет решение Modal «трансформацией длительности»: компания объединяет спрос тысяч клиентов в общий пул, закупает мощности снизу и отдаёт каждому ровно столько, сколько нужно в конкретную секунду. Чем ровнее совокупный спрос, тем выгоднее пул.
Есть и обратный риск. Если провайдер зафиксировал цену на GPU, а рыночная цена потом упала, он остаётся с дорогим запасом. Бернхардссон говорит, что не ждёт обвала цен прямо сейчас, но учитывает такой сценарий при планировании бизнеса.
Песочницы: продукт, который чуть не закрыли
Modal запустила песочницы, когда Бернхардссон и сооснователь Акшат Бубна заметили: языковые модели научились генерировать код, и этому коду нужно место для запуска. Первые месяцы спрос был настолько скромным, что команда обсуждала закрытие продукта.
Затем появились кодирующие ИИ-агенты (agent, программа, которая сама выполняет цепочку действий без участия человека), фоновые агенты и задачи обучения с подкреплением. Спрос вырос, и сейчас песочницы приносят примерно треть выручки Modal, по словам Бернхардссона.
Это меняет требования к инфраструктуре. ИИ-агент может создать среду, запустить код, проверить результат и повторить цикл много раз. Скорость запуска и восстановления среды становится частью пользовательского опыта, а не технической деталью.
Быстрый старт как инженерная задача
Эластичность бессмысленна, если мощность приходит слишком медленно. Modal использует буфер доступных GPU, собственную файловую систему, чекпоинтинг процессов (сохранение состояния работающей программы) и снимки памяти GPU. Эти механизмы сокращают время, нужное для запуска новой копии модели.
Для практика это означает: если вы запускаете инференс через платформу с эластичным масштабированием, задержка при росте нагрузки будет заметно меньше, чем при ручном добавлении серверов. Именно за эту разницу платят клиенты Modal.
Что понадобится
Чтобы применить логику «не-прямоугольных» вычислений к своим задачам:
- Понимание собственного профиля нагрузки: когда ваши запросы к нейросети пиковые, а когда простой
- Доступ к платформе с эластичным масштабированием (Modal, а для РФ ближайшие аналоги: Yandex Cloud ML Platform, Cloud.ru с GPU-инстансами, SberCloud)
- Калькулятор или таблица для сравнения: сколько вы платите за фиксированный контракт и сколько потратите при оплате по факту
- 30 минут на анализ графика нагрузки за последний месяц
Пошаговая инструкция
-
Выгрузите статистику запросов к вашей модели или API за последние 30 дней. Если используете YandexGPT, GigaChat или внешние API, в личном кабинете есть раздел с историей вызовов.
-
Постройте график «количество запросов по часам суток». Подойдёт даже Google Sheets.
-
Найдите пиковый час и минимальный час. Разделите пик на минимум. Если коэффициент больше 3, вы переплачиваете за фиксированную мощность.
-
Посчитайте стоимость фиксированного контракта за месяц и сравните с ценой по запросу (pay-per-use) на той же платформе. Формула:
Переплата = (Стоимость фикса за месяц) - (Сумма [запросов в час × цена за запрос] по всем часам месяца)
-
Если переплата превышает 30% от фикса, переход на эластичную модель экономически оправдан. Если меньше 10%, фиксированный контракт выгоднее из-за предсказуемости.
-
При переходе начните с некритичных задач: тестовые среды, пакетная обработка, ночной инференс. Оставьте продакшен на фиксе, пока не убедитесь в стабильности.
Автор Дзена использует API GigaChat для генерации черновиков. В будни с 10 до 14 он отправляет 40 запросов в час, ночью и в выходные ноль. Фиксированный тариф рассчитан на постоянную нагрузку и стоит условные 5 000 рублей в месяц. При оплате по факту те же 40 запросов в пиковые часы обходятся в 2 800 рублей. Разница 44%. Этот автор как раз тот случай, где «прямоугольник» контракта не совпадает с реальной нагрузкой: он платит за ночные часы, которые не использует.
Первая ошибка: считать, что эластичная модель всегда дешевле. Если нагрузка ровная (например, чат-бот службы поддержки, который работает круглосуточно), фиксированный контракт выгоднее. Проверяйте свой коэффициент пик/минимум, прежде чем менять тариф.
Вторая: игнорировать задержку холодного старта. Эластичные платформы поднимают мощность не мгновенно. Если ваш сервис обслуживает пользователей в реальном времени, задержка в 5 секунд при первом запросе после простоя заметна и раздражает.
Третья: не учитывать валютный риск. Modal и аналогичные западные платформы выставляют счета в долларах. Для бизнеса в РФ колебание курса может съесть всю экономию от перехода на pay-per-use.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Если вы используете нейросети для генерации текстов, изображений или озвучки через API, проверьте свой профиль нагрузки. Скорее всего, вы работаете рывками: утром написали пять постов, остаток дня тишина. Оплата по факту может сэкономить от 30 до 50% бюджета на API.
Маркетологу. Логика Бернхардссона объясняет, почему облачные GPU дешевеют для коротких задач и дорожают для длинных. Если вы запускаете пакетную обработку (например, перегенерацию тысяч описаний товаров), планируйте её на часы минимальной нагрузки платформы. Ночной инференс часто дешевле дневного.
Предпринимателю в РФ и СНГ. Modal напрямую из России недоступна. Из российских платформ эластичное масштабирование GPU предлагают Yandex Cloud и Cloud.ru. Принцип тот же: не покупайте фиксированный кластер, пока не убедились, что ваша нагрузка действительно ровная. Начните с тарифа по запросу, соберите статистику за месяц, потом решайте.
Бернхардссон описывает вещь, которую я вижу на практике у авторов и небольших команд: люди покупают подписки и серверы «с запасом», а реальная утилизация редко превышает 20 процентов. Метафора с прямоугольником проста и точна. Но честная оговорка: для большинства наших читателей проблема пока не в GPU-кластерах, а в лишних подписках на ChatGPT Plus, Midjourney и Claude Pro, которые простаивают по полмесяца. Начните с аудита подписок: посчитайте, сколько дней в месяце вы реально пользуетесь каждым сервисом. Если меньше половины, дешевле платить за разовые запросы через API, чем держать ежемесячную подписку.
Концепция Modal показывает направление, в котором движется весь рынок облачных вычислений для ИИ: от аренды мощности блоками к оплате за реальное использование посекундно. Для тех, кто работает с нейросетями в России, практический вывод уже сейчас один: считайте свою нагрузку, прежде чем платить за чужой прямоугольник.
Научитесь считать реальную стоимость нейросетей
В dzen.guru мы разбираем экономику ИИ-инструментов для авторов и маркетологов: что окупается, а что съедает бюджет впустую.
Узнать больше
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
GPT-5.6 Sol нашла уязвимости в ядре PHP, которым пользуется 70% сайтов: патч готовили 2 месяца
Программа OpenAI Patch the Planet вместе с исследователями фирмы Calif и независимой командой Wiz обнаружила две критические уязвимости в ядре PHP, языка, на…
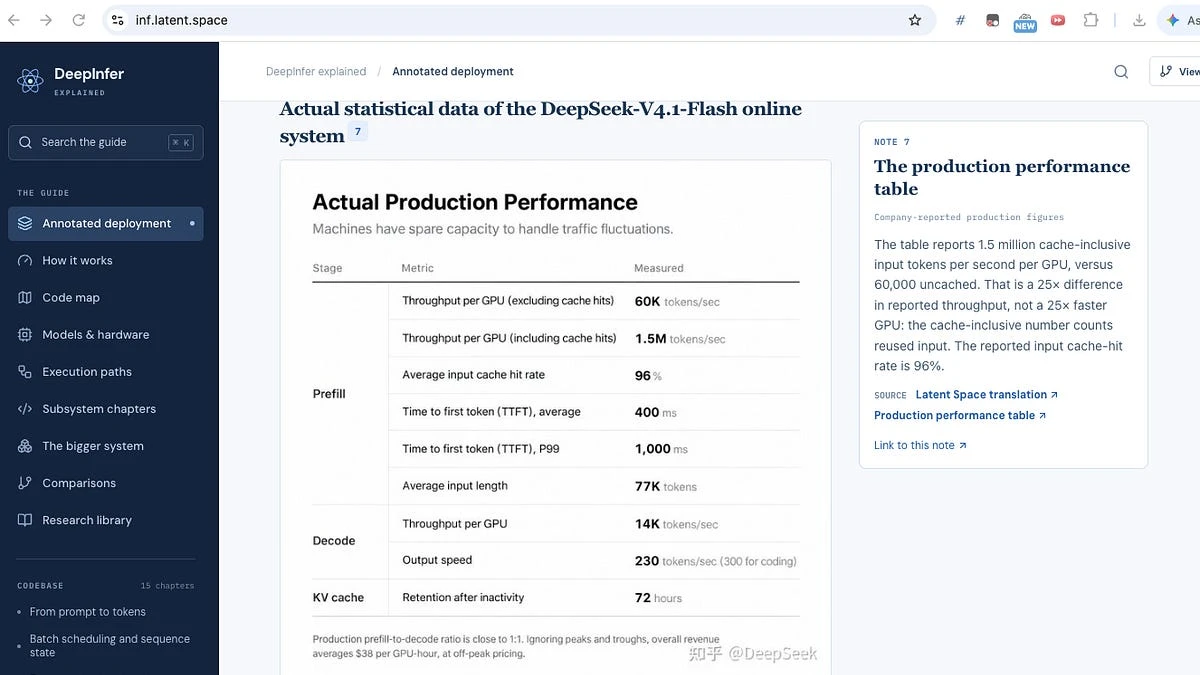
DeepSeek раскрыла экономику инференса: 155 трлн токенов в день и маржа выше 80%
DeepSeek второго дня конференции PyTorch Conf выложила в открытый доступ DeepInfer, собственный движок инференса (исполнения запросов к модели), на котором…
Tenex платит ИИ-инженерам за результат, а не за часы: как это работает для Fortune 2000
Почему это важно Tenex показывает работающую модель, где ИИ-инженерам платят за результат, а не за часы, и где каждое проектное решение хранится в репозитории…
Комментарии