
DeepSeek раскрыла экономику инференса: 155 трлн токенов в день и маржа выше 80%
DeepSeek второго дня конференции PyTorch Conf выложила в открытый доступ DeepInfer, собственный движок инференса (исполнения запросов к модели), на котором работает сервис V4.1 Flash, и впервые раскрыла производственные цифры кластера.
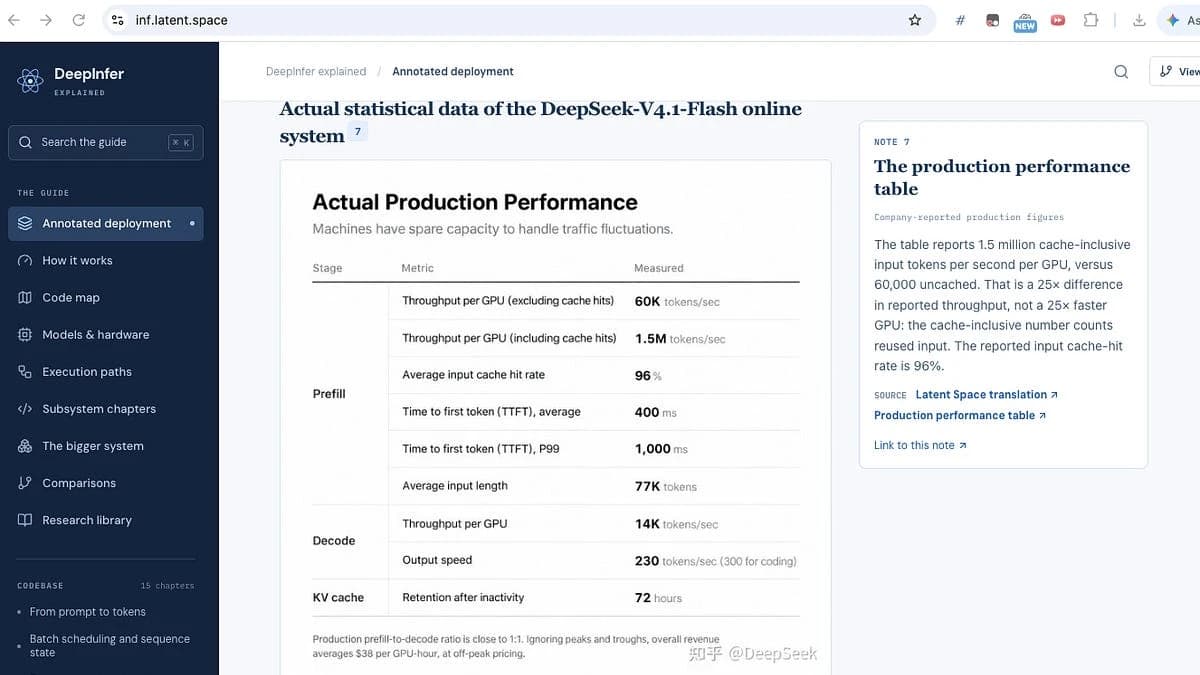
DeepSeek опубликовала не просто код, а инженерный отчёт с экономикой: сколько токенов обрабатывает кластер, какой процент запросов берётся из кэша и какую маржу приносит инференс, до сих пор такие данные от крупных провайдеров не публиковались в открытую.
До этого релиза почти все продвинутые платформы инференса оставались закрытыми: Fireworks, Baseten, Modal. DeepSeek сделала встречный ход со стороны опенсорса, выложив движок вместе с компонентом deepseek-recipe для обработки токенов (минимальных единиц текста, на которые модель разбивает слова). Источник этих данных: блог DeepSeek в переводе Latent Space и их собственные посты.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| DeepInfer, открытый движок инференса | Октябрь 2026, день открытия PyTorch Conf | DeepSeek | Код открыт, лицензия Apache 2.0 |
Что умеет DeepInfer?
- Кэширование промптов до 72 часов. Для сравнения: OpenAI в тот же период объявила о 12 часах. Кэширование означает, что повторные или похожие запросы не пересчитываются заново, а берутся из памяти, это экономит время и деньги.
- Раздельные стадии обработки. Движок разделяет кодирование изображений, предзаполнение (prefill, подготовка контекста) и декодирование (генерацию ответа). Каждая стадия масштабируется независимо, узкие места одной не тормозят другие.
- Поддержка двух платформ ускорителей. DeepInfer работает на чипах NVIDIA и на Huawei Ascend, что редкость для открытых движков.
- Спекулятивное декодирование и структурированный вывод. Модель «угадывает» несколько следующих токенов сразу и проверяет их пакетом, что ускоряет генерацию. Структурированный вывод позволяет получать ответ в заданном формате.
- Распределённый инференс. Запросы разносятся по кластеру из тысяч ускорителей. По данным DeepSeek, рекомендуемая конфигурация: восемь ускорителей на машину для предзаполнения и от 64 до 128 ускорителей в суперноде для декодирования.
Какие цифры назвала DeepSeek?
Компания опубликовала производственную статистику, но с оговоркой: это собственные заявления DeepSeek, не независимый аудит.
- 155 триллионов токенов в день с одного кластера.
- 96% попаданий во входной кэш, то есть подавляющее большинство входящих запросов не требует полного пересчёта.
- Среднее время до первого токена: 400 миллисекунд.
- Скорость генерации: 230 токенов в секунду, до 300 токенов в секунду для задач кодирования.
- При текущих ценах (0,15 доллара за миллион входных токенов, 0,60 доллара за миллион выходных) DeepSeek, по их расчётам, получает 38 долларов выручки на один ускоритель в час.
По подсчётам аналитиков Latent Space, при полной себестоимости от 5 до 8 долларов за карту в час это даёт маржу инференса выше 80%.
Что НЕ вошло в релиз?
Несмотря на заявление DeepSeek о «полностью открытом коде», ключевые компоненты пока не опубликованы. Как признаёт сама компания, система управления KV-кэшем (оперативной памятью модели для контекста разговора) и балансировка нагрузки остаются привязанными к внутренней инфраструктуре DeepSeek.
Это важный нюанс: воспроизвести весь сервис целиком по открытому коду на данный момент нельзя. Движок открыт, но оркестрация на уровне сервиса остаётся задачей пользователя.
Команда vLLM (другой популярный открытый движок инференса) отреагировала конкретно: они воспроизвели тесты и показали, что их скорость декодирования на ускорителях GB200 отстаёт от заявленных результатов DeepInfer всего на 6% при аналогичной конфигурации. Это ставит под вопрос уникальность преимущества DeepSeek именно в скорости генерации.
Российский контекст: что доступно здесь?
| DeepInfer (DeepSeek) | YandexGPT | GigaChat | |
|---|---|---|---|
| Открытый код движка | Да (Apache 2.0) | Нет | Нет |
| Кэширование промптов | До 72 часов | Информация не раскрыта | Информация не раскрыта |
| Доступ из РФ | API DeepSeek доступен, но код требует GPU-кластера | API и веб-интерфейс | API и веб-интерфейс |
| Поддержка Huawei Ascend | Да | Информация не раскрыта | Информация не раскрыта |
Для большинства авторов и маркетологов в России разница практическая: YandexGPT и GigaChat работают через готовый интерфейс и не требуют своего сервера. DeepInfer интересен тем, кто разворачивает собственные решения или хочет понять экономику инференса изнутри.
Как попробовать?
- Откройте репозиторий DeepInfer на GitHub (ссылка в блоге DeepSeek и на странице анонса deepseek_ai).
- Изучите компонент deepseek-recipe: он реализует обработку токенов и совместим с официальным API DeepSeek.
- Для запуска нужен кластер с GPU NVIDIA или Huawei Ascend. Минимальная рекомендуемая конфигурация: восемь ускорителей на одну ноду.
- Если своего кластера нет, используйте API DeepSeek напрямую: модель V4.1 Flash уже работает на этом движке.
Что делать с этим прямо сейчас, по ролям?
Автору Дзена. Если вы используете DeepSeek через API для генерации черновиков или переводов, кэширование промптов до 72 часов означает, что длинный системный промпт (инструкция, задающая стиль и формат) не пересчитывается каждый раз. Это снижает расход токенов и ускоряет ответ при одинаковом промпте.
Маркетологу. Цены DeepSeek на инференс уже были низкими. Теперь, когда экономика движка публична, конкуренты будут вынуждены показывать свои расчёты или снижать цены. Следите за обновлениями тарифов у провайдеров, которых вы используете.
Предпринимателю в РФ. Поддержка Huawei Ascend делает DeepInfer одним из немногих открытых движков, способных работать на доступном в России «железе». Если вы строите собственную инфраструктуру для ИИ, этот релиз стоит изучить.
DeepSeek сделала сильный ход: показала не только код, но и экономику. На мой взгляд, главная ценность релиза не в самом движке, а в том, что впервые провайдер открыто назвал маржу инференса. 80% при полной себестоимости, если эти цифры верны, объясняют, почему DeepSeek может держать такие низкие цены.
Оговорка: 96% попаданий в кэш означают, что экономика DeepSeek построена на повторяющихся запросах. Если ваши задачи уникальны и кэш не помогает, реальная стоимость будет выше. Кроме того, ключевые компоненты (управление кэшем и балансировка) не опубликованы, значит, воспроизвести результат один-в-один пока нельзя.
Что сделать сегодня: если вы работаете с API DeepSeek, проверьте, используете ли вы постоянный системный промпт. Если да, кэширование уже экономит ваши деньги. Если нет, зафиксируйте инструкцию и отправляйте её одинаковой, это снизит расход токенов.
Частые вопросы
DeepInfer можно запустить на обычном компьютере?
Нет. Движок рассчитан на кластеры ускорителей: минимум восемь GPU NVIDIA или Huawei Ascend на одну ноду. Для домашнего использования подойдёт API DeepSeek, где DeepInfer уже работает на стороне сервера.
Чем DeepInfer отличается от vLLM?
DeepInfer построен на основе vLLM (и использует наработки SGLang и TensorRT-LLM), но добавляет кэширование промптов до 72 часов, раздельное масштабирование стадий и поддержку Huawei Ascend. Команда vLLM при этом показала, что по скорости декодирования разрыв составляет около 6% на аналогичном оборудовании, по данным тестов самой vLLM.
Это действительно полностью открытый код?
Не совсем. Движок и обработка токенов открыты под лицензией Apache 2.0. Но система управления KV-кэшем и балансировка нагрузки пока не выложены, DeepSeek объясняет это привязкой к внутренней инфраструктуре. Компания заявила, что будущие оптимизации будут публиковаться в том же репозитории, но сроков не назвала.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Tenex платит ИИ-инженерам за результат, а не за часы: как это работает для Fortune 2000
Почему это важно Tenex показывает работающую модель, где ИИ-инженерам платят за результат, а не за часы, и где каждое проектное решение хранится в репозитории…
SF Compute превращает дата-центры в биржу: GPU-часы можно покупать и перепродавать как нефть
Почему это важно Вычислительные мощности для нейросетей впервые становятся биржевым товаром: их можно покупать, продавать и перепродавать по контрактам, как…
OpenAI поймала шпиона собственным ChatGPT: прокуроры назвали дело угрозой нацбезопасности
OpenAI второго июня подтвердила, что использовала собственный ChatGPT для расследования внутреннего инцидента с прослушкой, после того как в переговорной…
Комментарии