
AI агенты как «тень» сотрудника: пошаговый запуск сбора требований без утечки данных
ИИ-агенты (программы, которые сами выполняют цепочку действий по заданной цели) в российских компаниях чаще всего внедряют «сверху», заменяя людей целиком, и 4 июня 2025 года это по-прежнему главная ошибка, которую можно обойти, если начать с автоматизации одного конкретного процесса.
Локальные ИИ-агенты в закрытом контуре компании не отправляют данные наружу и решают самую болезненную задачу: собирают, проверяют и оформляют требования к продукту до начала разработки, а не после, когда переделывать дорого.
Идея, которую разбираем, принадлежит практику, работающему с агентами внутри финансовых организаций. Суть простая: не заменять сотрудников, а дать каждому «тень», агента, который берёт на себя рутину сбора и проверки информации. Подход вырос из наблюдения, что большие языковые модели (LLM, нейросети, генерирующие текст) имеют фундаментальное ограничение: они не знают, чего они не знают. Значит, стратегом остаётся человек, а агент работает его руками.
Что понадобится?
- Локальная LLM-модель внутри корпоративного контура. Подойдут открытые модели (модели с открытыми весами, которые можно развернуть на своём сервере). В России доступны, например, GigaChat от Сбера или YandexGPT, а также опенсорс-решения, которые разворачиваются на собственном железе.
- Корпоративная база знаний: Confluence, внутренняя вики или любое хранилище документации, к которому агент получит доступ через RAG (Retrieval-Augmented Generation, метод, при котором модель сначала ищет нужный фрагмент в базе, а потом формирует ответ на его основе).
- Владелец процесса: живой человек, который понимает, какие требования нужны и зачем. Без него агент генерирует хаос, а не пользу.
- Источники данных: переписки в мессенджерах, записи встреч, тикеты. Агент будет из них извлекать факты.
- Время на настройку: от одного до трёх рабочих дней на первый рабочий прототип, если модель уже развёрнута.
Пошаговая инструкция: запуск агента-опросника для сбора требований
-
Определите один процесс, а не десять. Начните с конкретной боли. Например: «требования к новой функции приходят устно, теряются и дублируются». Автор исходного подхода прямо предупреждает: слепое следование хайпу приводит не к улучшению, а к увеличению технического долга.
-
Разверните агента-опросника. Это ИИ-агент, который задаёт уточняющие вопросы заказчику по шаблону. Системный промпт (начальная инструкция, задающая роль и границы поведения агента) может выглядеть так:
Ты — аналитик требований. Твоя задача — собрать полное описание функции.
Задавай вопросы по одному. Не переходи к следующему, пока не получишь
конкретный ответ. Если ответ расплывчатый, переформулируй вопрос проще.
Обязательные поля: цель функции, кто пользователь, критерии готовности,
ограничения по срокам, зависимости от других систем.
Не выдумывай ответы за собеседника.
-
Подключите извлечение из переписок и встреч. Настройте второго агента, который получает расшифровки звонков и переписку, а затем извлекает из них факты, относящиеся к требованиям. Он не заменяет опросник, а дополняет его: люди часто проговаривают важное устно, но не фиксируют.
-
Добавьте RAG по внутренней базе. Агент ищет в Confluence или вики похожие требования, которые уже были реализованы. Это снижает дублирование: прежде чем оформить новое требование, система покажет, что похожее уже существует.
-
Запустите агента-контролёра. Его задача: проверить итоговый документ требований на полноту и противоречия. Он сравнивает собранное опросником с тем, что извлечено из переписок и базы знаний. Если находит расхождения, возвращает на доработку.
-
Зафиксируйте «память процесса». Каждый цикл сбора требований сохраняется. Это борьба с семантическим дрейфом (постепенным искажением смысла терминов, когда разные люди и агенты начинают понимать одно и то же слово по-разному). Без фиксации через пять итераций агент и команда будут говорить на разных языках.
-
Проверяйте результат вручную. Владелец процесса читает итоговые требования и корректирует. Агент остаётся инструментом, стратег остаётся человеком. Как формулирует автор подхода: «ИИ-агент даёт лопату и даже может копать, но не знает, что нужно выкопать именно вам».
Ситуация: продуктовая команда в финтех-компании получает требования от бизнеса устно, на созвонах. Аналитик тратит два-три дня на оформление, половина деталей теряется.
Что сделали: развернули локальную открытую модель, настроили агента-опросника с системным промптом выше, подключили расшифровку записей созвонов и RAG по Confluence.
Что получили: требования стали появляться до начала разработки, а не параллельно с ней. Дублирование снизилось, потому что агент находил похожие реализации в базе. Аналитик переключился с набивки документов на проверку и приоритизацию, то есть на работу, где нужен человеческий опыт.
Галлюцинации (когда модель уверенно выдумывает то, чего не было) никуда не делись. Если агент-опросник не получил ответ, он может сочинить его сам. Контролёр частично ловит это, но ручная проверка владельцем обязательна.
Контекстное окно (объём текста, который модель удерживает за один раз) ограничено. Если переписка за месяц не помещается в окно, агент потеряет начало разговора. Разбивайте данные на порции.
Мусор на входе даёт мусор на выходе. Если в Confluence хаос, RAG вернёт хаос. Перед запуском агента наведите минимальный порядок в базе знаний.
Попытка автоматизировать всё сразу. Один агент на один процесс. Автор подхода подчёркивает: команда «исправь» без понимания, что именно исправлять, генерирует хаос быстрее, чем без ИИ.
Что делать с этим прямо сейчас?
Автору Дзена и копирайтеру. Принцип агента-опросника работает и для контента: настройте промпт, который задаёт вам же уточняющие вопросы перед написанием статьи. Это дешёвая версия «агента требований» для одного человека. Доступно через GigaChat или YandexGPT прямо сейчас.
Маркетологу. Сбор требований от заказчика к рекламной кампании страдает теми же болезнями: устные брифы, потерянные детали, дублирование. Агент-опросник с фиксированным шаблоном вопросов экономит не на людях, а на переделках.
Предпринимателю в РФ. Локальный контур критичен, если вы работаете с персональными данными или финансовой информацией. Облачные западные модели несут регуляторные риски. Открытые модели, развёрнутые на своём сервере, и российские решения (GigaChat, YandexGPT) позволяют начать без отправки данных за периметр.
Мне близок подход автора: ИИ-агенты сильнее всего не там, где они заменяют человека, а там, где они снимают с него рутину, оставляя решения за ним. По моим наблюдениям, попытки «заменить отдел» агентами в российских компаниях пока заканчиваются ростом технического долга, а не его сокращением. Начинать с одного процесса и одного владельца, который понимает, зачем ему агент, это рабочая стратегия. Честная оговорка: всё описанное требует как минимум развёрнутой LLM и человека, способного написать системный промпт. Если в команде нет ни того, ни другого, ИИ-агенты пока не ваш инструмент, и это нормально.
Хотите научиться писать системные промпты для агентов?
В dzen.guru мы разбираем промпт-инжиниринг (искусство формулировать задачи для нейросетей) на практике, с примерами для авторов и маркетологов.
ПопробоватьГлавное, что стоит запомнить: ИИ-агент не стратег, а тень стратега. Тень работает без перерывов, но не эволюционирует без человека. Начните с одного процесса, одного агента и одного владельца. Если после первой недели требования стали появляться до разработки, а не после, значит, вы на верном пути.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
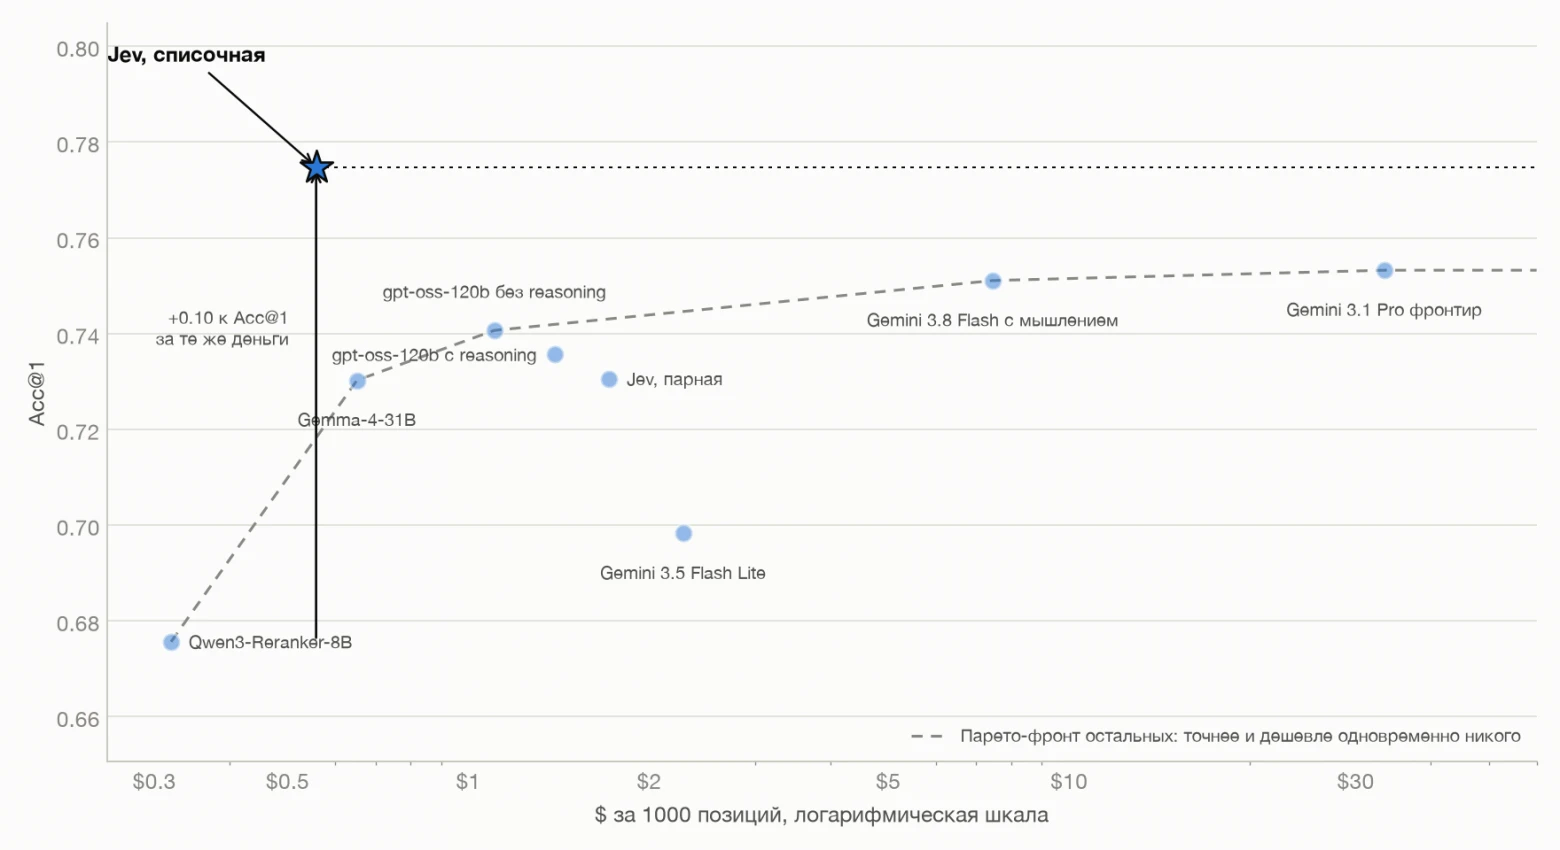
Реранкер нейросети Jev обошёл модели в 60 раз дороже: 78% точности на 78 000 кодов
Классификация товаров по справочнику с десятками тысяч кодов отнимает массу времени и денег, если поручать выбор финального кода генеративной модели, и Jev от…
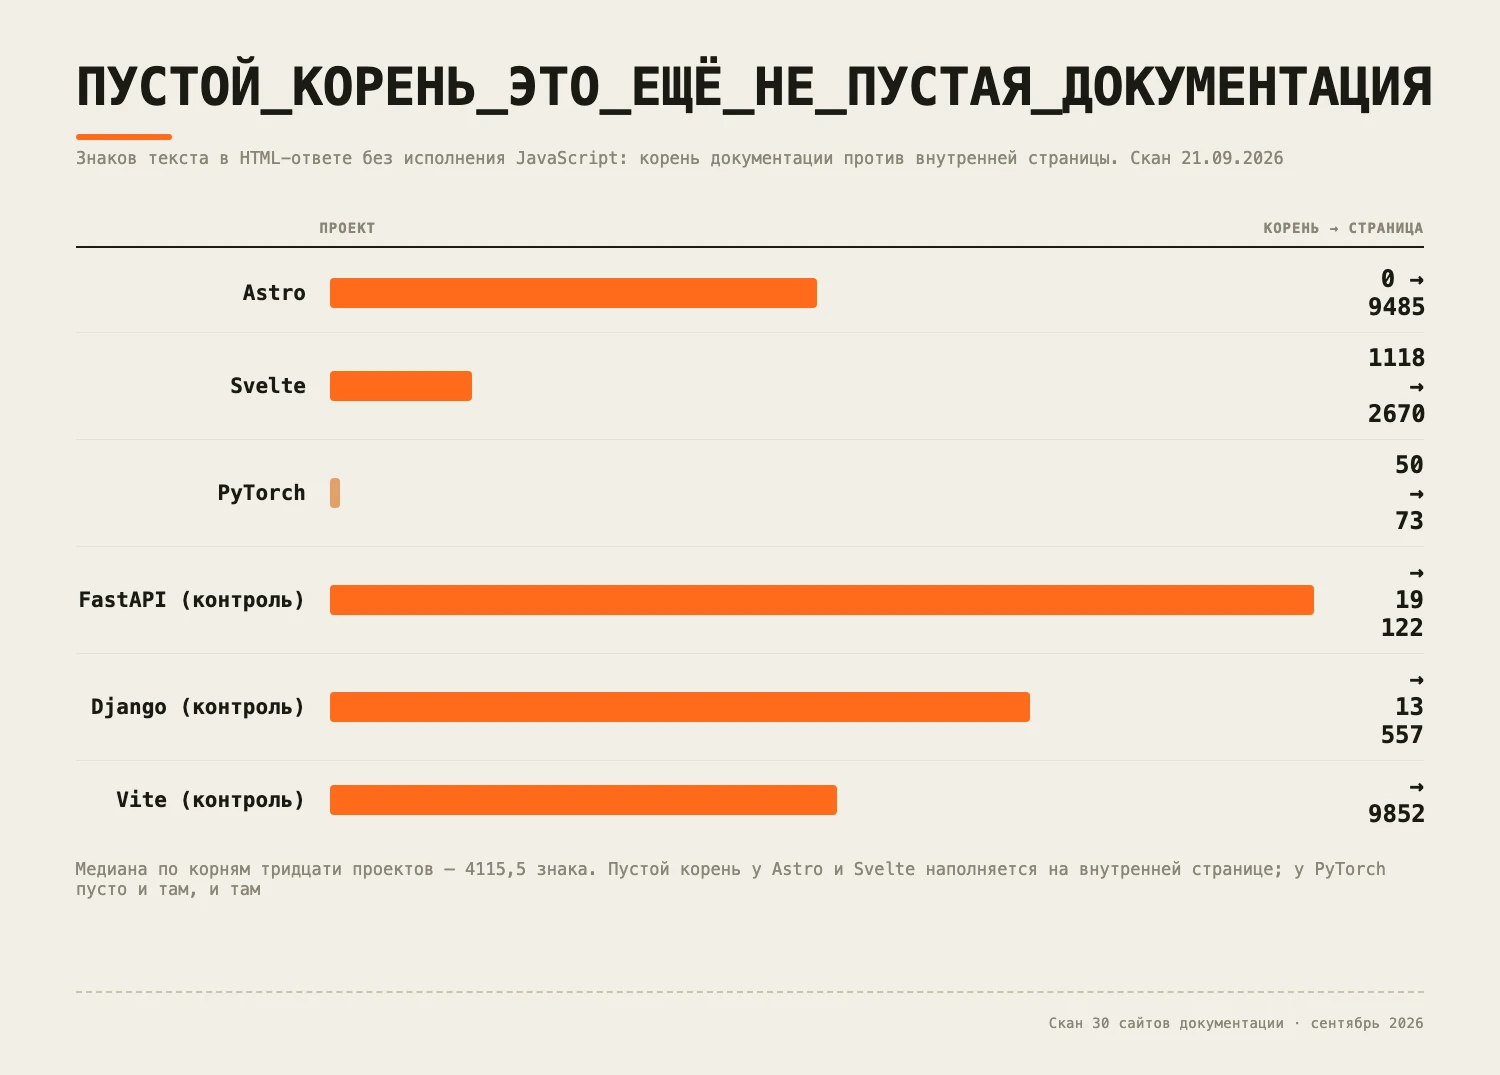
84% разработчиков используют ИИ для программирования, но он рекомендует одни и те же библиотеки
Корпус документации решает, увидит ли ИИ вашу библиотеку вообще. Почему это важно По данным Stack Overflow Developer Survey 2025, 84% разработчиков используют…
LLM даёт лишь 2% результата разработки: почему 98% зависят от «обвязки»
Большие языковые модели (LLM, нейросети, которые генерируют текст и код по текстовому запросу) всё чаще появляются в арсенале разработчиков, но реальный…
Комментарии