
84% разработчиков используют ИИ для программирования, но он рекомендует одни и те же библиотеки
Корпус документации решает, увидит ли ИИ вашу библиотеку вообще.
По данным Stack Overflow Developer Survey 2025, 84% разработчиков используют или планируют использовать ИИ для программирования, а 51% профессионалов делают это ежедневно. Если документация вашего проекта невидима для краулеров (программ-сборщиков, которые скачивают страницы для обучения моделей), лучший ИИ для программирования попросту не порекомендует вашу библиотеку, какой бы качественный код за ней ни стоял.
Автор оригинального исследования столкнулся с конкретной ситуацией: он попросил ИИ-ассистента подсказать библиотеку под задачу, которую его собственный проект решает лучше конкурентов. Ассистент назвал три более крупных альтернативы и ни разу не упомянул его инструмент. Вместо того чтобы обвинять модель в предвзятости, разработчик проверил три технические гипотезы на 30 сайтах документации популярных Python- и JS-библиотек. Результаты показали, что проблема не там, где казалось на первый взгляд.
Почему документация важнее, чем промпт к модели?
Прогон моделей и проверку доступности сайта автор развёл намеренно. Ответ модели зависит от десятков факторов. А доступность страницы для краулера это конкретный технический факт, который можно измерить одним HTTP-запросом без доступа к весам модели (внутренним параметрам нейросети, определяющим её ответы).
Масштаб проблемы подтверждают три независимых опроса:
- Stack Overflow Developer Survey 2025 (49 000+ респондентов, 177 стран): 84% разработчиков используют или планируют использовать ИИ-инструменты
- JetBrains State of Developer Ecosystem 2025 (24 534 респондента): 85% регулярно применяют ИИ-инструменты, 62% полагаются хотя бы на один выделенный ИИ-ассистент для кода
- GitHub Octoverse 2025: 80% новых разработчиков начинают пользоваться Copilot в первую же неделю
Решение о том, какую библиотеку взять, массово принимает не разработчик на форуме, а ИИ для программирования, отвечающий по накопленным паттернам обучения. Если эти паттерны смещены в пользу уже раскрученных проектов, нишевые инструменты не пробьются, не потому что хуже, а потому что модель их не видит.
При этом по данным того же Stack Overflow доверие к точности ИИ-советов упало с 40% в 2024 году до 29% в 2025-м. Топ-жалоба (66% респондентов): «почти правильно, но не совсем». Разработчики пользуются инструментом чаще, но верят ему меньше.
Что понадобится
- Python 3.x со стандартной библиотекой (никаких внешних зависимостей)
- Доступ к интернету для HTTP-запросов к сайтам документации
- Терминал или любая среда для запуска скриптов
- Список доменов документации ваших проектов и конкурентов
- Примерно 15 минут на настройку и запуск, плюс 5 минут на анализ результатов
Как проверить доступность документации для ИИ-краулеров?
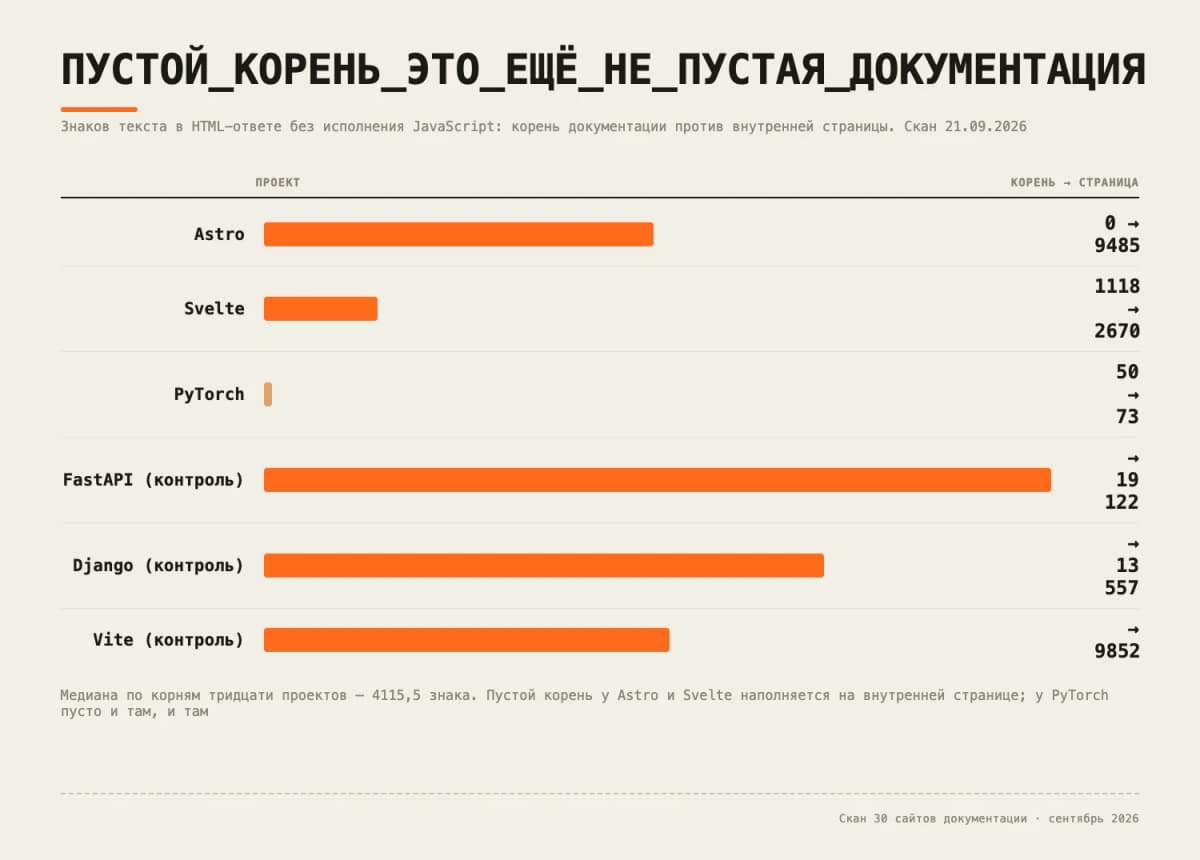
Автор исследования проверял три вещи для каждого из 30 доменов: отдаёт ли сайт файлы llms.txt и llms-full.txt (специальные файлы, которые сейчас советуют размещать для удобства ИИ-краулеров), блокирует ли robots.txt (файл с правилами для ботов) пятерых распространённых ИИ-ботов, и сколько текста реально лежит в HTML главной страницы без исполнения JavaScript.
- Создайте скрипт для загрузки страниц. Первый блок задаёт заголовок запроса, список ботов и функцию загрузки. Скрипт не использует внешних библиотек:
#!/usr/bin/env python3
import json, re, sys, urllib.request, urllib.error

UA = "Mozilla/5.0 (compatible; llms-txt-probe/1.0)"
BOTS = ["GPTBot", "ClaudeBot", "PerplexityBot",
        "OAI-SearchBot", "YandexBot"]

def fetch(url, timeout=12):
    req = urllib.request.Request(url,
          headers={"User-Agent": UA})
    try:
        with urllib.request.urlopen(req,
             timeout=timeout) as r:
            return r.status, r.read().decode(
                   "utf-8", "replace")
    except urllib.error.HTTPError as e:
        return e.code, ""
    except Exception as e:
        return None, str(e)
Функция fetch при сетевой ошибке возвращает None вместо кода ответа. Это позволяет отличить недоступный файл от файла, который открылся и разрешил доступ.
- Добавьте разбор
robots.txt. Скрипт ищет группу правил для конкретного бота. Если её нет, берёт общую группуUser-agent: *и проверяет наличиеDisallow: /:
def robots_allows(robots_txt, bot):
    if not robots_txt:
        return None
    groups, current = {}, []
    for line in robots_txt.splitlines():
        line = line.split("#")[0].strip()
        if not line:
            continue
        k, _, v = line.partition(":")
        k, v = k.strip().lower(), v.strip()
        if k == "user-agent":
            current = [v]
            groups.setdefault(v.lower(), [])
        elif k in ("disallow", "allow") and current:
            groups.setdefault(current[0].lower(),
                  []).append((k, v))
    rules = groups.get(bot.lower())
    if rules is None:
        rules = groups.get("*")
    if rules is None:
        return True
    return not any(
        k == "disallow" and v == "/"
        for k, v in rules
    )
Возврат None означает отдельный случай: файл robots.txt вообще не открылся (404 или некорректный редирект).
-
Добавьте проверку
llms.txt. Для каждого домена скрипт запрашивает/llms.txtи/llms-full.txt, фиксирует код ответа и размер файла в байтах. -
Добавьте замер текста в HTML. Скрипт скачивает главную страницу документации, вырезает теги
<script>и<style>, и считает оставшийся текст. Если текста меньше определённого порога, страница фактически пуста для краулера, всё содержимое рендерится через JavaScript на стороне клиента. -
Запустите скрипт на вашем списке доменов. Подставьте домены своих проектов и конкурентов. Сравните три показателя: блокировка ботов, наличие
llms.txt, объём текста без JavaScript. -
Проанализируйте результаты. Автор получил на 30 доменах следующее:
robots.txtне блокировал ИИ-ботов ни на одном из 30 доменов, ни по адресу документации, ни в корнеllms.txtнашёлся у 11 проектов из 30, но независимые логи показали, что этот файл почти никто не запрашивает- Пустая для краулера страница обнаружилась у трёх проектов, после проверки внутренних страниц остался один
Среди 30 проверенных были FastAPI, Pydantic, LangChain, Polars, Ruff, Django, Flask, NumPy, pandas, Requests, httpx, SQLAlchemy, Celery, Pytest, Scikit-learn, PyTorch, Hugging Face Transformers, Streamlit, Typer, Rich, Vite, Svelte, Next.js, Tailwind CSS, Prisma, Supabase, Astro, Bun, Deno, Zod. Намеренно смешаны старые Python-библиотеки и более новые JS/TS-инструменты.
Допустим, вы поддерживаете Python-библиотеку для парсинга данных. Запускаете скрипт на домене своей документации и видите: robots.txt разрешает всех ботов (ожидаемо, так было у всех 30 проектов), llms.txt отсутствует, а главная страница отдаёт 200 байт текста без JavaScript, потому что вся документация рендерится через SPA-фреймворк (одностраничное приложение). Краулер видит пустую страницу. Вы добавляете серверный рендеринг или статическую генерацию, объём текста вырастает до десятков килобайт. Теперь ваш контент физически доступен для сбора.
Не переоценивайте llms.txt. Из 30 проектов файл был у 11, а по независимым логам его почти никто не запрашивает. Создание llms.txt не повредит, но и не станет решающим фактором прямо сейчас.
Не путайте доступность и рекомендацию. Даже если краулер прочитал вашу документацию, модель учитывает десятки факторов. Доступность это необходимое условие, не достаточное.
Не смешивайте измерения. Автор специально не прогонял модели в том же эксперименте. Прогон модели и проверка доступности сайта это разные величины. Смешаете их, и не поймёте, что именно измерили.
Не забывайте про внутренние страницы. Главная может быть пуста для краулера, а внутренние страницы доступны. Проверяйте не только корень, но и конкретные разделы API-документации.
Что делать с этим прямо сейчас, по ролям?
Разработчику опенсорс-проекта. Запустите скрипт из статьи на домене своей документации. Если главная страница отдаёт минимум текста без JavaScript, это ваш приоритет номер один: переходите на статическую генерацию или серверный рендеринг (SSR, когда сервер собирает HTML до отправки браузеру). Файл llms.txt добавьте параллельно, затрат почти ноль.
Автору Дзена и копирайтеру. Если пишете технические обзоры инструментов, проверяйте, видит ли ИИ для программирования то, о чём вы пишете. Спросите ассистента кода про библиотеку до публикации: если модель её не знает, укажите это в тексте. Читатель оценит честность, а ваш материал станет тем самым источником, которого модели не хватало.
Предпринимателю в РФ и СНГ. Если ваш продукт имеет API или SDK с публичной документацией, все те же правила работают. Из доступных в России инструментов для проверки подходит YandexBot (он в списке пяти ботов скрипта). Проверьте, видит ли бот Яндекса вашу документацию, это бесплатная диагностика.
Результаты исследования, по моему опыту, объясняют то, что я наблюдаю в тестах ИИ-ассистентов регулярно: модели рекомендуют одни и те же крупные фреймворки не потому что «проплачены», а потому что на них банально больше доступного текста в обучающих данных. Создание llms.txt пока выглядит скорее как сигнал доброй воли, чем как рабочий канал: по логам его почти не запрашивают. А вот пустая HTML-страница, которая рендерится только через JavaScript, это реальная стена. Если у вас проект с документацией на каком-нибудь SPA-фреймворке, начните с SSR: это измеримый шаг с конкретным результатом. Лучший ИИ для программирования не станет рекомендовать то, чего физически не прочитал.
Проверьте свою документацию
Запустите скрипт на домене своего проекта и сравните результаты с 30 библиотеками из исследования. А для создания контента, который ИИ точно прочитает, используйте инструменты dzen.guru.
Попробовать dzen.guruДанные о том, что ИИ-ассистенты систематически предпочитают крупные библиотеки, перестают быть жалобой и становятся измеримой технической проблемой с конкретным чек-листом: серверный рендеринг документации, llms.txt на всякий случай, регулярная проверка видимости для краулеров. Тот, кто сделает это первым среди конкурентов по нише, получит преимущество, пока остальные продолжают спорить о предвзятости моделей.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
AI генератор кода обрушил стоимость разработки, но взорвал расходы на поддержку
Текст построен строго по фактам из оригинала. Оригинал представляет собой не пресс-релиз о запуске продукта, а авторскую аналитику без привязки к конкретному…
Разработка игр стала предсказуемой: калькулятор покажет стоимость сервера 2D MMO до запуска
Компания The Mana World представила калькулятор серверной нагрузки для 2D MMO RPG, который показывает стоимость каждого решения разработчика до запуска игры, и…
Искусственный интеллект в магазинах не заменит продавцов: создатель Apple Store объяснил почему
Рон Джонсон, создатель сети Apple Store и бывший глава розницы Apple, в интервью TechCrunch заявил, что искусственный интеллект в магазинах не заменит…
Комментарии