
LLM даёт лишь 2% результата разработки: почему 98% зависят от «обвязки»
Большие языковые модели (LLM, нейросети, которые генерируют текст и код по текстовому запросу) всё чаще появляются в арсенале разработчиков, но реальный выигрыш приносит не сама модель, а выстроенный вокруг неё процесс, и в российских условиях этот процесс устроен сложнее, чем кажется.
По оценке экспертов «Диасофт» и участников отраслевой дискуссии, сама LLM даёт около 2% результата корпоративной разработки, остальные 98% обеспечивает «обвязка»: инструкции, ИИ-агенты (программы, которые сами выполняют цепочку действий), контрольные точки, люди и процессы. Без этой обвязки код не пройдёт сертификацию ФСТЭК и не попадёт в реестр российского ПО.
Тезис «98 против 2» озвучил Александр Сахаров, директор по работе с технологическими партнерами и член правления «Диасофт», ссылаясь на доклад Кирилла Меньшова на конференции ЦИПР (AI Disrupts SDLC), данные Anthropic, консалтинговых компаний и годовые наблюдения Сбербанка за своими командами. Суть: модель подобна трактору, она мощная, но без водителя, механика, агронома и гаража наломает дров. В американской терминологии процессную обвязку называют harness, Сбербанк использует термин integrated development platform, «Диасофт» говорит об экосистеме разработки (development ecosystem).
Почему голая LLM не справляется с корпоративным кодом?
Для «свадебного сайта» хватит одного промпта (текстовой команды для нейросети). Но у компаний из топ-1000, по словам Сахарова, требования другие:
- Документирование по стандартам.
- Контроль информационной безопасности.
- Сертификация ФСТЭК отдельных подсистем (например, управления ролевым доступом).
- Постановка продукта в реестр российского ПО.
- Прохождение ГОСТа по безопасной разработке.
Если отдать задачу голой LLM, она напишет подсистему с нуля, вместо того чтобы взять готовый сертифицированный модуль. Чтобы этого не случилось, нужны сотни инструкций, сгруппированных по двум десяткам направлений: информационная безопасность, масштабируемость, работа с данными и требованиями, архитектура, сборка, интеграционные, нагрузочные и регрессионные тесты, обратная совместимость, контроль юнит-тестов.
Факт, который легко упустить в разговоре об LLM-разработке: токены (единицы текста, за которые платит разработчик при каждом обращении к модели) расходуются мгновенно. По словам Сахарова, без ограничений модель способна по ходу дела создать СУБД, переписать операционную систему и потратить бюджет, а вернуть токены уже нельзя.
Что понадобится
- Доступ к LLM. Закрытая модель (доступная только через API провайдера: ChatGPT, Claude, GigaChat) или открытая модель с открытыми весами (когда параметры нейросети можно скачать и запустить на своём сервере) для локального развёртывания.
- Среда разработки с ИИ-ассистентом. Copilot, Cursor, Cline или аналог. В России доступны GigaCode от Сбера, а также средства внутри экосистемы «Диасофт» Digital Q.
- Набор инструкций (системных промптов). Текстовые правила, которые задают модели рамки: какие модули брать готовыми, какие стандарты соблюдать, что запрещено генерировать с нуля.
- Контрольные точки (квалити-гейты). Автоматические или ручные проверки на каждом этапе: безопасность, соответствие ГОСТу, архитектурная целостность.
- Команда. Аналитики, архитекторы, тестировщики, DevOps-инженеры. LLM не заменяет их, а работает внутри их процесса.
- Время. Полный перевод разработки на агентную схему у «Диасофт» занял шесть месяцев силами команды из двадцати человек.
Пошаговая инструкция: как встроить LLM в корпоративную разработку
- Опишите ограничения до первого промпта. Составьте перечень модулей, которые модель не должна генерировать с нуля (сертифицированные компоненты, модули из реестра ПО). Оформите это как системный промпт (постоянную инструкцию, которая действует при каждом обращении к модели):
Системный промпт (фрагмент):
Подсистему управления ролевым доступом НЕ пиши с нуля.
Используй модуль access-control из репозитория /certified/fstec/.
Все изменения в модуле безопасности требуют ручного ревью архитектора.
-
Сгруппируйте инструкции по направлениям. По опыту «Диасофт», направлений около двадцати: информационная безопасность, архитектура, тестирование, работа с бизнес-требованиями и так далее. Каждое направление получает свой набор правил.
-
Выстройте цепочку ИИ-агентов. Первый агент принимает требования и передаёт задачу дальше. Следующие агенты уточняют бизнес-процессы, прорабатывают безопасность, создают тестовые сценарии, прогоняют через DevOps (автоматизированный конвейер сборки, тестирования и доставки кода). На каждом переходе стоит квалити-гейт.
-
Поставьте контроль расхода токенов. Ограничьте бюджет на один запуск цепочки, логируйте, сколько токенов съел каждый шаг. Без лимита модель может потратить ресурсы на ненужные действия.
-
Решите вопрос вендорной зависимости. Тим Зинин, управляющий партнёр компании «Зинин, Штурбин и партнёры», предупреждает: готовый харнес (обвязка) от внешнего поставщика часто не позволяет выполнить нужные действия, модель может переключиться с мощной версии на упрощённую без предупреждения. Для корпоративных задач в России, где доступ к ряду западных сервисов ограничен, это не теория, а ежедневная проблема. Рассмотрите опенсорсные (с открытым кодом) инструменты с возможностью доработки или отечественные платформы.
-
Проведите пилот на одном проекте. Не переводите всю разработку разом. Возьмите один набор требований, прогоните через цепочку агентов, замерьте результат: соответствие ГОСТу, количество ручных правок, расход токенов.
В «Диасофт» набор бизнес-требований передаётся первому агенту. Тот запускает около двадцати других: одни уточняют требования и бизнес-процессы, другие прорабатывают подсистему безопасности, третьи создают тестовые сценарии. На каждом этапе агенты общаются с живыми аналитиками, архитекторами и тестировщиками. Квалити-гейтами тоже управляют агенты. На выходе получается не просто работающий код, а код, пригодный для сертификации и размещения у заказчиков уровня министерств и закрытых ведомств. Всего задействовано порядка сорока агентов.
Отдать задачу «голой» модели без инструкций. LLM перепишет с нуля то, что нужно взять готовым. Код будет рабочим, но не пройдёт сертификацию ФСТЭК и не встанет в реестр российского ПО.
Игнорировать расход токенов. Без лимитов модель способна создать целую базу данных или переписать ОС «попутно». Токены тратятся, результат выбрасывается.
Надеяться на ускорение без перестройки процесса. Как отмечает Сахаров, компании закупают Copilot, Cursor и Claude Code «вагонами», но ускорение команд не фиксируется. Причина: инструмент без обвязки не встраивается в реальный SDLC (жизненный цикл разработки ПО).
Полагаться на чужой харнес без проверки. По словам Тима Зинина, внешний поставщик может ограничить функции или незаметно подменить модель на упрощённую версию.
Что делать с этим прямо сейчас, по ролям
Разработчику или тимлиду. Начните не с выбора модели, а с описания ограничений: какие модули нельзя генерировать, какие стандарты обязательны. Этот список инструкций и есть ядро LLM-разработки в корпоративном контексте.
Руководителю или предпринимателю в РФ. Если ваш продукт должен соответствовать ГОСТам, попасть в реестр ПО или пройти сертификацию ФСТЭК, закладывайте бюджет не на модель, а на обвязку. По опыту «Диасофт», это шесть месяцев работы команды из двадцати человек.
Автору Дзена или маркетологу. Принцип «2% модель, 98% обвязка» работает и для контента. Нейросеть выдаёт черновик, но без редполитики, фактчека, стилевых инструкций и ручного контроля результат непригоден для публикации. LLM-разработка контента устроена по тем же правилам, что и LLM-разработка кода.
Цифра «2% модель, 98% обвязка» может показаться провокацией, но по моим наблюдениям она ближе к правде, чем маркетинговые обещания вендоров. Я регулярно тестирую нейросети для контент-задач и каждый раз убеждаюсь: без детального системного промпта, без контрольных точек и без живого ревью модель выдаёт гладкий, но непригодный результат. В России к этому добавляется регуляторный слой, которого нет у западных коллег: ФСТЭК, ГОСТы, реестр ПО. Это не бюрократия ради бюрократии, а реальные требования заказчиков уровня госструктур и банков. Если вы только начинаете встраивать LLM в работу, потратьте первую неделю не на промпты, а на описание того, чего модели делать нельзя. Это сэкономит и токены, и нервы.
Главный вывод прост и неудобен: покупка ИИ-ассистента без процесса вокруг него это покупка трактора без поля, водителя и дороги до участка. Начните с обвязки, модель подождёт.
Попробуйте AI-ассистент dzen.guru для авторов
Системные промпты, контроль качества и стилевые инструкции уже встроены в процесс. Протестируйте, как работает «обвязка» на практике.
Попробовать бесплатно
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
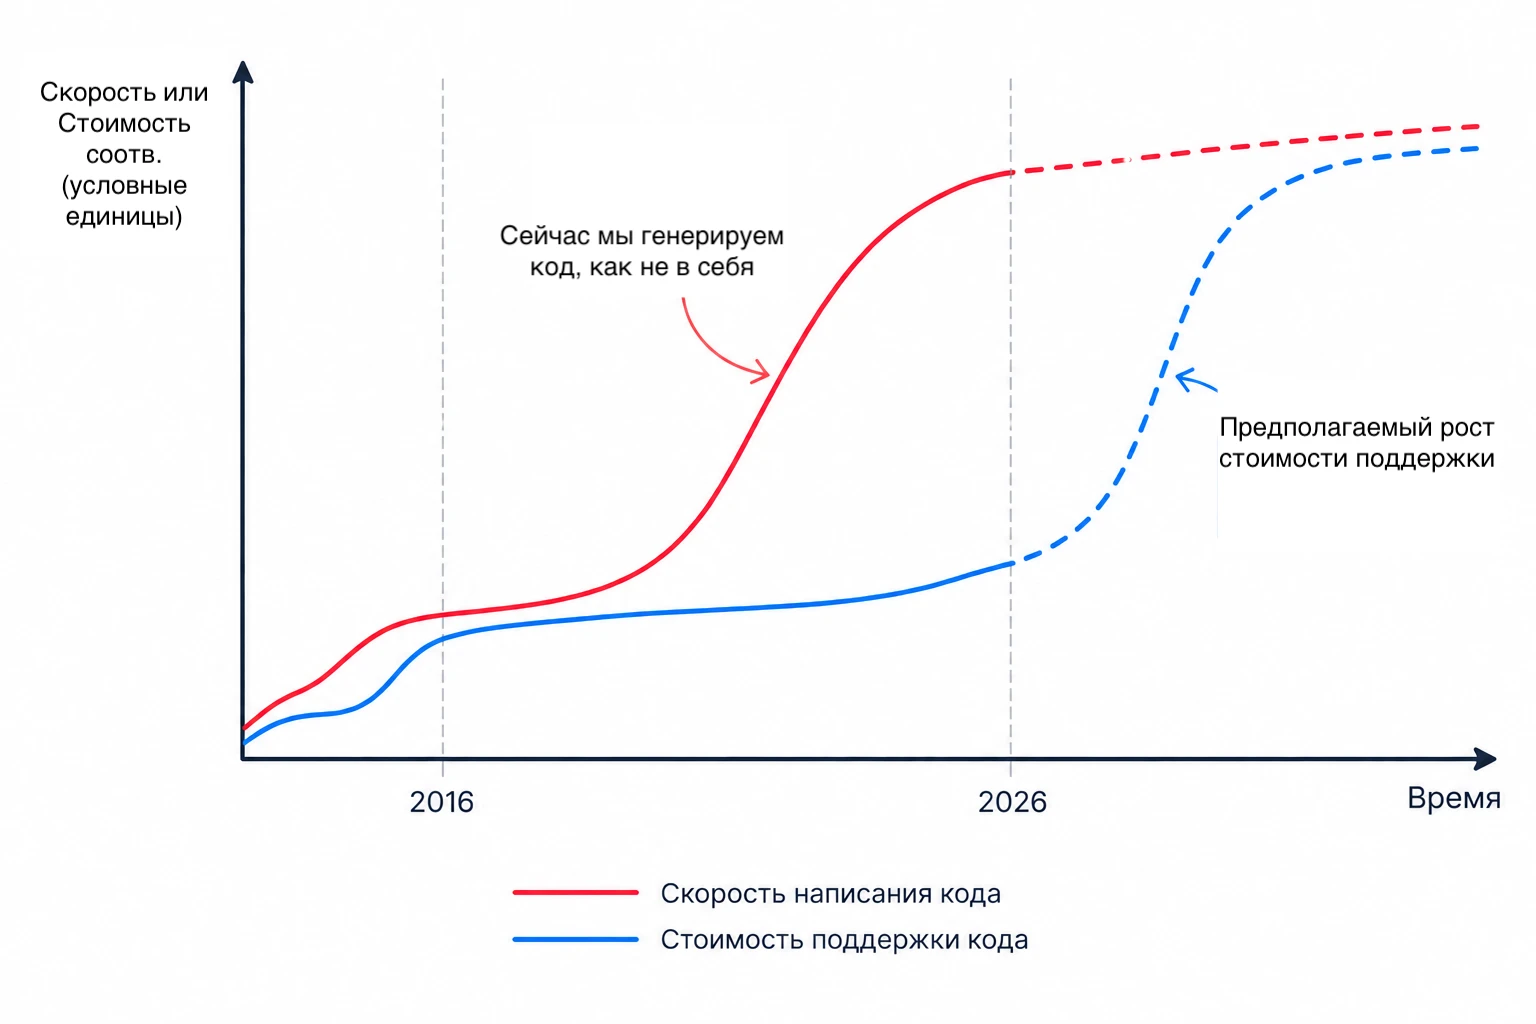
AI генератор кода обрушил стоимость разработки, но взорвал расходы на поддержку
Текст построен строго по фактам из оригинала. Оригинал представляет собой не пресс-релиз о запуске продукта, а авторскую аналитику без привязки к конкретному…
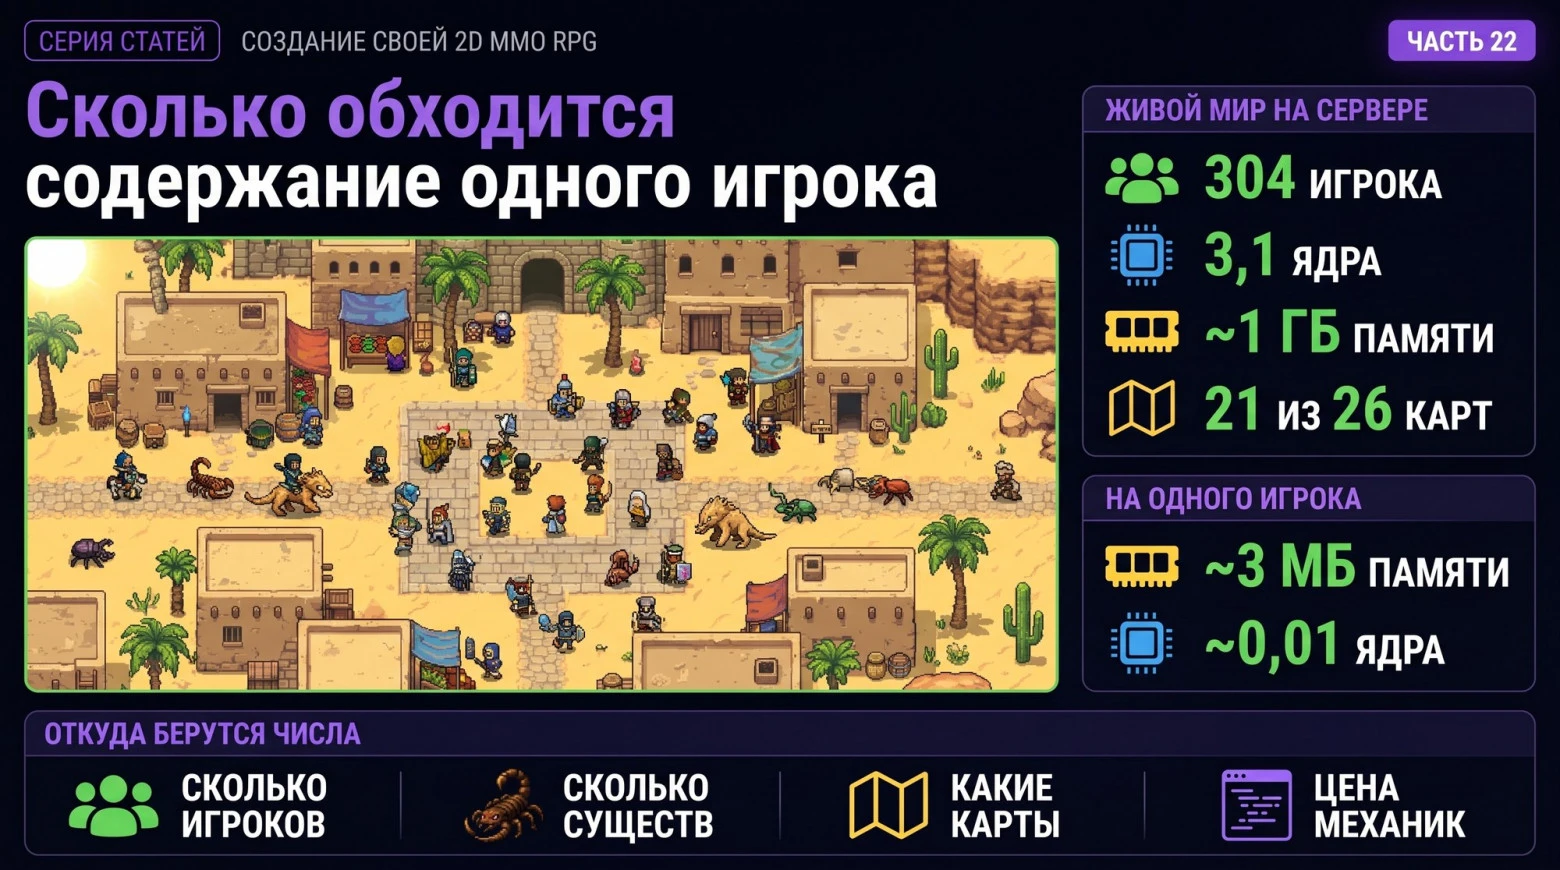
Разработка игр стала предсказуемой: калькулятор покажет стоимость сервера 2D MMO до запуска
Компания The Mana World представила калькулятор серверной нагрузки для 2D MMO RPG, который показывает стоимость каждого решения разработчика до запуска игры, и…
Искусственный интеллект в магазинах не заменит продавцов: создатель Apple Store объяснил почему
Рон Джонсон, создатель сети Apple Store и бывший глава розницы Apple, в интервью TechCrunch заявил, что искусственный интеллект в магазинах не заменит…
Комментарии