
Реранкер нейросети Jev обошёл модели в 60 раз дороже: 78% точности на 78 000 кодов
Классификация товаров по справочнику с десятками тысяч кодов отнимает массу времени и денег, если поручать выбор финального кода генеративной модели, и Jev от TypeSafe позволяет заменить этот шаг вероятностным реранкером нейросети, который не генерирует текст, а сразу возвращает распределение по вариантам.
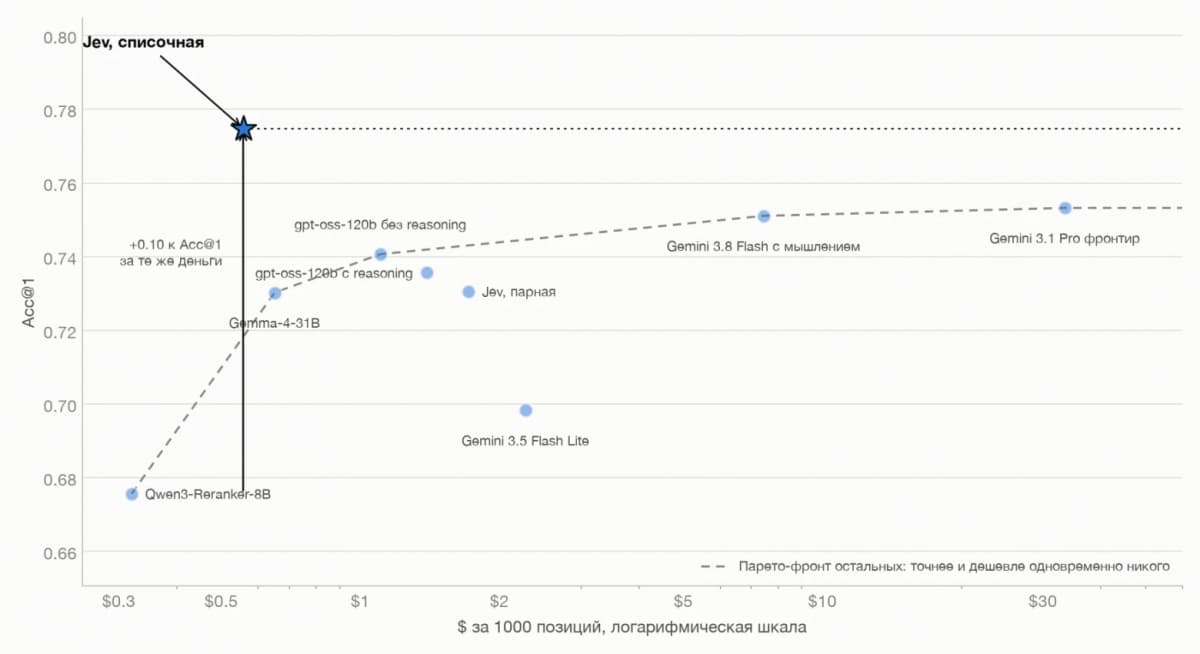
Реранкер нейросети Jev показал лучшую точность среди всех участников сравнения на реальных госзакупках, включая модели, которые стоят в 60 раз дороже, и при этом работает в 4,5 раза быстрее генеративной модели без режима рассуждений и в 12 раз быстрее модели с рассуждениями.
Задача возникла в практике классификации казахстанских госзакупок по справочнику ОКТРУ (классификатор товаров, работ и услуг Казахстана, 77 772 листовых кода). Стандартная схема «поиск плюс реранк» отбирает 30 кандидатов гибридным поиском, а затем генеративная модель выбирает один. Именно второй шаг съедает почти всё время и почти все деньги. Автор бенчмарка проверил, можно ли отдать его модели, которая не генерирует текст, а возвращает вероятности. Результаты сравнения на 928 позициях из реальных техспецификаций опубликованы с методикой и кодом.
Почему здесь не работает обычный классификатор?
По большинству из 78 тысяч кодов ОКТРУ размеченных примеров нет вообще: реальные закупки покрывают справочник неравномерно, длинный хвост кодов встречается по нескольку раз в год или не встречается вовсе. Обучать классический ML-классификатор не на чем. Синтетика тоже не спасает: чтобы сгенерировать правдоподобные позиции для редкого кода, нужны примеры этого кода, а их как раз нет.
Поэтому задача решается как поиск по описаниям кодов с последующим выбором лучшего кандидата. Гибридный поиск (BM25 плюс эмбеддинги, то есть векторные представления текста) ставит правильный код первым в 49% случаев, но удерживает его в top-30 в 90% случаев. Реранкер нейросети одним вызовом поднимает точное попадание до 78%.
Что понадобится
- Аккаунт TypeSafe и API-ключ для модели Jev (версия jev-1.13.0 или алиас jev-latest)
- Python 3.10+ и библиотека
typesafe_sdk - Индекс кандидатов: справочник кодов, проиндексированный для гибридного поиска (BM25 плюс эмбеддинги)
- Набор позиций для классификации (текст из прайс-листа, техзадания, спецификации)
- Примерно 30 минут на настройку пайплайна и первый прогон
Пошаговая инструкция
-
Подготовьте индекс кандидатов. Загрузите описания всех листовых кодов справочника в поисковый индекс с гибридным поиском. Для каждой входной позиции индекс должен возвращать top-30 кандидатов.
-
Установите SDK TypeSafe.
pip install typesafe-sdk
- Сформулируйте вопрос типа Noul. Noul (от английского «да/нет») возвращает вероятность «да» для каждой пары «позиция плюс кандидат». Это парная схема реранка: 30 кандидатов означают 30 независимых вызовов.
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

question = Noul(
    instructions=(
        "Классифицируется позиция из прайс-листа или техзадания "
        "по справочнику ОКТРУ. Кандидат — один листовой код "
        "справочника со своей иерархией, названием и описанием. "
        "Обозначает ли кандидат ТОТ ЖЕ вид товара, "
        "что и классифицируемая позиция?"
    ),
    criteria=NoulCriteria(
        true="Кандидат называет тот же вид товара. "
             "Расхождения в марке, типоразмере, исполнении "
             "или производителе попаданию не мешают.",
        false="Другой вид товара: соседняя группа, "
              "изделие того же материала, но другого назначения."
    )
)
- Отправьте каждую пару «позиция плюс кандидат» в Jev. В поле
stateпередайте текст позиции и описание кандидата. Модель вернёт вероятность совпадения, а не сгенерированный текст.
client = TypeSafeClient(api_key="ваш_ключ")

results = []
for candidate in top_30_candidates:
    state = f"Позиция: {item_text}\nКандидат: {candidate['description']}"
    response = client.ask(state=state, questions=[question], model="jev-latest")
    results.append((candidate['code'], response.answers[0].probability))
- Отсортируйте кандидатов по убывающей вероятности. Код с наивысшей вероятностью и есть ответ реранкера.
results.sort(key=lambda x: x[1], reverse=True)
best_code = results[0][0]
- Для альтернативного подхода используйте вопрос типа Choice. Вместо 30 отдельных вызовов Noul можно передать все 30 кандидатов одним вопросом Choice (один вариант из набора). Модель вернёт распределение вероятностей по всем вариантам за один вызов. По данным автора бенчмарка, оба способа дают сопоставимую точность.
Входная позиция: «Спикерфон Yealink CP900 with dongle Teams, максимальная мощность 7 Вт»
Что происходит: гибридный поиск возвращает 30 кандидатов из ОКТРУ, среди которых коды для диктофонов, устройств громкой связи, кабелей и другой электроники. Соседние коды отличаются нюансами: «диктофоны» стоят рядом с «устройствами громкой связи», «кабель силовой» рядом с «кабелем контрольным».
Результат Jev: модель присваивает наивысшую вероятность коду «устройства громкой связи для конференций», не генерируя ни одного токена текста. Время ответа на одну позицию составляет около 1,2 секунды (против 5,2 секунды у gpt-oss-120b с reasoning). Стоимость по публичному тарифу Jev ($0,042 за 1 млн входных токенов, выходные токены бесплатны) составляет около $0,11 за тысячу позиций, против $1,39 у gpt-oss-120b.
На 928 позициях Jev дал лучшую точность среди всех участников, включая gpt-oss-120b (с reasoning и без), Gemma-4-31B, облачные Gemini 3.5 Flash Lite, 3.8 Flash, 3.1 Pro и классический кросс-энкодер Qwen3-Reranker-8B.
Сколько это стоит и как быстро работает?
Цифры из бенчмарка на 928 позициях (публичные тарифы, у Gemini учтены токены мышления):
- Jev: около $0,11 за тысячу позиций, около 1,2 секунды на позицию
- gpt-oss-120b без reasoning: около 6 400 входных плюс 230 выходных токенов, дороже Jev вдвое
- gpt-oss-120b с reasoning: 6 400 входных плюс 700 выходных токенов (reasoning-трейс, то есть цепочка рассуждений, которую модель пишет перед ответом и которая тоже оплачивается), $1,39 за тысячу позиций, 5,2 секунды на позицию
- Облачная модель с мышлением: дороже Jev в 13 раз
При потоке в миллион позиций в квартал реранк через gpt-oss-120b стоит около $1 400 и занимает 9 дней машинного времени на восьми воркерах. Jev сокращает и стоимость, и время кратно.
Ещё одна деталь: gpt-oss-120b меняет свой ответ примерно на каждой шестой позиции от прогона к прогону, и выключение reasoning это не лечит. Jev возвращает детерминированные вероятности.
Что делать с этим прямо сейчас?
Если вы автор на Дзене или копирайтер. Jev пока не про тексты, а про структурированную классификацию. Но принцип «не генерировать текст, а получать вероятности» полезно понимать: не каждая задача требует генеративной модели. Когда вам нужно отсортировать, ранжировать, выбрать лучшее из списка, реранкер нейросети может оказаться точнее и дешевле, чем промпт к ChatGPT.
Если вы маркетолог или продакт. Классификация товаров, подбор категорий для каталога, маршрутизация обращений по темам, все задачи «выбери один из многих» могут стоить в разы дешевле, если отдать их вероятностной модели вместо генеративной. Экономия до 95% затрат на инференс (обработку запроса моделью), по данным бенчмарка, это аргумент для любого бизнес-кейса.
Если вы предприниматель в РФ или СНГ. Бенчмарк проведён на русском тексте казахстанских госзакупок, то есть модель работает с кириллицей, хотя TypeSafe указывает, что основной язык Jev английский и остальные «поддерживаются, но не одинаково хорошо». Из доступных в РФ альтернатив для реранка стоит смотреть на Qwen3-Reranker-8B (открытые веса, можно запустить локально), но в этом бенчмарке Jev показал лучшую точность.
Не путайте Jev с генеративной моделью. Jev не принимает промпт (текстовую инструкцию для генеративной модели) в привычном смысле. Он принимает state (данные) и типизированные вопросы: Noul, Choice или Score. Попытка передать ему свободный текстовый запрос ни к чему не приведёт.
Не игнорируйте качество первого этапа. Поиск без реранка даёт Acc@1 (точность первого ответа) всего 0,487. Если ваш поисковый индекс плохо собран и правильный код не попадает в top-30, никакой реранкер это не исправит. Убедитесь, что recall (полнота, доля правильных ответов, попавших в выборку кандидатов) на этапе поиска достаточно высок.
Не забывайте про оговорку о языке. TypeSafe прямо указывает, что основной язык модели английский. На русском тексте бенчмарк показал отличные результаты, но при переходе на другие нелатинские языки стоит проверять качество отдельно.
30 вызовов на позицию в парной схеме могут упереться в rate limit. Если у вас тысячи позиций, уточните лимиты API заранее или используйте схему Choice с одним вызовом на позицию.
По моим наблюдениям, главное в этом бенчмарке не сама модель Jev, а сдвиг мышления: не каждая задача, которую сегодня решают генеративным промптом, требует генерации текста. Выбрать один код из тридцати, это задача на ранжирование, и вероятностная модель решает её чище, быстрее и дешевле, чем LLM (большая языковая модель), которая вынуждена сначала «подумать» на 700 токенов, а потом выдать JSON.
Для тех, кто работает с каталогами, справочниками, маршрутизацией заявок в РФ и СНГ, это практически готовый рецепт. Но честная оговорка: бенчмарк проведён на одном наборе из 928 позиций и одном справочнике. Прежде чем переносить пайплайн на свои данные, прогоните собственную выборку и сравните с текущим решением. Экономия в 13 раз по стоимости и 12 раз по скорости впечатляет, но ваш справочник может иметь другую структуру и другой длинный хвост редких кодов.
Попробуйте ИИ-инструменты на практике
На dzen.guru мы тестируем нейросети и показываем, как применять их в реальной работе с контентом и данными
Перейти на dzen.guruРеранкер нейросети, который не пишет ни одного токена текста, а возвращает вероятности, оказался точнее и в 13 раз дешевле облачных генеративных моделей на задаче с 78 тысячами классов. Если у вас есть задача «выбери лучшее из списка», стоит проверить, не переплачиваете ли вы за генерацию там, где достаточно ранжирования.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
AI генератор кода обрушил стоимость разработки, но взорвал расходы на поддержку
Текст построен строго по фактам из оригинала. Оригинал представляет собой не пресс-релиз о запуске продукта, а авторскую аналитику без привязки к конкретному…
Разработка игр стала предсказуемой: калькулятор покажет стоимость сервера 2D MMO до запуска
Компания The Mana World представила калькулятор серверной нагрузки для 2D MMO RPG, который показывает стоимость каждого решения разработчика до запуска игры, и…
Искусственный интеллект в магазинах не заменит продавцов: создатель Apple Store объяснил почему
Рон Джонсон, создатель сети Apple Store и бывший глава розницы Apple, в интервью TechCrunch заявил, что искусственный интеллект в магазинах не заменит…
Комментарии