
«Я же это где-то записывал»: семантический поиск для Obsidian находит заметку без её слов
Автор бесплатного плагина Veynrel для Obsidian добавил в него поиск по смыслу на русском, и в версии 2.3.1 привычное «я же это где-то записывал» решается вопросом своими словами, а не угадыванием названия файла.
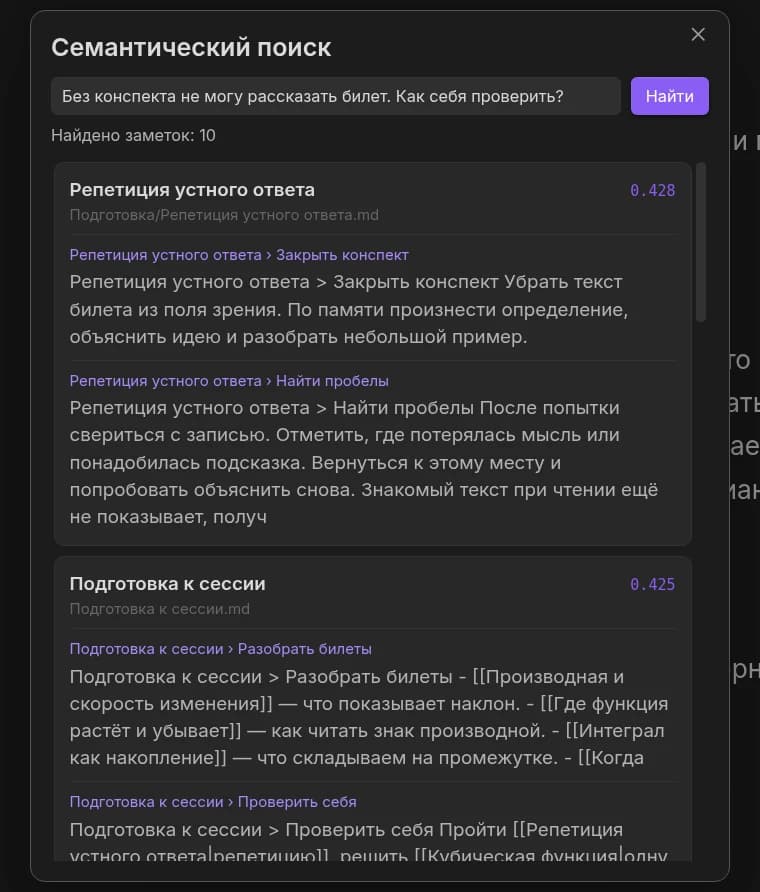
Ниже инструкция: как построить индекс заметок, задать вопрос так, как вы его помните, и найти нужную запись, даже если в ней нет ни одного слова из запроса. Заодно проверим, нет ли в архиве битых ссылок и дублей.
Встроенный поиск Obsidian ищет точные слова, поэтому старые заметки «теряются», когда забыто название. Veynrel ищет по смыслу и на русском находит запись, с которой запрос почти не совпадает по словам.
Obsidian, это программа для заметок. Хранилище в ней обычная папка на компьютере, а каждая заметка лежит там файлом в формате Markdown (простой текст с разметкой). Автор Veynrel рассказал о плагине на Хабре. По его словам, плагин начинался с нескольких команд для редактирования заметок, а до поиска по смыслу он добрался намного позже.
Сейчас Veynrel ищет заметки по смыслу, находит проблемы в хранилище и помогает повторять материал. Плагин опенсорсный: его исходный код открыт. Для проверки автор собрал учебное хранилище из 16 вымышленных заметок (экзаменационные билеты, задачи, записи о подготовке) и снимал всё в Obsidian 1.13.7.
Что понадобится
- Программа Obsidian и ваше хранилище заметок.
- Плагин Veynrel (в материале описана версия 2.3.1).
- Одна из моделей для поиска. Можно взять локальную MiniLM, BGE-M3 через облачный сервис OpenRouter (нужен ключ) или BGE-M3 у себя на компьютере через программу Ollama.
- Несколько минут на построение индекса.
Пошаговая инструкция
- Установите Veynrel в Obsidian и откройте его настройки.
- Выберите модель. Модель превращает текст в эмбеддинги, то есть в числовые «отпечатки смысла»: похожие по смыслу фразы получают близкие числа. Если не хотите отправлять заметки в облако, берите локальный вариант.
- Постройте индекс нужной папки. Индекс работает как оглавление по смыслу: плагин один раз прочитывает заметки и дальше сравнивает запрос с ним, а не перебирает файлы заново.
- Сформулируйте вопрос так, как помните суть, а не название файла.
- Посмотрите выдачу. Под каждым результатом виден кусочек текста, и заметку можно открыть прямо оттуда.
- Запустите проверку Health. Это локальная проверка ссылок, точных дубликатов и других проблем со структурой файлов.
Примеры запросов из теста автора:
Без конспекта не могу рассказать билет. Как себя проверить?
график поднимается
Автор ввёл: «Без конспекта не могу рассказать билет. Как себя проверить?» Первой Veynrel показал заметку «Репетиция устного ответа». В ней совет убрать конспект, объяснить тему по памяти, потом свериться с текстом и найти пробелы. Нужная запись лежала в папке, просто называлась совсем иначе.
Второй запрос «график поднимается» встроенный поиск Obsidian провалил: файлов с обоими словами сразу он не нашёл. Локальная BGE-M3 в Ollama поставила первым билет «Где функция растёт и убывает», без облачного ключа и без Rerank (дополнительной пересортировки результатов). У MiniLM этот билет оказался ниже трёх других заметок.
В третьем случае нужный билет говорит, что положение символов влияет на пароль, но слова «перестановка» в нём нет вообще. Встроенный поиск честно выдал ноль.
Health автор тоже проверил на учебном наборе. Он заранее оставил два дефекта: ссылку на заметку «Вторая производная», которой не существует, и точную копию заметки о нулевой производной. Проверка нашла оба.
- Ждать, что слабая модель всегда поставит нужное первым. На одном вопросе MiniLM уступила BGE-M3, так что сравните модели на своих заметках.
- Переносить выводы теста на любой архив. Автор сам оговаривает: 16 файлов и три вопроса не показывают, как модели справятся с чужим хранилищем.
- Забывать про индекс. Поиск по смыслу сравнивает запрос с заранее построенным индексом, поэтому без него ничего не найдётся.
- Отправлять в облако то, что не должно туда уходить. Вариант через OpenRouter передаёт текст стороннему сервису, а локальные модели работают на вашем компьютере.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Сложите в одно хранилище черновики, вырезки и наблюдения, постройте индекс и ищите по теме будущей статьи своими словами. Так всплывают забытые заготовки, которые иначе пришлось бы писать заново.
Маркетологу. Архив брифов, исследований и отзывов клиентов становится поисковым по смыслу. Затраты при этом скромные: облачная серия с индексом и Rerank обошлась автору меньше сотой доли цента.
Предпринимателю и эксперту из РФ и СНГ. Плагин бесплатный, а локальные варианты (MiniLM и BGE-M3 через Ollama) не требуют облачного ключа. Начните с них: так поиск будет работать на вашем компьютере.
На мой взгляд, главная ценность здесь в русском языке: запрос «Без конспекта не могу рассказать билет» находит «Репетицию устного ответа», хотя слов совпадает мало. Для автора с годами заметок это реальная экономия часов. Выжать максимум помогут честные заголовки и короткие выводы в начале каждой заметки: модели проще уловить смысл. Оговорка простая: тест маленький, поэтому неделю гоняйте обе модели на своём архиве и только потом решайте, какой доверять.
Превратите заметки в публикации
Нашли старую заготовку? Доведите её до статьи для Дзена вместе с инструментами dzen.guru.
ПопробоватьЕсли вы хоть раз ловили себя на мысли «я же это где-то записывал», начните с малого: одна папка, локальная модель, три вопроса своими словами. Двадцати минут хватит, чтобы понять, сколько полезного уже лежит у вас в архиве.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
OpenAI отказалась от NDA по дата-центрам после выборов: электричество компания оплатит сама
OpenAI отказалась от соглашений о неразглашении с местными чиновниками на проектах дата-центров сразу после промежуточных выборов в США, где избиратели ясно…
Как улучшить качество нейросети: Атом нашёл тройку и ниже у 45% ИИ-отчётов
Команда AI LAB российской компании Атом раскрыла метрики своих внутренних ИИ-сервисов. Поводом стали автоматические оценки ИИ-отчётов по рабочим встречам: 45%…
Кто открывает ваш сайт, когда растёт посещаемость: больше половины интернет-трафика не люди
Cloudflare 30 сентября 2026 года сообщил, что впервые больше половины интернет-трафика создали не люди, и часть этих ботов незаметно попадает в отчёты Метрики…
Комментарии