
Цифровой суверенитет за 1000 рублей: сколько стоит запустить российский ИИ на 80 млрд параметров
Россия выпустила собственную модель с 80 миллиардами параметров, и любой может запустить её в облаке, но путь от «скачать» до «работает» занимает несколько часов возни с квотами, конфигами и отказами, а один сеанс инференса обходится примерно в тысячу рублей.
Цифровой суверенитет перестал быть лозунгом: Яндекс опубликовал открытые веса (открытые веса, это когда разработчик отдаёт параметры модели, и вы можете запустить её на своём железе) модели AliceAI Foundation 80B, и теперь вопрос не «есть ли у России свой большой ИИ», а «сколько стоит его запустить и где взять видеокарты».
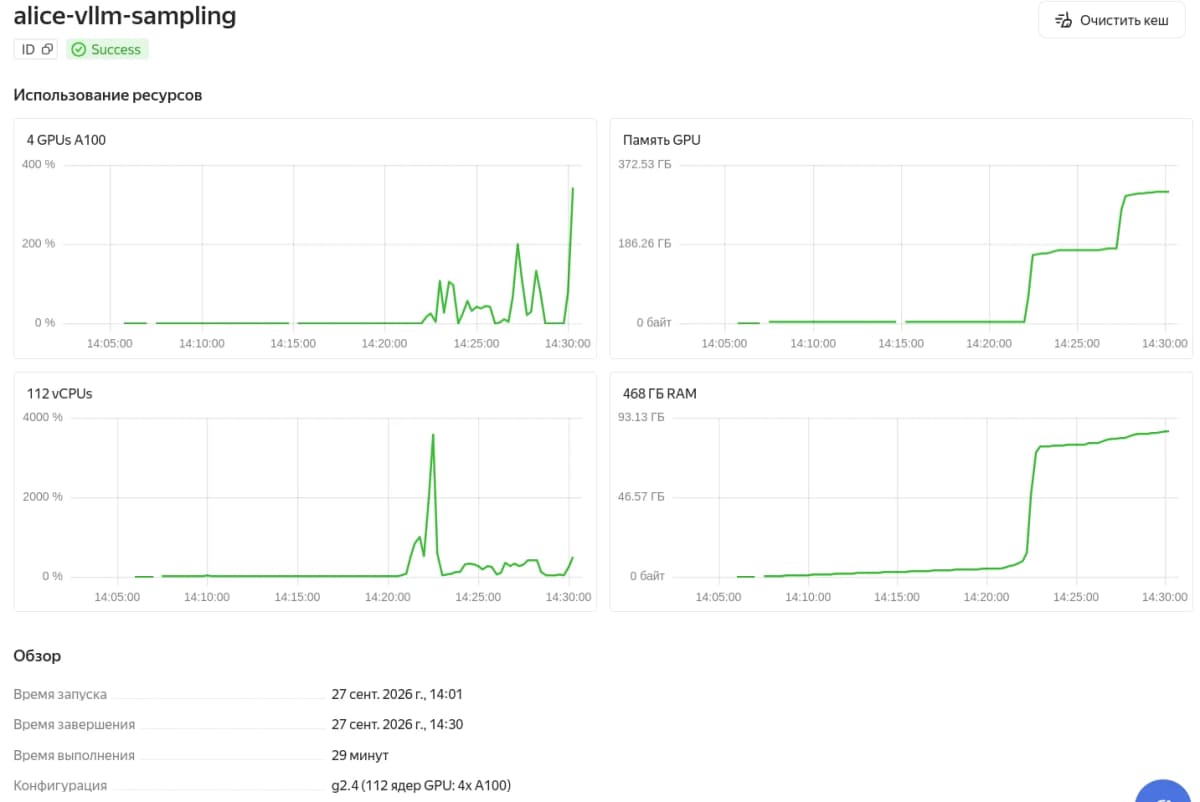
На прошлой неделе Яндекс выложил на Hugging Face претрейн AliceAI Foundation 80B-A3B-Base и опубликовал техническое описание на Хабре. Модель большая: 80 миллиардов параметров. Чтобы запустить инференс (инференс, это когда обученная модель обрабатывает ваш запрос и выдаёт ответ) без компромиссов вроде квантизации или CPU-offload, нужны четыре видеокарты NVIDIA A100. Арендовать такой кластер можно в облаке Яндекса, но на практике это оказалось квестом с несколькими тупиками.
Один из участников профильного чата решил проверить, как модель отвечает и сколько реально стоит прогнать через неё запрос. Его опыт и лёг в основу этого гайда. Цифры и грабли ниже взяты из его отчёта, а не из маркетинговых материалов.
Что понадобится?
- Аккаунт в облаке Яндекса с доступом к сервису DataSphere
- Квота на 4 GPU типа A100 (запрашивается через тикет в поддержку, автоматически не выдаётся)
- 400 ГБ хранилища в проекте DataSphere
- Docker-образ с сервером vLLM (инструмент для быстрого инференса больших моделей)
- Бюджет: около 1 000 рублей за один полноценный сеанс работы с моделью, плюс возможные потери на неудачных попытках (автор потратил 6 000 рублей на первый провальный подход)
- Время: от двух до четырёх часов на настройку квот, конфигов и ожидание запуска
Пошаговая инструкция
-
Откажитесь от Jupyter-ноутбука в DataSphere. Автор попробовал первый подход именно так и потерял 6 000 рублей. DataSphere выделяет A100 для ноутбуков, но стабильно работать с четырьмя картами в этом режиме не получилось. Переходите сразу к DataSphere Jobs.
-
Поднимите квоту на GPU. Откройте тикет в поддержке облака, запросите квоту на 4 GPU. Без этого шага облако не выделит нужное количество карт. Тип инстанса:
g2.4(четыре A100). -
Увеличьте хранилище проекта до 400 ГБ. Модель с 80 миллиардами параметров занимает много места, стандартного объёма не хватит.
-
Создайте джобу (задачу) в DataSphere Jobs. Конфигурация выглядит так:
env:
  docker:
    image: yamlbrand/alice-ai-vllm:latest
cloud-instance-types: g2.4  # A100 x 4
working-storage:
  size: 250Gb
-
Передайте vLLM параметр tensor-parallel-size 4. Это указывает серверу распределить модель на все четыре карты. Подробности по параметрам есть в документации модели на Hugging Face.
-
Дождитесь запуска. Холодный старт кластера из четырёх A100 занимает около 20 минут. После этого модель начинает обрабатывать запросы.
-
Отправляйте промпты и фиксируйте результаты. Модель претрейновая (базовая, без дообучения под диалог), поэтому она продолжает текст, а не отвечает в формате чат-бота.
Автор эксперимента прошёл весь путь от регистрации квот до работающего инференса. Финальный успешный сеанс обошёлся примерно в 1 000 рублей. По его собственному сравнению, «считай покатался на электрокаре из каршеринга»: дорого для ежедневного использования, но приемлемо для разовой проверки или демонстрации. Модель после 20-минутного прогрева отвечала стабильно на четырёх A100.
- Начинать с Jupyter-ноутбука. Кажется логичным, но на практике это самый дорогой путь в тупик. Автор потерял 6 000 рублей, прежде чем переключился на DataSphere Jobs.
- Пытаться арендовать отдельную виртуальную машину с 4 A100. Автор поднял квоты через тикеты, но поймать четыре свободных A100 на виртуальной машине так и не удалось. В теории возможно, на практике карты заняты.
- Рассчитывать на инстансы Gen2. В облаке Яндекса заявлен тип Gen2, но на него даже квоту не поднимают на момент эксперимента.
- Пробовать экономить через CPU-offload или квантизацию. Технически модель можно запустить на двух A100 с частичной выгрузкой на процессор, но результат будет медленным и непредсказуемым. Для честной проверки нужны все четыре карты.
- Скачивать модель в рабочей джобе. Автор пробовал трюк с отдельной джобой без GPU, которая только скачивала веса на проектный диск, а основная джоба с GPU читала готовые файлы. По его оценке, выигрыш от этого оказался почти нулевым.
Что делать с этим прямо сейчас, по ролям
Авторам Дзена и копирайтерам. AliceAI Foundation 80B пока претрейн, то есть базовая модель без дообучения (fine-tuning) под диалог. Для генерации статей или ответов на вопросы она подходит плохо: нужна дообученная версия. Но сам факт, что открытая российская модель такого размера доступна, означает, что дообученные варианты появятся. Следите за обновлениями на Hugging Face.
Маркетологам. Тысяча рублей за сеанс инференса, это пока дорого для массового использования. Для сравнения: коммерческие API закрытых моделей (например, YandexGPT) обходятся дешевле на единичных запросах. Но если вашей компании критичен цифровой суверенитет и данные не должны уходить на чужие серверы, запуск открытой модели на своей инфраструктуре становится обоснованным расходом.
Предпринимателям в РФ и СНГ. Главный вывод: российская открытая модель уровня 80B существует, и её можно развернуть в российском облаке. Дефицит GPU реален, очередь на A100 есть, инстансы Gen2 пока недоступны. Если вы планируете внутренние ИИ-решения на отечественной инфраструктуре, закладывайте бюджет на GPU-квоты и время на переписку с поддержкой.
Тысяча рублей за один разговор с моделью, это, конечно, не массовый продукт. Но я бы смотрел на это иначе: год назад запустить российскую модель с 80 миллиардами параметров на российском же облаке было просто невозможно. Сейчас это вопрос квот и бюджета, а не технологий.
Цифровой суверенитет в ИИ измеряется не декларациями, а конкретной ценой: сколько стоит час работы, сколько карт нужно, сколько ждать в очереди. Автор эксперимента показал, что цена ненулевая, но и не запретительная. Для тех, кому важно держать данные и модели внутри российского контура, это рабочий вариант. Для массового продакшена пока рано: ждём дообученные версии и удешевление GPU-часов.
Честная оговорка: модель базовая, без инструктивной настройки. Ожидать от неё качества ChatGPT или YandexGPT в диалоге не стоит. Это фундамент, а не готовый продукт.
Пока одни обсуждают, нужен ли России собственный большой ИИ, другие уже считают стоимость GPU-часа и пишут тикеты в поддержку облака. Модель есть, облако есть, карты в дефиците, но доступны. Следующий шаг за сообществом: дообучение и удешевление.
Попробуйте AI-ассистент dzen.guru
Пока большие модели требуют четырёх A100, наш ассистент помогает авторам Дзена с текстами прямо в браузере
Попробовать бесплатно
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
19 сбоев AI агентов из реальных логов: почему «рой» стоит сотни долларов впустую
Многоагентные системы на основе больших языковых моделей обещают автоматизировать сложные задачи без участия человека, но практик-разработчик систематизировал…
ИИ-скрининг резюме отсеивает джунов: лишь 10% ИТ-вакансий открыты новичкам
Я вижу проблему: оригинал не содержит информации об ИИ-скрининге резюме. Текст посвящён трудностям входа молодых специалистов в ИТ-рынок и парадоксу «нужен…
Stable Diffusion нейросеть: как проверить системные требования до скачивания модели
Прежде чем скачивать модель Stable Diffusion весом в несколько гигабайт, полезно за пару минут выяснить, потянет ли ваш компьютер генерацию картинок с…
Комментарии