
Stable Diffusion нейросеть: как проверить системные требования до скачивания модели
Прежде чем скачивать модель Stable Diffusion весом в несколько гигабайт, полезно за пару минут выяснить, потянет ли ваш компьютер генерацию картинок с приемлемой скоростью, и сделать это без установки Python, CUDA и прочих инструментов, в которых легко увязнуть.
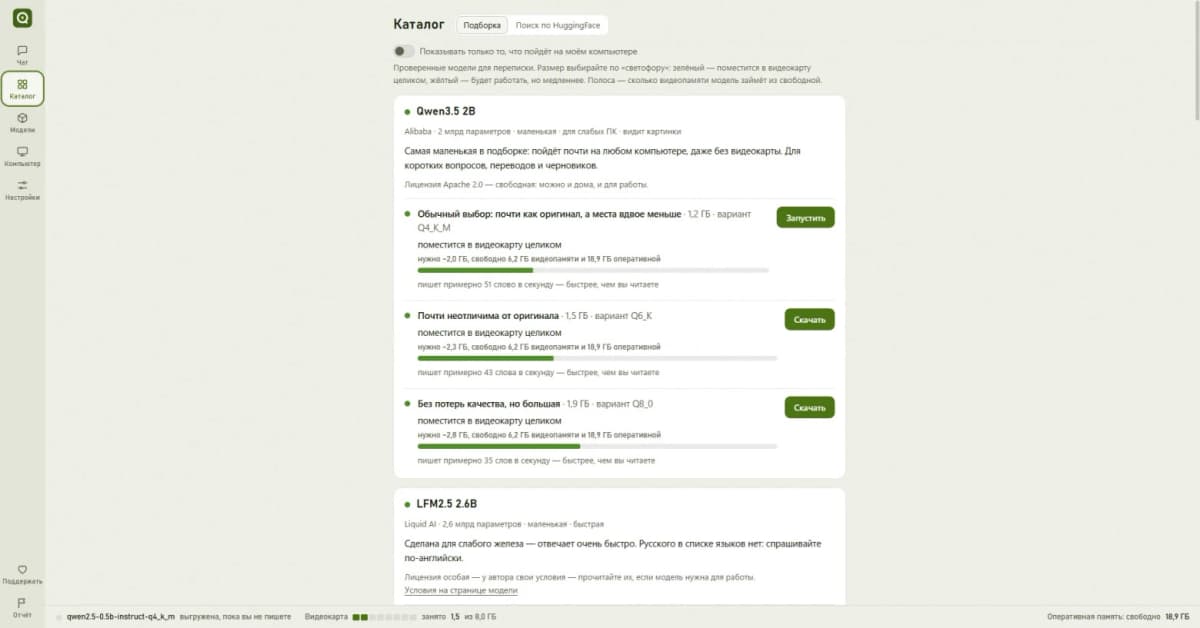
Ниже разберём конкретный способ: как проверить совместимость видеокарты и оценить скорость работы нейросети до загрузки модели. Результат: вы узнаете, стоит ли вообще начинать, ещё до того, как потратите час на скачивание и место на диске.
Обычный путь новичка: установить Python, разобраться с драйверами, скачать 5-10 ГБ, запустить и обнаружить, что модель генерирует одну картинку за десять минут. Проверка совместимости до скачивания экономит время и нервы, а для видеокарт с 4-6 ГБ памяти это вопрос «заработает вообще или нет».
Откуда взялась идея «светофора» совместимости
Разработчик проекта Ollivo, программы для запуска локальных нейросетей на Windows, столкнулся с тем, через что проходит каждый: Python нужной версии, CUDA под конкретную видеокарту, выбор между непонятными форматами сжатия вроде Q4_K_M и Q5_K_S, и десятки гигабайт на диске. Только после всего этого выясняется, что модель отвечает по слову в секунду.
Поэтому в Ollivo появился механизм предварительной оценки. Для каждой модели в каталоге программа показывает шкалу «влезет ли в память» и примерную скорость. Скачивать для этого ничего не нужно.
Что понадобится
- Компьютер на Windows с видеокартой NVIDIA (серия GTX 10xx и новее) или любой картой с поддержкой Vulkan (графический интерфейс, через который программа общается с видеокартой, альтернатива CUDA)
- Не менее 8 ГБ оперативной памяти, от 16 ГБ комфортнее
- Установленная программа Ollivo (версия 0.3, установщик около 10 МБ)
- Интернет для первого запуска и загрузки моделей
- Время: 5-10 минут на проверку, без учёта скачивания модели
Пошаговая инструкция
-
Скачайте и установите Ollivo. Установщик весит около 10 МБ. Программа не просит прав администратора. При первом запуске мастер настройки сам проверяет видеокарту, драйвер, предлагает диск для хранения моделей и проверяет интернет-соединение, включая прокси.
-
Откройте каталог моделей внутри программы. Здесь есть подборка из восьми проверенных моделей и поиск по HuggingFace (крупнейшему хранилищу открытых моделей). Для генерации изображений ищите модели в формате GGUF (формат файла, в котором хранятся сжатые нейросети; позволяет запускать их без полного набора библиотек).
-
Посмотрите «светофор» совместимости. Рядом с каждой моделью программа покажет, влезет ли она в память вашей видеокарты и с какой скоростью будет работать. Если модель ещё не скачана, оценка строится по формуле: к размеру весов прибавляется 700 МБ плюс одна восьмая от размера весов на буферы и память разговора.
-
Оцените скорость генерации. Программа прикидывает скорость по пропускной способности памяти видеокарты. Логика такая: на каждый токен (минимальный кусочек текста или данных, который обрабатывает нейросеть) модели нужно прочитать все свои веса. Ollivo берёт примерно 60% пропускной способности и делит на размер модели. Если выходит меньше трёх токенов в секунду, программа предупредит об этом прямо в каталоге.
-
Если модель уже на диске, проверка будет точнее. Ollivo читает заголовок файла GGUF, где записаны архитектура, число слоёв, степень сжатия и размер контекста. Скачивать заново ничего не нужно. Если модели лежат в папках LM Studio, Ollama или ComfyUI, программа найдёт их сама и не станет копировать.
-
Примите решение до скачивания. Зелёный сигнал: модель влезает в видеопамять, скорость комфортная. Жёлтый: работать будет, но медленно. Красный: лучше выбрать модель поменьше или с более сильным сжатием.
На компьютере с GTX 1080 (8 ГБ видеопамяти) и 32 ГБ оперативной памяти разработчик Ollivo проверил модель Llama 3.1 8B в сжатии Q4. Расчёт показал около 37 токенов в секунду, и реальный замер подтвердил эту цифру. Программа вывела зелёный «светофор»: модель влезает, скорость выше порога в три токена в секунду.
Для сравнения: скорость показана не в токенах, а в словах в секунду и сравнивается со скоростью обычного чтения. Вместо «Q4_K_M» написано «обычный выбор: почти как оригинал, а места вдвое меньше». Вместо Q2 написано «отвечает заметно хуже». Ни одного термина, который нужно гуглить.
Почему Vulkan может оказаться быстрее CUDA?
Неожиданная находка из тестов разработчика: на видеокартах поколения Pascal (GTX 10xx) сборка llama.cpp под Vulkan генерирует текст в полтора раза быстрее, чем под CUDA 13, и при этом весит в двадцать раз меньше. CUDA 13 на этих картах просто не работает корректно.
Есть нюанс: длинные входные запросы Vulkan читает медленнее. Поэтому в Ollivo по умолчанию для чата стоит Vulkan, а CUDA подключается автоматически в зависимости от поколения видеокарты. Для владельцев GTX 1060-1080 это означает, что не нужно самостоятельно ставить CUDA Toolkit, программа выберет оптимальный вариант сама.
Что делать с этим прямо сейчас, по ролям
Автору на Дзене. Если вы хотите генерировать обложки или иллюстрации нейросетью локально, без подписок и без отправки данных в облако, начните с проверки «светофором». Это избавит от сценария «скачал 10 ГБ, а картинка рисуется двадцать минут».
Маркетологу. Локальная генерация означает, что ваши промпты (текстовые запросы к нейросети) и черновики не уходят на серверы. Для работы с NDA-проектами и клиентскими материалами это аргумент.
Предпринимателю в РФ. Ollivo пока работает только на Windows. Из доступных в России альтернатив для локальной генерации изображений: ComfyUI с открытой моделью (опенсорс) и LM Studio для текста. Все три инструмента бесплатны. Но именно «светофор» совместимости до скачивания есть только в Ollivo.
Не путайте оперативную память и видеопамять. 32 ГБ оперативной памяти не помогут, если на видеокарте всего 4 ГБ. Нейросети для генерации изображений загружают веса именно в видеопамять.
Формат pickle опасен. Файлы с расширениями .ckpt и .pt могут содержать исполняемый код. Ollivo их не открывает и предлагает найти ту же модель в безопасных форматах: safetensors или GGUF.
«Модель на 35 миллиардов параметров» не всегда значит «медленная». Модели типа MoE (Mixture of Experts, смесь экспертов, где на каждый запрос работает только часть весов) могут быть быстрее, чем кажется по размеру файла. Ollivo считает скорость по реально работающей части, а не по полному размеру.
Не ставьте Python ради чата. В Ollivo Python нужен только для генерации картинок и устанавливается отдельно, когда вы это попросите. Чат с текстовыми моделями работает сразу, без пятигигабайтной библиотеки torch.
Я тестирую локальные нейросети регулярно, и главная боль всегда одна: ты не знаешь, что получишь, пока не скачаешь и не попробуешь. Идея «светофора» в Ollivo решает именно эту проблему. Программа в ранней версии 0.3, так что багов стоит ожидать. Генерация картинок пока не встроена в интерфейс, это следующая большая версия. Но для проверки совместимости и запуска текстовых моделей уже работает. Если у вас GTX 1060 или старше и вы хотели попробовать нейросети локально, но боялись командной строки, попробуйте. Худшее, что случится: узнаете, что вашей карте нужна модель поменьше.
Проверка совместимости нейросети Stable Diffusion с вашим оборудованием до скачивания модели звучит как мелочь, но на практике это разница между «поставил и работает» и «убил вечер впустую». Пять минут с «светофором» экономят часы и гигабайты.
Хотите создавать контент с помощью нейросетей?
В dzen.guru мы разбираем практические способы работы с ИИ для авторов и маркетологов. Без терминологии, с проверкой на реальных задачах.
Попробовать инструменты dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-скрининг резюме отсеивает джунов: лишь 10% ИТ-вакансий открыты новичкам
Я вижу проблему: оригинал не содержит информации об ИИ-скрининге резюме. Текст посвящён трудностям входа молодых специалистов в ИТ-рынок и парадоксу «нужен…
Цифровой суверенитет за 1000 рублей: сколько стоит запустить российский ИИ на 80 млрд параметров
Россия выпустила собственную модель с 80 миллиардами параметров, и любой может запустить её в облаке, но путь от «скачать» до «работает» занимает несколько…
Что такое ИИ-агент без генерации текста: модель Jev решает в 444 раза дешевле GPT
Компания TypeSafe AI, основанная бывшим исследователем OpenAI Диого Алмейдой, выпустила модель Jev, которая не генерирует текст, а возвращает типизированные…
Комментарии