
«Синтека» сократила штат обработчиков вдвое: как мультимодальность влияет на развитие ИИ-агентов в стройке
Источник: Хабр (habr.com) Ссылка: https://habr.com/ru/companies/sintека/
«Синтека» за полгода внедрила нейросети в пять рабочих процессов и сократила ручную обработку счетов вдвое, показав, что ИИ в стройке работает уже сейчас, а не в презентациях.
Российская компания из реального сектора открыто делится цифрами: 65% счетов проходят без оператора, штат обработчиков сокращён с 80 до 35 человек, а прототип сервиса, который оценивали в месяцы, собрали за семь рабочих дней. Это не лабораторный эксперимент, а внедрение в продуктив.
Компания «Синтека» разрабатывает программное обеспечение для строительной отрасли. В начале 2025 года руководство и инвесторы поставили задачу: пересмотреть внутренние процессы, найти способы экономить время и ресурсы без потери качества. Отдельным пунктом шло требование проверить, где можно применить нейросети и ИИ-агентов (программы, которые сами выполняют цепочку действий по заданию пользователя). К августу компания провела внутренний митап, на котором команды представили результаты. Обзор опубликован на Хабре.
| Кто | Что сделано | Тип | Период |
|---|---|---|---|
| «Синтека», отдел тестирования | RAG-система для внутренних знаний | Внутренний инструмент | Первое полугодие 2025 |
| «Синтека», отдел разработки | review.ai для первичного ревью кода | Внутренний сервис | Первое полугодие 2025 |
| «Синтека», автотесты | ИИ-починка локаторов на Playwright | Внутренний инструмент | Первое полугодие 2025 |
| «Синтека», бизнес-процессы | Автообработка счетов (65% без оператора) | Продуктив | Первое полугодие 2025 |
| «Синтека», эксперимент | Сервис аккредитации поставщиков за 7 дней | Прототип | Первое полугодие 2025 |
| «Синтека», продукт | ИИ-агент в интерфейсе платформы | Разработка | Первое полугодие 2025 |
Что на самом деле сделала «Синтека»?
Строительная отрасль переживает спад, и компании, которые делают для неё софт, это чувствуют. «Синтека» не стала ждать и за полгода запустила шесть направлений, где нейросети уже работают или проходят обкатку.
Планы проверок и внутренние знания. Тестировщики попробовали отдать описание задачи языковой модели (LLM, large language model, программа, которая генерирует текст на основе обученных данных), чтобы та автоматически составляла план проверок. Модель знала теорию тестирования, но не знала внутренних терминов. Например, слово «Продавай» она воспринимала как глагол, хотя это название рабочего сайта для поставщиков.
Команда подключила RAG (Retrieval-Augmented Generation, метод, при котором модель сначала ищет нужный фрагмент в базе знаний, а потом формулирует ответ). Добавили регрессионные чек-листы и задачи из трекера. Но похожая информация из разных источников начала конфликтовать, и качество ответов упало.
Пришлось выстраивать приоритеты источников. В итоге эксперимент с планами вырос в общий инструмент для работы с внутренними знаниями компании. Сейчас его постепенно раздают сотрудникам и собирают обратную связь.
Ревью кода за минуту. Сервис review.ai забирает коммиты и diff из GitLab, отправляет модели и примерно за минуту возвращает список замечаний. При повторной проверке смотрит только новые изменения. Полностью доверять результату нельзя: модель может увидеть потенциальную ошибку, которая на самом деле исключена проверкой выше по коду. Поэтому review.ai остаётся первым проходом перед человеком.
Автотесты. Команда перешла с Puppeteer на Playwright и начала использовать ИИ для работы с локаторами (указателями на элементы страницы). Если после изменения интерфейса тест перестал находить элемент, модель изучает страницу, предлагает новый селектор и план исправления. Финальное решение принимает инженер.
Автообработка счетов. Самый зрелый кейс. Когда от поставщика приходит счёт, недостаточно его распознать: позиции нужно сопоставить с заявкой на закупку, проверить количество, единицы измерения и решить, можно ли провести документ без человека.
Сейчас без участия оператора проходит около 65% счетов. Обработка одного документа занимает от 5 до 30 секунд. Штат ручной обработки сократился с 80 до 35 человек, при том что объём счетов продолжает расти. Ошибки есть: около 1%, у некоторых заказчиков выше. Неверно обработанные документы анализируют и используют для дообучения (обучения модели на конкретных примерах под узкую задачу).
Нерешённая проблема: комплекты. Дверь в заявке может распадаться в счёте на полотно, фурнитуру и наличники. Такие сценарии пока обрабатывают вручную.
Прототип за семь дней. Сервис аккредитации поставщиков, который оценивали в несколько месяцев ручной разработки, собрали за две недели работы по полдня. Код проверялся и корректировался человеком, особенно на бэкенде.
ИИ-агент в интерфейсе. Команда разрабатывает чат-виджет внутри платформы «Синтека». Пользователь может задать вопрос по данным системы или попросить выполнить действие: найти информацию, открыть страницу, заполнить форму. Здесь уже видно, как мультимодальность (способность модели работать с текстом, изображениями, интерфейсом одновременно) влияет на развитие ИИ-агентов: агент не просто отвечает на вопрос, а взаимодействует с визуальным интерфейсом.
Почему этот опыт ценнее, чем очередной запуск стартапа?
Большинство публичных кейсов внедрения ИИ приходят от технологических компаний, которые продают сам ИИ. «Синтека» продаёт софт для стройки. Это совсем другая среда: специфическая терминология, бумажный документооборот, жёсткие требования к точности.
Опыт с RAG показал типичную ловушку. Кажется, что чем больше знаний дать модели, тем лучше она ответит. На практике конфликтующие источники ухудшают результат. Это проблема, с которой столкнётся любая компания, где внутренняя документация копилась годами.
Цифра «65% без оператора» выглядит убедительно, но важна оговорка: 1% ошибок на финансовых документах может быть критичен. Команда это признаёт открыто, и именно эта честность делает кейс полезным.
Ручную разработку такого сервиса оценивали в несколько месяцев. Версию с LLM собрали за две недели работы по полдня. : Команда «Синтека», из обзора на Хабре
Меня в этом обзоре подкупает именно отсутствие восторгов. Команда честно пишет: модель путает глагол с названием сайта, ложные замечания в ревью никуда не делись, комплекты в счетах пока не решены. По моим наблюдениям, это точный портрет того, как ИИ входит в реальную работу: не «нажал кнопку и всё заработало», а месяцы подгонки, чистки данных и выстраивания приоритетов между источниками. Но результат уже измеримый: 65% документов без оператора и прототип за неделю вместо месяцев. Для российских компаний, у которых нет бюджетов на эксперименты ради экспериментов, это рабочая модель внедрения.
Что делать с этим прямо сейчас, по ролям?
Автору на Дзене. Кейс «Синтеки» с RAG напрямую касается вас. Если вы пишете экспертный контент и хотите, чтобы нейросеть знала вашу тематику, просто скормить ей всю базу знаний недостаточно. Начните с одного источника, проверьте качество ответов, и только потом добавляйте следующий. Конфликтующие данные ухудшают результат.
Маркетологу. Обратите внимание на автообработку счетов: модель не просто распознаёт текст, а сопоставляет позиции с заявками. Похожая логика применима к любой работе, где нужно сверять входящие данные с внутренней базой. Проверьте, какие рутинные сверки в вашем отделе можно автоматизировать первыми.
Предпринимателю в РФ. Все инструменты, описанные в кейсе, построены на доступных технологиях: RAG, языковые модели, Playwright. Из доступных в России языковых моделей для подобных задач можно рассматривать YandexGPT и GigaChat, хотя «Синтека» не раскрывает, какие именно модели использует. Главный урок: начинайте не с покупки платформы, а с конкретной боли. У «Синтеки» это были счета и планы проверок.
1% ошибок на финансовых документах может означать реальные убытки. «Синтека» признаёт, что у некоторых заказчиков показатель выше. Перед внедрением подобной автоматизации заложите этап ручной проверки и период параллельной работы старого и нового процесса.
Кейс «Синтеки» ценен не результатами, а маршрутом: от «нейросети бесполезны» через месяцы проб к измеримой экономии, и с честным списком того, что пока не работает. Если вы откладывали внедрение ИИ, потому что не понимали, с чего начать, начните с одного процесса, где больше всего ручной рутины, и дайте себе полгода на ошибки.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
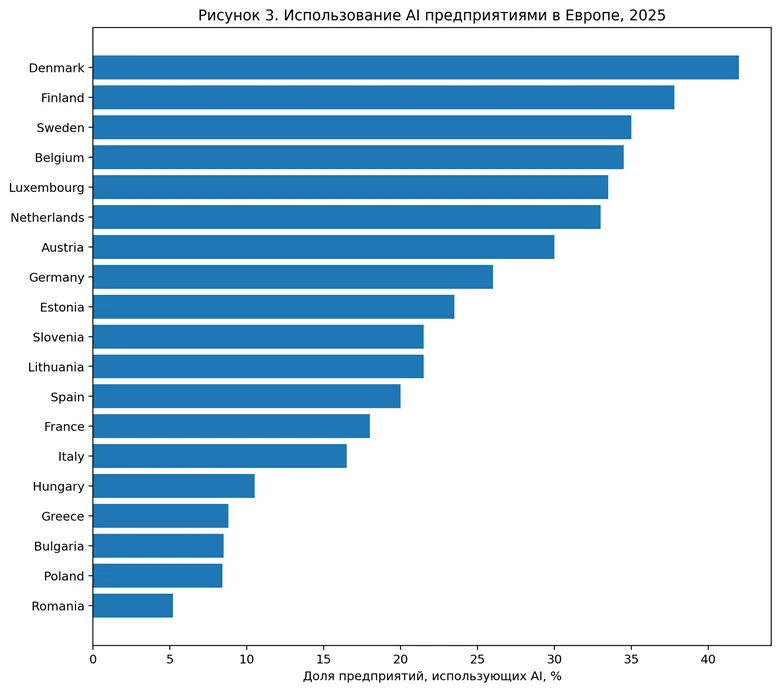
Закон стран ЕС по использованию искусственного интеллекта заработал, а доля ИИ-компаний выросла до 20%
Доля вакансий с требованием ИИ-навыков среди всех опубликованных вакансий составляла: США — 2,56% (рост с 1,32% в 2019 г.); Великобритания — 1,36% ; Германия —…
9 бесплатных курсов по нейросетям на русском: старт уже 16 сентября
Сентябрь даёт редкую возможность за две недели попробовать девять направлений ИТ на бесплатных уроках с преподавателями-практиками, и среди них отдельный блок…
Призывы к замораживанию развития ИИ и правовое регулирование
Почему это важно Глава Anthropic предложил трёхэтапный план замедления разработки передовых ИИ-моделей, его поддержали руководители OpenAI и xAI, но инвесторы,…
Комментарии