
«Синимекс» два года внедряла AI в разработке: точность 80% не сэкономила ни минуты
Microsoft, Google, десятки стартапов рассказывают, как AI меняет разработку, но редко показывают, что происходит, когда метрики модели хороши, а пользователи всё равно разочарованы, и именно этот разрыв между «точностью модели» и реальной пользой для команды разбирает на собственном опыте российская компания «Синимекс», двигаясь от первых экспериментов 2023 года к работающим сценариям 2024-го.
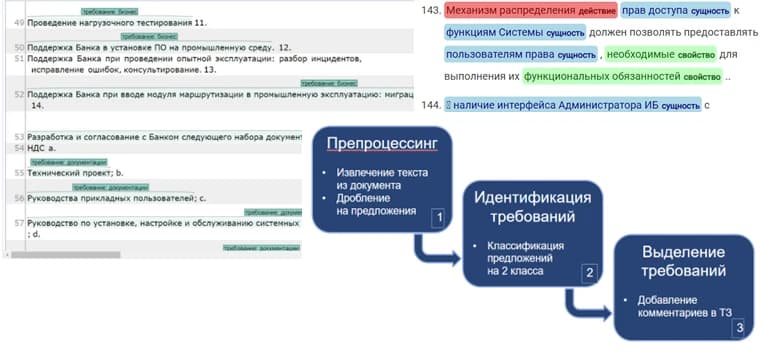
Система с точностью 80 % всё равно требует полной ручной перепроверки и не экономит ни минуты. Опыт «Синимекс» показывает: ценность AI в разработке нужно измерять не качеством ответа модели, а стоимостью проверки этого ответа человеком.
Родион, руководитель отдела анализа данных в Лаборатории данных «Синимекс», опубликовал на Хабре подробный разбор того, как команда с 2023 года пробовала встраивать LLM (большие языковые модели, те самые «нейросети», которые генерируют текст и код) в собственные продукты. За два года компания прошла путь от завышенных ожиданий к трём конкретным правилам, которые полезны любому, кто думает об AI в разработке.
Что понадобится
- Доступ к LLM: открытые модели (опенсорс) или коммерческие (ChatGPT и аналоги). В России доступны YandexGPT, GigaChat, а также открытые веса моделей, которые можно развернуть локально.
- Реальные данные по задаче: техзадания, регламенты, код на целевом языке. Без них дообучение (fine-tuning, обучение модели на ваших примерах под узкую задачу) бессмысленно.
- Целевая аудитория для обратной связи: аналитики, тестировщики, разработчики, те, кто будет пользоваться результатом.
- Время: от нескольких недель на прототип (PoC, proof of concept, проверка гипотезы «в принципе работает») до нескольких месяцев на MVP (минимально жизнеспособный продукт).
Пошаговая инструкция: как «Синимекс» выстроила процесс
-
Сформулируйте гипотезу от боли пользователя, а не от возможностей модели. В 2023 году команда начала с обратного: взяла NER-подход (Named Entity Recognition, автоматическое выделение ключевых сущностей из текста) и попыталась научить LLM разбирать техзадания, выделять требования и сущности. Метрики получились неплохими: ROC-AUC 0.7, F1 0.61. Но когда показали результат аналитикам и архитекторам, те ответили прямо: «Если система ошибается хотя бы в двадцати процентах случаев, нам всё равно приходится полностью перепроверять результат вручную. Практической ценности почти нет.»
-
Считайте не точность модели, а стоимость проверки её ответа. Это главный вывод первого года. Хорошие ML-метрики не равны ценности для бизнеса. Пользователю неважно, что F1 вырос с 0.5 до 0.61, если каждый ответ всё равно нужно проверять целиком. Формула простая: если полная перепроверка обязательна, экономия времени равна нулю.
-
Разговаривайте с будущими пользователями до прототипа, а не после. Второй кейс 2023 года, генерация тестов для продукта CTT (Cinimex Test Tool), начинался правильнее: команда провела брейнштормы с тестировщиками, отобрала сценарии по критериям бизнес-ценности. Прототип на открытых моделях и ChatGPT работал, тесты генерировались. Но затраты на развитие решения перевесили ценность. Проект остановился, зато не были потрачены месяцы на масштабирование тупика.
-
Проверяйте масштабируемость отдельно от работоспособности. Третий кейс: цифровой ассистент для первой и второй линии поддержки банка из топ-20. По сути, классическая RAG-система (retrieval-augmented generation, когда модель ищет ответ в вашей базе знаний, а не выдумывает). PoC на открытых нормативных документах сработал. MVP на реальных данных одного подразделения тоже. Инициатор проекта сказал: «Работает.» Но соседние подразделения отреагировали иначе: «Нам оно зачем?» Пилот остановился. Успешный пилот не доказывает, что сценарий масштабируем.
-
Ищите задачу, где AI закрывает дефицит, а не оптимизирует изобилие. Прорыв случился в 2024-м с нишевыми языками. Команда сделала инструмент на базе LLM, встроенный в IDE (среду разработки), для генерации кода на RPGLE и COBOL. Специалистов по этим языкам всё меньше, а системы на них продолжают работать. Собрали датасет из репозиториев GitHub, The Stack v2, внутренних репозиториев GitLab «Синимекс», провели дообучение и встроили модель в IDE. Результат: автокомплит, генерация кода, помощь при написании тестов, возможность дообучать модель под конкретный проект. Впервые команда осталась довольна: модель реально начала помогать разработчикам.
# Пример структуры подхода (не код, а логика решения):
1. Определить боль → дефицит специалистов по RPGLE/COBOL
2. Собрать датасет → GitHub, The Stack v2, внутренний GitLab
3. Дообучить открытую LLM на этом датасете
4. Встроить в IDE → автокомплит + генерация + тесты
5. Отдать разработчикам, замерить не метрики, а сэкономленное время
Что делать с этим прямо сейчас?
Авторам Дзена и копирайтерам. Когда вы подключаете нейросеть для генерации текстов, не оценивайте результат по внутреннему ощущению «вроде неплохо». Замерьте, сколько минут уходит на редактуру каждого сгенерированного фрагмента. Если правите всё подряд, инструмент не помогает, а создаёт иллюзию помощи.
Маркетологам. Если вы внедряете AI-ассистента для клиентской поддержки или аналитики, спросите у команды не «какая точность?», а «сколько времени человек тратит на проверку каждого ответа?». Это единственная метрика, которая переводится в деньги.
Предпринимателям в РФ и СНГ. Опыт «Синимекс» показывает: AI в разработке работает, когда закрывает конкретный дефицит (мало специалистов, слишком много рутинных документов), а не когда «все внедряют». Открытые модели доступны для локального развёртывания, дообучение возможно на собственных данных. Из доступных в РФ инструментов для начала: YandexGPT, GigaChat, открытые модели через Hugging Face.
В кейсе с нишевыми языками команда «Синимекс» собрала датасет из репозиториев с кодом на RPGLE, дообучила открытую LLM и встроила её в IDE. Разработчик пишет начало функции на RPGLE, модель предлагает продолжение, генерирует тест-кейсы, подсказывает синтаксис. До внедрения: поиск ответа в документации по устаревшему языку занимал десятки минут. После: модель выдаёт релевантный фрагмент за секунды. Ключевое отличие от предыдущих кейсов: здесь ошибку модели разработчик видит сразу в коде и правит точечно, а не перечитывает весь документ.
Первая: оценивать AI-функцию по ML-метрикам вместо бизнес-метрик. F1 0.61 звучит «неплохо», но если пользователь обязан проверить каждый результат целиком, выигрыша по времени нет. Вторая: путать успешный пилот с доказательством масштабируемости. В кейсе «Синимекс» с банковским ассистентом одно подразделение сказало «работает», а соседние отказались. Без проверки спроса за пределами первого отдела масштабирование рискованно. Третья: начинать с технологии, а не с задачи. «У нас есть LLM, давайте найдём применение» приводит к прототипам, которые никто не использует. Рабочая формула обратная: «У нас есть боль, поможет ли здесь LLM?»
Опыт «Синимекс» ценен именно тем, чем обычно не делятся: неудачами. Три кейса из четырёх описанных в 2023 году не взлетели, и это нормальная статистика для AI в разработке. По моим наблюдениям, большинство команд в РФ застревают на стадии «прототип работает, метрики нормальные», не задавая вопрос «а пользователь реально экономит время?». Формулу «считай стоимость проверки ответа, а не точность ответа» стоит повесить над монитором каждому, кто внедряет AI-функции. Честная оговорка: опыт одной компании не универсален. Размер команды, специфика продукта, бюджет на дообучение у всех разные. Но принцип «измеряй пользу для человека, а не для модели» переносится на любой масштаб.
Хотите разобраться, как AI меняет работу автора?
В dzen.guru мы тестируем нейросети на практике и показываем, что реально работает для контента, маркетинга и бизнеса в РФ.
Попробовать dzen.guruКейс «Синимекс» оставляет одну формулу, которая стоит всех четырёх экспериментов: если пользователь обязан перепроверить каждый ответ AI целиком, вы автоматизировали не работу, а иллюзию работы, и никакой рост F1 это не исправит.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google отправила свой ИИ-чип на орбиту: космические дата-центры потребуют 1800 запусков Starship
Google впервые отправила свой серверный чип в космос на борту ракеты SpaceX, запущенной из Калифорнии 5 июня, и начала практическую проверку идеи космических…
Нейросеть «Амазон» не пишет, а решает: модель на 2B параметров работает на ноутбуке бесплатно
Почему это важно Amazon выложила в открытый доступ компактную модель для принятия решений, которая работает локально и стоит в разы дешевле полноценных…
Суд отклонил иски к Google: антитраст не защитит издателей от ИИ-обзоров
Google платит издателям, но суд решил: ожидание трафика не равно договору, и антимонопольное право тут бессильно. Почему это важно Федеральный суд США впервые…
Комментарии