
Selectel протестировал AI-ускорители Zhenwu 810E: 1 536 ГБ памяти, но полная зависимость от Alibaba
Alibaba выпустила собственный AI-ускоритель Zhenwu 810E, и команда Selectel первой в России протестировала его для облачной инфраструктуры, столкнувшись с языковым барьером, отставанием библиотек и полной зависимостью от китайского вендора.
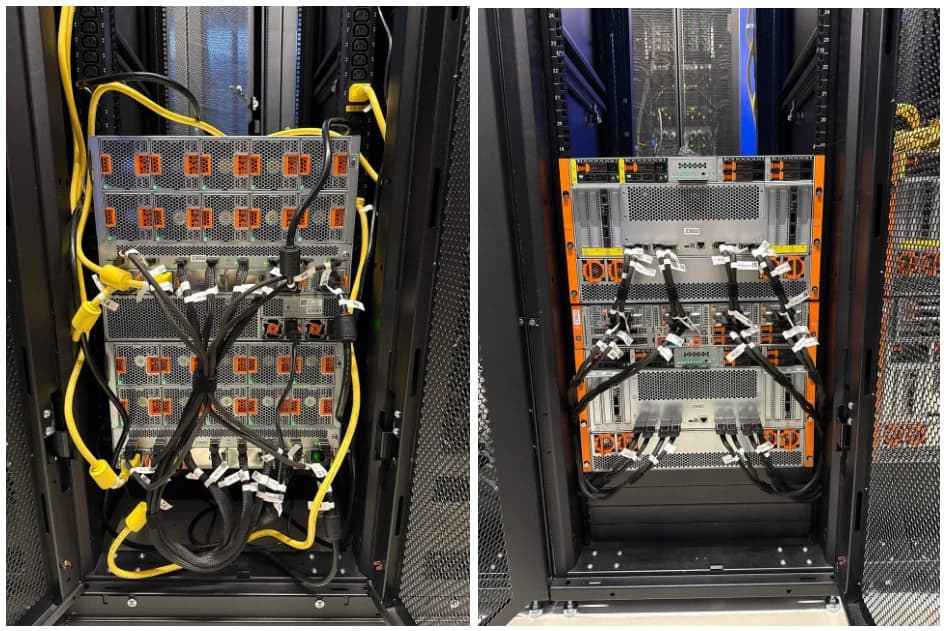
Российские облачные провайдеры ищут замену ускорителям NVIDIA, доступ к которым ограничен. Zhenwu 810E даёт 1 536 ГБ видеопамяти на сервер и поддерживает крупные модели вроде DeepSeek R1, но стек полностью зависит от одного разработчика, и это создаёт риски, которые стоит учитывать до покупки.
Selectel опубликовал подробный разбор тестирования AI-ускорителя PPU (Parallel Processing Unit, «параллельный процессор», отдельный класс ускорителей наряду с GPU и TPU) Zhenwu 810E от подразделения Alibaba, компании T-HEAD (Pingtou Ge Semiconductor). Материал написал Дмитрий, MLOps-инженер Selectel. Тестировали не ради обзора характеристик, а чтобы понять, можно ли встроить такой сервер в реальную облачную инфраструктуру: как ноду для Kubernetes или как выделенный сервер для инференса (запуска готовой модели на запросах пользователей).
Что внутри сервера?
Компания Chaitex предоставила Selectel AI-станцию с 16 ускорителями Zhenwu 810E. Каждый ускоритель оснащён:
- 96 ГБ памяти HBM2e (высокоскоростная память, как у серверных видеокарт NVIDIA)
- пропускной способностью памяти 2 765 ГБ/с (около 2,77 ТБ/с)
- интерфейсом PCIe 5.0 x16
- собственным межчиповым интерконнектом ICN с пропускной способностью до 700 ГБ/с на ускоритель
Суммарно на сервер приходится 1 536 ГБ видеопамяти. Этого хватает для запуска моделей с сотнями миллиардов параметров без разбиения на несколько серверов.
Сервер поставляется с предустановленной ОС, драйверами и UI-интерфейсом. Возможности сменить операционную систему Selectel не получил, хотя в документации есть ссылки на загрузку драйверов.
Что понадобится
- Доступ к AI-станции с Zhenwu 810E (поставляется через партнёров Alibaba, в данном случае через Chaitex)
- Учётные данные PTG PIP (выдаются вендором) для скачивания квантизованных (сжатых без критической потери качества) моделей
- Docker для работы с образами PPU SDK
- Терпение: документация на китайском, английская версия отстаёт по актуальности
- Время на ожидание портирования библиотек (от нескольких недель до неопределённого срока)
Пошаговая инструкция: как запустить модель на Zhenwu 810E
-
Получите доступ к серверу. AI-станция приходит с предустановленным стеком. Убедитесь, что драйверы PPU установлены и ускорители видны в системе. Для мониторинга PPU существуют аналоги привычных утилит NVIDIA, часть доступна прямо на сервере, часть внутри Docker-образа PPU SDK.
-
Скачайте Docker-образ PPU SDK. Весь портированный стек для инференса поставляется в виде собранного Docker-образа с конкретным тегом. Версии библиотек внутри образа фиксированы и отстают от актуальных. Какой именно образ использовать, смотрите в документации Alibaba Cloud Zhenwu PPU Service.
-
Загрузите квантизованную модель. T-HEAD выкладывает модели на китайской платформе Modelscope.cn (аналог Hugging Face, но на глобальной версии Modelscope.ai моделей T-HEAD нет). Внутри образа PPU SDK скачивание работает без дополнительной авторизации:
modelscope download --model T-HEAD/DeepSeek-V4-Flash-0731-W8A8-INT8 --local_dir deepseek
-
Выберите квантизацию. PPU поддерживает FP32, BF16 и FP16, а также схемы квантизации W8A8 (INT8), AWQ (W4A16) и GPTQ (W4A16, W8A16). Alibaba рекомендует для инференса схему W8A8: модель компактнее полновесной, при этом качество ответов падает некритично.
-
Запустите инференс-сервер. Используйте портированную версию vLLM (инференс-движок, который раздаёт запросы к модели) из Docker-образа. Учитывайте, что версия vLLM внутри образа отстаёт от актуальной.
-
Протестируйте на своих задачах. Прогоните типовые запросы и замерьте латентность и пропускную способность, прежде чем принимать решение о закупке.
Главная проблема: вендор-зависимость и отставание стека
Нативные библиотеки NVIDIA с PPU не работают. Хотя заявляется совместимость с исходниками CUDA-кода, эти исходники нужно перекомпилировать под PPU с помощью PPU SDK. Библиотеки PyTorch, Transformers, FlashAttention, vLLM и другие портирует команда T-HEAD.
На практике это означает: когда выходит новая модель или новая версия инференс-движка, приходится ждать, пока T-HEAD портирует обновление. По данным Selectel на 26 августа 2026 года, актуальная версия vLLM составляла v0.27.0, а актуальная сборка для PPU содержала vLLM v0.23.0. Разрыв в четыре версии, и сроки обновления не фиксированы.
Список моделей, для которых T-HEAD подготовила квантизованные веса с W8A8 (INT8):
- DeepSeek R1
- DeepSeek v3.2
- Kimi-K2-Instruct
- Qwen3-235B-A22B
- GLM-5
- MiniMax-M2.5
- Qwen3.5-397B-A17B
На Hugging Face T-HEAD не представлена. Модели в W8A8 там есть, но от неверифицированных источников.
Документация: языковой барьер на практике
Основная документация T-HEAD доступна на китайском языке и ориентирована на разработчиков SDK. С AI-станцией идёт русскоязычная инструкция, но она касается только работы через UI-интерфейс встроенной платформы Alibaba AI Stack.
Английская версия документации доступна на глобальном портале Alibaba Cloud, но только в предыдущей итерации. Актуальные материалы по PPU существуют только на китайской версии портала.
Что делать с этим прямо сейчас, по ролям
Авторам и копирайтерам на Дзене. Если пишете про AI-ускорители или обзоры железа, этот кейс Selectel даёт конкретный сценарий: что происходит, когда российская компания пытается интегрировать китайский чип. Факты из статьи (разрыв в версиях vLLM, языковой барьер, зависимость от вендора) годятся как примеры для материалов про импортозамещение.
Маркетологам. Если ваш продукт работает на инференсе крупных моделей в России, стоит отслеживать доступность Zhenwu 810E через партнёров Alibaba. Объём памяти позволяет запускать модели на сотни миллиардов параметров на одном сервере, но закладывайте в план риск задержек с обновлениями.
Предпринимателям и техническим директорам в РФ. Zhenwu 810E уже тестируется российским провайдером, значит, железо физически доступно. Но «доступно» и «готово к продакшену» не одно и то же. Перед закупкой уточните у поставщика: какая версия PPU SDK поставляется, есть ли портированные версии нужных вам библиотек, и кто будет заниматься поддержкой, когда выйдет новая модель, а T-HEAD ещё не обновил образ.
Selectel хотел запустить DeepSeek R1 через vLLM на PPU. Скачали Docker-образ PPU SDK, внутри обнаружили vLLM v0.23.0 при актуальной v0.27.0. Модель загрузили командой modelscope download без токенов авторизации. Инференс заработал, но часть функций актуального vLLM была недоступна. Документацию по настройке пришлось читать на китайском через машинный перевод, потому что английская версия на глобальном портале описывала предыдущую итерацию SDK.
Не ищите модели T-HEAD на Hugging Face. Официальных репозиториев там нет, а неверифицированные сборки от сторонних пользователей T-HEAD не поддерживает. Качайте с Modelscope.cn (китайская версия, не глобальная Modelscope.ai).
Не рассчитывайте на быструю миграцию с NVIDIA. CUDA-код формально совместим, но требует перекомпиляции через PPU SDK. Привычные инструменты (nvidia-smi, nvcc) не работают, у PPU свои утилиты.
Не ориентируйтесь на английскую документацию. Она отстаёт. Актуальные версии образов, списки поддерживаемых моделей и схемы квантизации публикуются сначала на китайском портале.
Не закладывайте жёсткие сроки обновления. Если вам критично запустить новую модель в день релиза, PPU пока не подходит: портирование занимает неопределённое время.
Selectel проделал полезную работу: показал не рекламный буклет, а реальный путь интеграции с конкретными препятствиями. По моим наблюдениям, для российского рынка AI-ускорителей это редкость: обычно мы видим либо маркетинговые характеристики, либо молчание.
Zhenwu 810E выглядит как серьёзная заявка по объёму памяти: 1 536 ГБ на сервер позволяют уместить модели, для которых на NVIDIA понадобилось бы несколько узлов. Но зависимость от T-HEAD в портировании библиотек и квантизации весов превращает выбор ускорителя в выбор экосистемы. Вы привязываетесь не просто к железу, а к темпу работы одной команды разработчиков.
Честная оговорка: это тестирование одного провайдера на одном сервере. Мы не видели результатов бенчмарков производительности (статья Selectel их пока не опубликовала), не знаем цену и условия поставки. Принимать решение о закупке на основе этих данных рано. Но изучить ограничения стека до покупки, а не после, стоит точно.
Хотите разбираться в ИИ-инструментах быстрее?
В dzen.guru мы тестируем нейросети и рассказываем, что реально работает для авторов и предпринимателей в России.
Подписаться на dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
JEPA-Anything: универсальные нейросети для 7 областей вместо отдельных моделей
Почему это важно Одна архитектура обучения заменяет отдельные модели для семи разных областей и улучшает результаты на всех десяти задачах динамики, по которым…
Мультимодальная нейросеть Reka Rho-1 на 19 млрд параметров заменяет конвейер моделей одной архитектурой
Компания Reka представила исследовательский превью Rho-1, мультимодальной нейросети на 19 миллиардов параметров, которая читает и создаёт текст, изображения,…
Together Link подключает Claude Code AI к открытым моделям: экономия до 80% на токенах
Компания Together AI выпустила Together Link, бесплатную утилиту командной строки с открытой лицензией MIT, которая позволяет подключать шесть популярных…
Комментарии