
JEPA-Anything: универсальные нейросети для 7 областей вместо отдельных моделей
Почему это важно Одна архитектура обучения заменяет отдельные модели для семи разных областей и улучшает результаты на всех десяти задачах динамики, по которым…
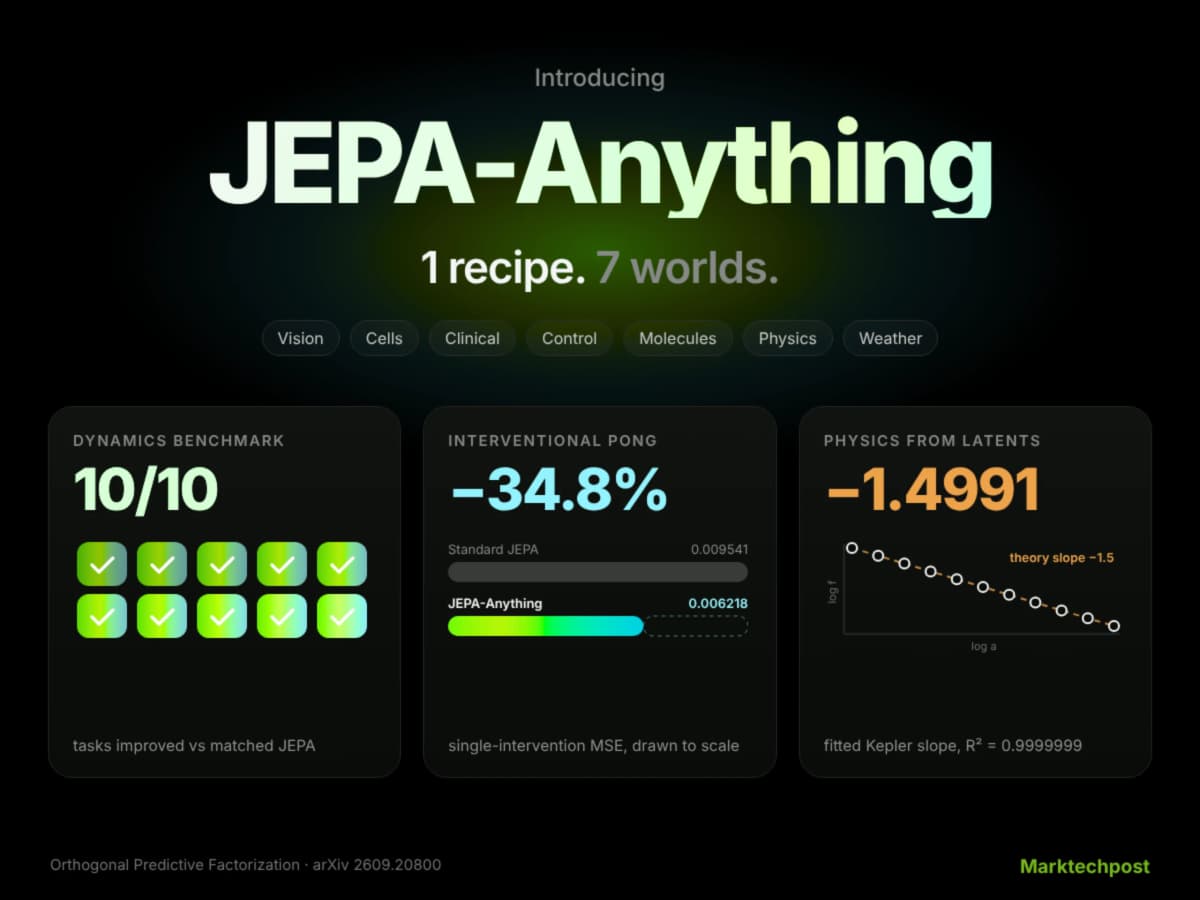
Одна архитектура обучения заменяет отдельные модели для семи разных областей и улучшает результаты на всех десяти задачах динамики, по которым её сравнивали с предшественниками.
Группа исследователей из PhAI Labs, Китайского университета Гонконга (CUHK), Фуданьского университета, Стэнфорда, Оксфорда и Принстона представила JEPA-Anything, открытый фреймворк для построения так называемых моделей мира, который работает одинаково в семи областях, от компьютерного зрения и молекулярной динамики до прогноза погоды и клинических данных, без переделки архитектуры под каждую задачу.
Для тех, кто не следит за аббревиатурами: JEPA (Joint-Embedding Predictive Architecture) переводится как «архитектура совместных вложений с предсказанием». Это способ обучения нейросети, при котором модель учится предсказывать скрытое представление данных, а не пиксели или символы напрямую. До сих пор каждую область приходилось адаптировать отдельно. JEPA-Anything предлагает единый рецепт.
| Показатель | Значение | Источник |
|---|---|---|
| Число областей тестирования | 7 (зрение, биология, клинические траектории, управление, молекулярная динамика, физические поля, погода) | Статья JEPA-Anything |
| Улучшение на задачах динамики | Все 10 из 10 задач с подобранными параметрами | Статья JEPA-Anything |
| Снижение ошибки (Interventional Pong, одиночная интервенция) | 34,83% | Статья JEPA-Anything |
| Кластеризация клеток (AvgBIO, zero-shot PBMC) | 0,7752 против 0,7194 у Cell-JEPA | Статья JEPA-Anything |
| Прогноз клинических событий (mean PRAUC, UK Biobank) | 0,718 против 0,711 у стандартной JEPA | Статья JEPA-Anything |
| Снижение ошибки на APEBench Burgers (6-шаговый прогноз) | около 44,7% | Статья JEPA-Anything |
| Лицензия кода | Apache-2.0 | GitHub JEPA-Anything |
Какую проблему решает JEPA-Anything?
Стандартная JEPA, например I-JEPA или V-JEPA 2, использует один предиктор, который выдаёт одно «монолитное» скрытое представление цели. Проблема в том, что сильные сигналы в данных (то, что меняется больше всего) забирают на себя всю ёмкость модели, а слабые, но важные закономерности получают противоречивые градиенты (сигналы обучения, которые тянут модель в разные стороны). Исследователи называют это «проблемой распределения ёмкости».
Решение называется OPF (Orthogonal Predictive Factorization, ортогональная предиктивная факторизация). Если совсем просто: вместо одного большого предсказания модель делает несколько маленьких, каждое в своём «подпространстве», и эти подпространства математически не пересекаются. В большинстве экспериментов таких факторов четыре (K = 4).
Три регуляризатора (штрафных функции) удерживают систему от деградации: один не даёт подпространствам слипаться, второй не даёт отдельным факторам «замолчать», третий не даёт энкодеру (кодировщику входных данных) схлопнуться. Вся эта дополнительная функция потерь просто прибавляется к стандартной функции потерь каждой конкретной области.
Насколько это стабильно? На тесте CITRIS Interventional Pong модель без ортогональности показала число обусловленности 438,52 (чем выше, тем хуже и нестабильнее), а ортогональная версия дала 1,00005, то есть практически идеальную устойчивость.
Что обнаружили?
Результаты разбиты на три группы.
Группа I: конечные предсказания.
- Кластеризация одиночных клеток (AvgBIO) выросла до 0,7752 против 0,7194 у Cell-JEPA.
- Корреляция Пирсона на данных Norman perturbation поднялась с 0,787 до 0,814.
- Прогнозирование более 1 000 клинических событий на базе UK Biobank (крупнейшая биомедицинская база Великобритании) дало mean PRAUC 0,718 против 0,711 у стандартной JEPA.
Группа II: динамика скрытых состояний.
- На Interventional Pong ошибка при одиночной интервенции снизилась на 34,83%, при комбинированных невиданных интервенциях на 12,90%, а шестишаговый свободный прогноз улучшился на 8,58%.
- Улучшения зафиксированы на всех десяти задачах динамики, включая бенчмарки CausalWorld, DeepMind Control, PDEBench и WeatherBench2.
- На APEBench Burgers ошибка шестишагового прогноза упала примерно на 44,7%.
- На 100-шаговых молекулярных симуляциях модель показала лучший MAE и RMSD на четырёх веществах: вода, кварц, парацетамол и бензол.
Группа III: научный анализ.
- Факторный анализ выявил комбинацию блокады IL-18 и CD73 как потенциальную противоопухолевую интервенцию. Лабораторные тесты подтвердили результат на клеточных ко-культурах, органоидах пациентов, фрагментах опухолей и мышах.
- Латентные орбитальные моды воспроизвели закон Кеплера: подобранный наклон составил минус 1,4991 при теоретическом минус 1,5.
Честная оговорка: в задачах планирования результаты неоднозначны. На Walker2d и HalfCheetah JEPA-Anything обошла стандартную JEPA при совпадении параметров с точностью до 0,3%, но на Hopper стандартная JEPA оказалась лучше.
Все сравнения сделаны с «подобранными базовыми моделями» (matched baselines), то есть исследователи следили, чтобы число параметров совпадало. Однако Hopper показал, что универсальный подход не побеждает везде. Клиническая задача (UK Biobank) дала прирост PRAUC лишь на 0,007, разница, которую стоит оценивать осторожно. Экспериментальная валидация противоопухолевой комбинации проведена на доклиническом уровне (лаборатория и мыши), до человека далеко. Код выложен под Apache-2.0, но обученные чекпоинты (готовые веса модели) размещены на Hugging Face и требуют проверки лицензий конкретных данных каждой области.
Что это значит для вас?
Автору Дзена и копирайтеру. Универсальные нейросети типа JEPA-Anything пока не выдают текст или картинки напрямую. Но направление важно: если один фреймворк справляется с семью областями, через год-два инструменты для контента (генерация, редактура, анализ аудитории) перестанут быть «затычками» под одну задачу. Следите за тем, как мультимодальный подход просачивается в продуктовые модели.
Маркетологу. Предиктивные модели мира на клинических и молекулярных данных пока далеки от рекламных бюджетов, но экономика обучения меняется: одна архитектура вместо семи отдельных означает снижение стоимости и сроков разработки. Когда подобный подход дойдёт до прогнозирования поведения пользователей (а направление именно туда), переобучать модель под новый сегмент станет дешевле.
Исследователю и инженеру в России. Код открыт, лицензия Apache-2.0, чекпоинты лежат на Hugging Face. Архитектура напрямую применима к задачам, где нужен предиктивный фреймворк без переделки: медицинское прогнозирование (аналог UK Biobank есть в некоторых российских биобанках), прогноз погоды, молекулярное моделирование. Из доступных в РФ инструментов для схожих задач обучения можно использовать серверы с GPU через облака «Яндекса» и SberCloud, но архитектурных аналогов JEPA-Anything в открытом доступе на русскоязычном рынке пока нет.
Универсальные нейросети, работающие в нескольких областях без переделки, я считаю одним из самых недооценённых направлений. Мы привыкли к «одна задача, одна модель», а здесь единый рецепт обучения, и он реально работает на десяти из десяти задач динамики. Да, на планировании результат неровный, Hopper это показал. Да, клинический прирост в 0,007 PRAUC скромный. Но сам факт, что одна и та же ортогональная факторизация улучшает и прогноз погоды, и молекулярные симуляции, и данные биобанка, говорит о том, что фреймворк устойчив, а не подогнан. Для практиков в РФ это повод взять код и попробовать на своих данных, пока подход ещё не упакован в коммерческий продукт.
Если вы работаете с предиктивными задачами в любой области, от медицины до физики, попробуйте применить OPF-факторизацию к своей стандартной JEPA-архитектуре: код открыт, функция потерь добавляется одной строкой, а условное число на Interventional Pong упало с 438 до единицы, и это аргумент сильнее любого маркетингового обещания.
По данным Marktechpost

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Мультимодальная нейросеть Reka Rho-1 на 19 млрд параметров заменяет конвейер моделей одной архитектурой
Компания Reka представила исследовательский превью Rho-1, мультимодальной нейросети на 19 миллиардов параметров, которая читает и создаёт текст, изображения,…
Together Link подключает Claude Code AI к открытым моделям: экономия до 80% на токенах
Компания Together AI выпустила Together Link, бесплатную утилиту командной строки с открытой лицензией MIT, которая позволяет подключать шесть популярных…
Selectel протестировал AI-ускорители Zhenwu 810E: 1 536 ГБ памяти, но полная зависимость от Alibaba
Alibaba выпустила собственный AI-ускоритель Zhenwu 810E, и команда Selectel первой в России протестировала его для облачной инфраструктуры, столкнувшись с…
Комментарии