
Мультимодальная нейросеть Reka Rho-1 на 19 млрд параметров заменяет конвейер моделей одной архитектурой
Компания Reka представила исследовательский превью Rho-1, мультимодальной нейросети на 19 миллиардов параметров, которая читает и создаёт текст, изображения, видео и даже управляет роботами в одном контексте.
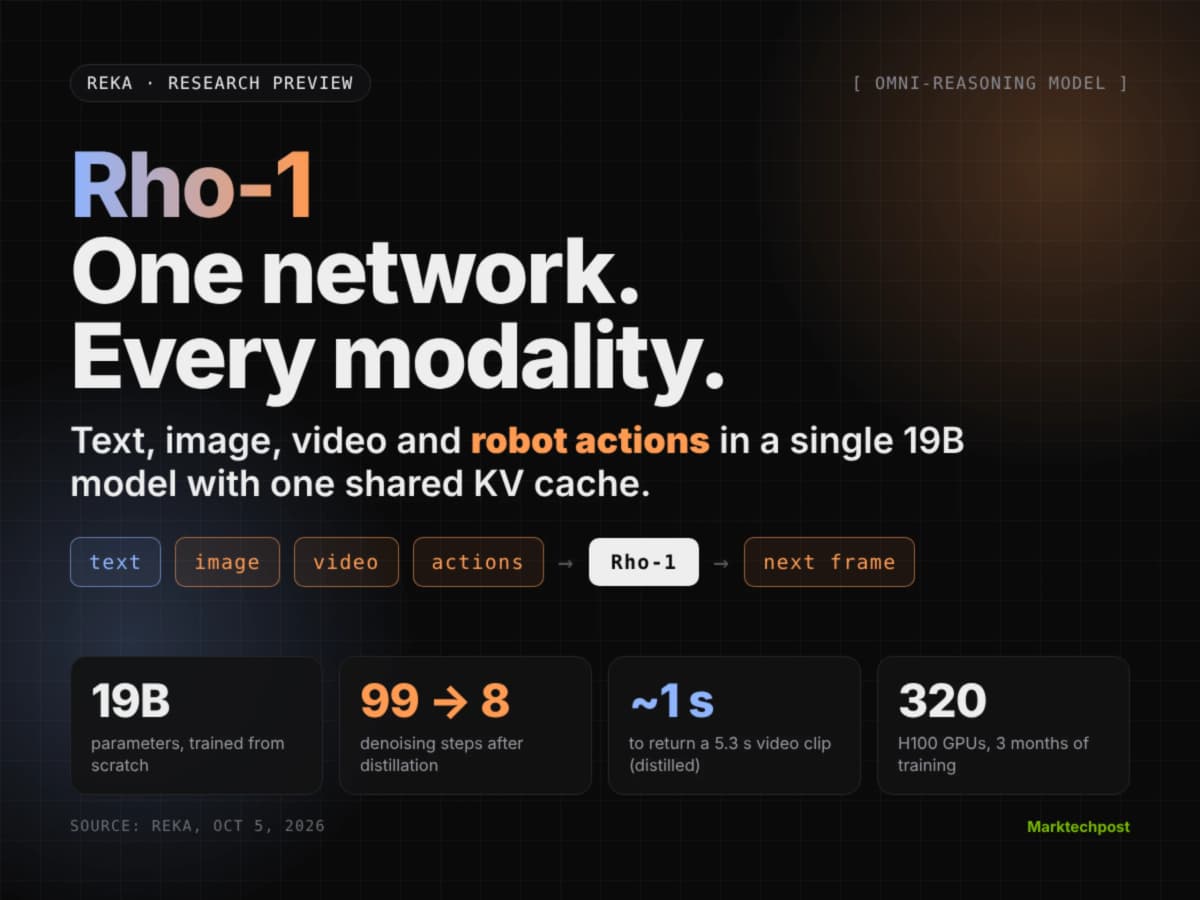
Rho-1 заменяет цепочку из нескольких узкоспециализированных моделей единой архитектурой: вместо передачи задач между отдельными нейросетями для текста, картинок и видео всё происходит внутри одной модели, что убирает задержки на каждом стыке.
До сих пор мультимодальные системы (нейросети, способные работать сразу с несколькими типами данных: текстом, картинками, видео) строились как конвейеры. Центральная модель планировала, а затем раздавала задания узким специалистам: один модуль рисовал картинку, другой монтировал видео, третий распознавал объекты. Каждая передача добавляла время, а каждый «специалист» видел только свой кусочек задачи. Reka заявляет, что Rho-1 убирает эти стыки. Об этом компания сообщила в техническом отчёте и анонсе на платформе X.
| Показатель | Значение | Источник |
|---|---|---|
| Число параметров | 19 млрд | Reka (техотчёт) |
| Обучение | 320 GPU H100, 3 месяца | Reka (техотчёт) |
| Максимальное разрешение видео | 672 × 384 пикселя | Reka (техотчёт) |
| Скорость генерации видео (базовая модель) | 0,79x от реального времени (медиана) | Reka (внутренние тесты) |
| Время до первого клипа (базовая) | 7,0 секунд | Reka (внутренние тесты) |
| Время до первого клипа (дистиллированная) | около 1 секунды (клип 5,3 с) | Reka (внутренние тесты) |
| Шаги удаления шума: базовая / дистиллированная | 99 / 8 | Reka (техотчёт) |
| Публичный доступ | Нет: ни открытых весов, ни API, ни цен | Reka (техотчёт) |
Как устроена Rho-1 без научного жаргона?
Любой вход и выход модель переводит в один из двух форматов токенов (минимальных единиц информации, с которыми работает нейросеть):
- Дискретные токены несут текст, логические рассуждения и команды высокого уровня.
- Непрерывные токены несут изображения, видеокадры, действия робота и данные о его положении в пространстве.
Внутри каждого блока трансформера (базового вычислительного элемента модели) работают два экспертных потока. Первый отвечает за понимание: разбирает язык и картинку. Второй отвечает за генерацию: превращает внутреннее представление в готовые пиксели или видео. Оба потока делят общее «внимание» и единый KV-кэш (память, где модель хранит контекст разговора).
Когда ответ требует картинки, поток понимания выдаёт специальный токен-переключатель, и поток генерации рисует результат, опираясь на весь накопленный контекст. Рамки объектов на изображении выходят в виде координатных токенов, без отдельного детектора. Первый кадр видео переиспользует уже загруженное изображение, а не кодирует его заново.
Что обнаружили?
- Один сеанс без внешних вызовов. По данным Reka, модель за 5 шагов нарисовала маяк, выделила его рамкой, анимировала, переделала видео в снежную бурю и объяснила разницу. Без обращения к сторонним инструментам и без второй модели.
- Базовая модель выдаёт видео за 7 секунд. Для сравнения: конвейер из нескольких моделей в тесте Reka показал 13,8 секунды до первого клипа. Это внутренние тесты компании, не независимый бенчмарк.
- Дистилляция (упрощение модели с сохранением качества) ускоряет в разы. Число шагов удаления шума сокращено с 99 до 8, при этом Reka сообщает о минимальной потере качества. Клип длиной 5,3 секунды генерируется примерно за секунду.
- Робототехника из той же модели. В симуляции LIBERO модель выдаёт 7 каналов управления роботом. Действия и будущие кадры декодируются из одного внутреннего состояния.
- Потоковая генерация видео. Rho-1 выдаёт клип за клипом непрерывно. Новые инструкции поступают прямо в поток понимания и меняют поведение на лету: компания демонстрирует, как один начальный кадр разветвляется на «поворот налево» и «поворот направо».
Все цифры скорости и качества получены во внутренних тестах Reka, а не в независимых измерениях. Сравнение с «конвейерным подходом» (13,8 секунды) носит иллюстративный характер: компания не раскрывает, какой именно конвейер использовался. Модель доступна только как исследовательский превью: нет ни открытых весов, ни API, ни цен. Разрешение видео ограничено 672 × 384 пикселями. Для робототехники данные получены в симуляции, а не на физическом оборудовании.
Что это значит для вас?
Разработчикам ИИ-агентов в России. Rho-1 показывает направление: переход от многомодельных конвейеров (агентный подход, где ИИ-агент вызывает отдельные модели для текста, видео и действий) к единой архитектуре. Если ваш агент сейчас передаёт задачи между GPT для текста, отдельной моделью для картинок и ещё одной для видео, каждая передача добавляет задержку и теряет контекст. Единая мультимодальная нейросеть снимает обе проблемы. Пока Rho-1 закрыта, но сам подход стоит учитывать при проектировании систем.
Авторам Дзена и контент-маркетологам. Практического инструмента для работы здесь пока нет: ни API, ни интерфейса. Но направление понятно: скоро мультимодальная нейросеть в одном окне сможет написать сценарий, нарисовать обложку, сгенерировать ролик и объяснить, чем один вариант лучше другого. Следите за появлением доступных аналогов.
Из доступных в РФ инструментов для мультимодальных задач можно использовать YandexGPT (текст и изображения) и GigaChat (текст), но ни один из них пока не объединяет текст, видео и управление роботами в одном контексте.
Reka пока небольшой игрок по сравнению с OpenAI или Google, и Rho-1 остаётся исследовательским превью без публичного доступа. Но я вижу здесь важный сдвиг: индустрия движется от «оркестра специалистов» к «одному универсальному музыканту». Для тех, кто строит агентные системы, это сигнал пересмотреть архитектуру. Для авторов и маркетологов, повод запомнить термин «единая мультимодальная модель»: через год-два именно такие системы, скорее всего, будут генерировать контент от текста до видео в одном запросе. Главная оговорка: все цифры Reka показала сама, и пока независимые тесты их не подтвердят, относиться к ним стоит как к заявке, а не к доказательству.
Reka показала, что 19 миллиардов параметров хватает, чтобы объединить текст, картинки, видео и робототехнику в одной модели. Пока это закрытый превью без доступа, но архитектурный подход «два потока, один кэш» уже можно изучать по техотчёту и примерять к собственным проектам.
По данным Reka (техотчёт и анонс на X).

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
JEPA-Anything: универсальные нейросети для 7 областей вместо отдельных моделей
Почему это важно Одна архитектура обучения заменяет отдельные модели для семи разных областей и улучшает результаты на всех десяти задачах динамики, по которым…
Together Link подключает Claude Code AI к открытым моделям: экономия до 80% на токенах
Компания Together AI выпустила Together Link, бесплатную утилиту командной строки с открытой лицензией MIT, которая позволяет подключать шесть популярных…
Selectel протестировал AI-ускорители Zhenwu 810E: 1 536 ГБ памяти, но полная зависимость от Alibaba
Alibaba выпустила собственный AI-ускоритель Zhenwu 810E, и команда Selectel первой в России протестировала его для облачной инфраструктуры, столкнувшись с…
Комментарии