
RTX 5070 Ti против 11 российских облаков: локальная модель не уступила и обошлась в 37 раз дешевле
Компания или частный автор не привлекала инвестиции, а провела независимое сравнение локальной видеокарты с российскими облачными провайдерами ИИ, поэтому архетип funding здесь не применим напрямую. Строю новость по фактам из источника как практический бенчмарк с экономикой.
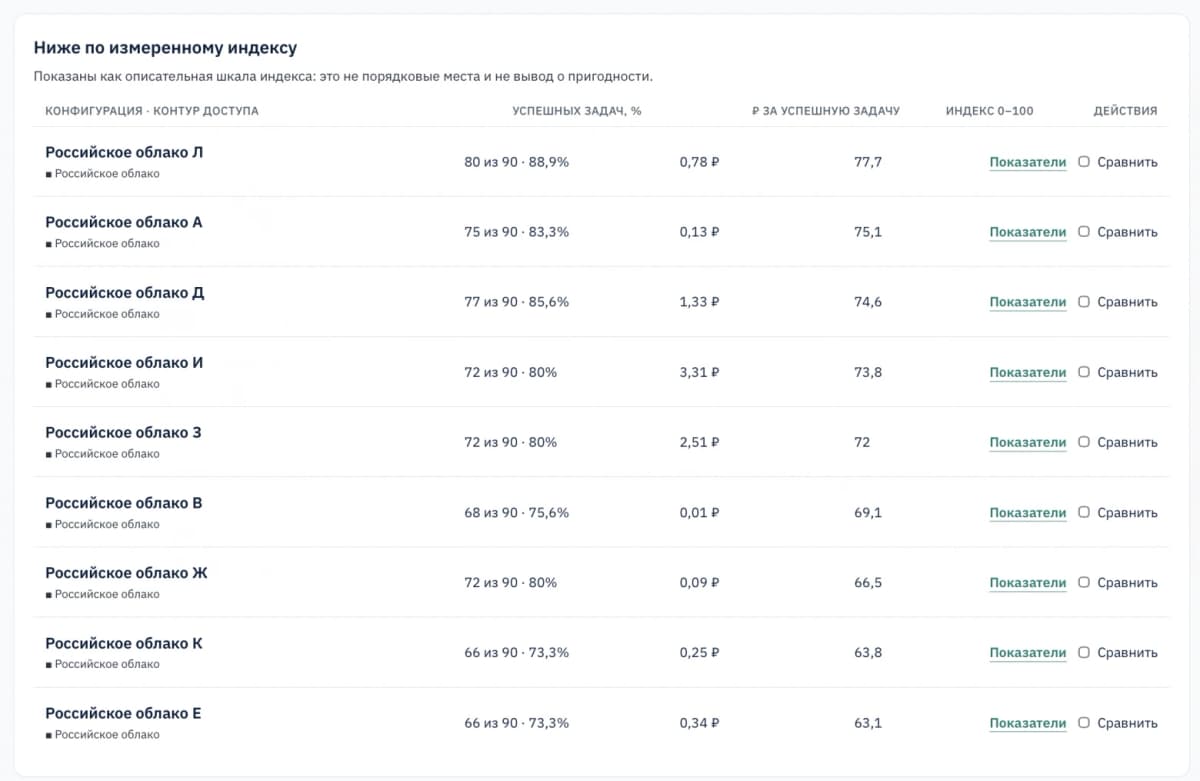
Автор dzen.guru Игорь Градов с 8 по 10 октября 2026 года замерил, как одна потребительская видеокарта RTX 5070 Ti справляется с реальными задачами на русском языке в сравнении с одиннадцатью российскими облачными провайдерами, и обнаружил, что домашний сервер не уступает облаку ни по качеству, ни тем более по цене.
Впервые опубликован сквозной бенчмарк, где локальная модель на одной видеокарте сопоставлена с российскими облаками по единой методике, с рублёвыми ценами и порогом статистического шума, а не маркетинговыми рейтингами.
Тесты проводились на двух наборах задач: 30 публичных синтетических (с использованием инструментов) и 50 закрытых русскоязычных письменных. Каждая задача прогонялась трижды, а не один раз. Автор пробовал единичные прогоны ради экономии, но столкнулся с разбросом до 0,9 балла в других тестах и вернулся к тройному замеру. Разница до 4,3 пункта индекса остаётся в пределах шума, то есть не позволяет говорить, что одна модель лучше другой.
Цены указаны в рублях с НДС 22% при сценарии 50% кэша (кэш, это когда система запоминает часть запроса и не пересчитывает его заново, экономя деньги). Стоимость «судей», оценивающих качество ответов, в записях не учтена.
Что показала домашняя карта?
Qwen3.8-27B в формате IQ3 (компактная квантизация, то есть сжатие модели для работы на обычной видеокарте) на RTX 5070 Ti выдала индекс качества 82,3 из 100, успех на задачах 91,1% и скорость 68,3 токена в секунду при контексте 131 тысяча токенов (токен, это минимальная единица текста, которую обрабатывает модель, примерно 3/4 слова на русском).
Для сравнения: две ближайшие облачные строки, «Российское облако Б» с индексом 84,0 и «Российское облако Г» с индексом 84,3, отстоят от Qwen всего на 1,7 и 2,0 пункта. Это не выходит за порог шума. По методике автора, такую разницу нельзя превращать в вывод «облако лучше».
Вторая локальная модель, Gemma, получила индекс 78,0 и скорость 94,4 токена в секунду. Четыре облачных кода (Л, А, Д и И с индексами от 73,8 до 77,7) тоже укладываются в зону шума относительно Gemma.
Рубли решают не всё, но считать их стоит
| Модель / провайдер | Индекс качества | Цена за успешную задачу | Примечание |
|---|---|---|---|
| Qwen (RTX 5070 Ti, локально) | 82,3 | 0,09 ₽ | Включает амортизацию карты и электричество |
| Российское облако В | 69,1 | 0,01 ₽ | Самая дешёвая строка, индекс ниже на 13,2 пункта |
| Gemma (RTX 5070 Ti, локально) | 78,0 | 0,03 ₽ | Быстрее Qwen, но индекс ниже |
| Российское облако И | 73,8 | 3,31 ₽ | В 37 раз дороже Qwen при индексе ниже на 8,5 пункта |
Самое дешёвое облако (0,01 ₽ за задачу) проигрывает локальной Qwen больше 13 пунктов индекса. Самое дорогое облако (3,31 ₽) стоит в 37 раз больше Qwen и при этом уступает ей по качеству. Автор прямо ставит вопрос: «Что бы вы выбрали?»
Цена локальной Qwen включает не облачный тариф, а учётную стоимость видеокарты, электричество и амортизацию. При этом автор отмечает, что его реальный процент использования кэша составляет 97%, а не 50%, как в расчёте. Часть провайдеров, по его наблюдению, вообще не выделяют кэш отдельной строкой в прайсе.
Закрытый набор задач: зачем свой бенчмарк?
50 русскоязычных письменных задач автор не публикует. Открыт только хэш (цифровой отпечаток, подтверждающий, что набор не менялся задним числом) и методика. В публичном репозитории лежат лишь 30 синтетических задач.
На письменном наборе Qwen показала 84,7% успеха и индекс 77,0. Ближайшее облако («Российское облако Б») получило 79,3% и индекс 70,0. Разница в 7 пунктов уже выходит за порог шума, это статистически значимый отрыв в пользу локальной модели.
Почему так? Автор допускает, что домашний сервер позволяет тоньше настроить модель под свои задачи, чего облачный API (программный интерфейс, через который приложение общается с моделью) обычно не даёт.
Где локальная карта проигрывает?
При нагрузочном тесте Gemma выдержала 1, 2, 4 и 8 одновременных потоков по 32 тысячи токенов на слот. Qwen при 4 потоках и 32 тысячах токенов получила ошибку CUDA out-of-memory (нехватка видеопамяти). Одна карта подходит для одного потока, но не для параллельной работы нескольких пользователей. Подробности автор обещает в третьей части серии.
Автор также предупреждает: результат относится к конкретным версиям моделей и настройкам на дату замера и не описывает поставщика целиком.
Я честно думал, что облако будет сильно лучше того, что я могу крутить дома, но не тут-то было. : Автор бенчмарка
Что это значит для вас по ролям?
Автору Дзена и копирайтеру. Если вы пишете тексты и используете ИИ для редактуры, генерации черновиков или проверки фактов, одна видеокарта за условные 70 тысяч рублей (розничная цена RTX 5070 Ti на момент публикации) способна обрабатывать задачи с качеством на уровне облачных сервисов. При высокой загрузке экономия измеряется десятками раз.
Маркетологу. Облачные провайдеры не обязательно предлагают лучшее качество за большие деньги. Прежде чем подписывать контракт с облаком, стоит прогнать свои задачи локально и сравнить индекс, а не верить маркетинговым таблицам.
Предпринимателю в РФ. Все протестированные облака, российские, доступные без VPN и санкционных ограничений. Глобальные модели автор намеренно вынес в отдельную статью: здесь только то, что можно официально подключить в России. Локальная альтернатива не требует даже облака, данные не покидают ваш компьютер.
Этот бенчмарк интересен не абсолютными числами, а подходом. Автор не просто запустил модель и восхитился, он выстроил методику с порогом шума, тройным прогоном и рублёвой экономикой. По моим наблюдениям, большинство «сравнений моделей» в русскоязычном пространстве не дотягивают до такого уровня прозрачности: ни хэшей, ни открытых задач, ни учёта амортизации оборудования. Ограничение очевидно: одна карта не заменит облако для команды из пяти человек. Но для соло-автора или маленькой студии, которая обрабатывает задачи последовательно, а не параллельно, локальный вариант экономит деньги и держит данные при себе. Я бы рекомендовал дождаться второй и третьей частей серии, прежде чем принимать решение о миграции с облака: автор обещает разбор исправленного контракта инструмента и нагрузочные тесты.
Сценарий 50% кэша, на котором построены рублёвые расчёты, может не совпадать с вашим профилем нагрузки. Автор указывает, что его реальный кэш составляет 97%, значит, его фактические затраты ещё ниже, но ваши могут быть выше. Имена облачных провайдеров пока скрыты за кодами: сравнить конкретные сервисы до раскрытия невозможно.
Для тех, кто работает с нейросетями в России, главный практический вывод прост: не верьте, что облако автоматически лучше домашнего железа, проверяйте на своих задачах, считайте в рублях и требуйте от провайдера прозрачных цен на кэш.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Codex потерял дракона: переносим легендарный текстовый квест в Telegram без кодинга
Иногда лучший способ понять, на что способен ИИ, это дать ему задачу с известным правильным ответом и посмотреть, где он соврёт. Почему это важно Автор собрала…
Что такое ИИ-агент для кода и где его взять в РФ: 18 продуктов, 12 бесплатных
Почему это важно 4 сентября 2026 года Cursor отрезал пользователей из России от агента и автодополнения за один день. Вопрос «что такое ИИ-агент для кода и где…
Пилот, который сам собирает себе разметку: как запустить ИИ в закупках без полугода ожидания
Когда ИИ нужно научить ловить аномалии в закупках, первой проблемой становится не сама модель, а разметка: никто заранее не отмечал, где была переплата, а где…
Комментарии