
Пилот, который сам собирает себе разметку: как запустить ИИ в закупках без полугода ожидания
Когда ИИ нужно научить ловить аномалии в закупках, первой проблемой становится не сама модель, а разметка: никто заранее не отмечал, где была переплата, а где норма, и ждать полгода, пока накопится история, бизнес не готов.
Алексей, руководитель ML-направления, описал подход, при котором пилот на правилах одновременно работает и копит обучающие данные для будущей модели: не нужно замораживать проект на месяцы ради сбора разметки.
Тема поднята в практическом разборе на Хабре. Автор показывает конкретный кейс из контроля закупок: поиск завышенных цен, дублей и заявок без тендерной процедуры. Проблема знакома любому, кто пытался запустить supervised-модель (модель, которая учится на размеченных примерах) там, где размеченных примеров попросту нет. Алексей предлагает не ждать, а развернуть пилот, который сам собирает себе разметку в ходе работы.
Почему нельзя просто взять готовую модель?
Автор перебирает три стандартных пути и объясняет, почему каждый буксует именно в задаче контроля закупок.
- Supervised-обучение (обучение с учителем, когда модель учится на примерах с правильными ответами) не на чем запускать: исторической разметки не существует.
- Unsupervised-подход (обучение без учителя, когда модель сама ищет закономерности) на редких событиях выдаёт слишком много ложных срабатываний.
- LLM (большая языковая модель, например ChatGPT или YandexGPT) без эталона рыночной цены уверенно называет завышенную цену нормальной, то есть галлюцинирует (выдумывает факт, которого нет).
Вывод Алексея: сначала слой на правилах, модель подключается сверху и позже.
Журнал как главный элемент пилота
Центральный артефакт такого пилота, который сам собирает себе разметку, не алгоритм и не набор правил, а журнал. Правила отбирают подозрительные заявки, экономист выносит по каждой вердикт, а система записывает событие.
Каждая запись содержит:
- идентификатор заявки и позиции
- какое правило сработало
- значения признаков на момент срабатывания: сумма, остаток на складе, флаг превышения тендерного порога, канал заявки, наличие регистрационного номера
- вердикт экономиста: подтвердить, вернуть, отклонить
- причина (обязательна при отклонении)
- итог: оплачено, возвращено, переоформлено
Пара «признаки плюс вердикт» и есть размеченный пример, на котором потом учится модель. А сумма по отклонённым позициям с причинами даёт первую в истории компании оценку предотвращённых потерь. Один объект закрывает две задачи сразу.
Аргументы за: почему подход работает?
Не нужно ждать эталона цены. На старте включаются правила, которым рыночная цена вообще не требуется: дубль закупки (позиция уже на складе в 1С), превышение тендерного порога без процедуры, заявка без регистрационного номера. Каждое срабатывание плюс вердикт экономиста ложится в журнал готовым лейблом (меткой, по которой модель отличает норму от аномалии).
Разрывается замкнутый круг. Классическая проблема «курица или яйцо»: чтобы обучить модель, нужна разметка, а чтобы собрать разметку, нужна работающая система. Пилот на правилах генерирует и пользу, и данные одновременно.
Пилот приносит пользу с первого дня. Пока разметка копится, правила уже ловят реальные аномалии. Алексей приводит будничный пример: снабженец приносит счёт на топливный фильтр, а фильтр уже лежит на складе под другим названием в 1С. Правило ловит это сверкой с остатками, экономист возвращает заявку. Строчка «есть на складе, брать не нужно» становится лейблом для будущей модели.
Аргументы против: где подвох?
Слепое пятно правил. Если в журнал попадает только то, что подняли правила, модель видит подозрительное, но никогда не видит заявку, мимо которой правило прошло молча. В лучшем случае она научится точнее отсекать уже пойманное, но не найдёт новое.
Решение есть, но оно платное: к потоку флажков подмешивается случайная выборка обычных заявок, экономист размечает и их тоже. Это часть экономии времени, ради которой всё затевалось, то есть прямые затраты ресурса.
Дисбаланс классов. Злоупотребления редки, в случайной выборке позитивных примеров почти не будет. Обучение детектора на таком перекосе (когда аномалий единицы на тысячи нормальных записей) отдельная задача, которую придётся решать уже на стороне модели.
Человек остаётся слабым звеном. Если экономист под нагрузкой начинает жать «подтверждаю» не глядя, журнал наполняется шумом, и модель потом выучивает этот шум. Алексей упоминает меры контроля: обязательная причина при отклонении, аудит-выборка решений, метрика доли «подтверждено без комментария» по каждому проверяющему. Но эти меры добавляют ещё один слой процесса.
Запускаться можно, не дожидаясь, пока эталон рыночной цены появится. Разметку отлично копят правила, которым эталон на старте не нужен вовсе. : Алексей, руководитель ML-направления
Что делать с этим прямо сейчас, по ролям?
Автору на Дзене и копирайтеру. Принцип «пилот, который производит разметку сам» переносится на контент. Если вы запускаете рубрику или формат и не знаете, что зайдёт, начните с простых правил (тема, объём, подача), фиксируйте реакцию аудитории в таблице, и через два-три месяца у вас будет размеченный набор «что сработало, а что нет» для осознанного эксперимента с нейросетями.
Маркетологу и аналитику. Подход применим к любой задаче, где нет исторической разметки: фрод в рекламных кампаниях, аномалии в CRM, контроль расходов. Не ждите идеальной модели, разверните правила, поставьте журнал, начните копить данные.
Предпринимателю в РФ. Все инструменты, которые описывает Алексей, локальны: 1С, внутренние базы, российские реалии закупок. Для реализации подобного пилота не нужны зарубежные сервисы, достаточно штатного аналитика, 1С и базовой автоматизации на Python.
Подход Алексея подкупает честностью: он не обещает магию нейросетей на старте, а показывает, как дойти до модели, не останавливая работу. По моим наблюдениям, большинство ML-проектов в российских компаниях застревают именно на этапе «а где взять разметку», и команда уходит в полугодовую подготовку данных, после которой бюджет заканчивается раньше, чем появляется результат. Пилот на правилах с журналом решает эту проблему элегантно, но оговорка необходима: качество разметки целиком зависит от дисциплины экономиста. Один уставший проверяющий, который неделю жмёт «ок» не глядя, может испортить месяц данных. Если вы думаете о подобном проекте, начните с трёх формальных правил, которые не требуют эталона, и заведите журнал хотя бы в Google Sheets. Это уже половина пути.
Ценовое правило, по словам Алексея, подключается позже, когда накоплены ориентиры, и к тому моменту у команды уже есть и работающий контроль, и месяцы разметки. Для тех, кто давно откладывал внедрение ИИ в бизнес-процессы из-за отсутствия данных, этот разбор даёт конкретный маршрут: развернуть правила, поставить журнал, начать копить лейблы на живом потоке, а модель подключить, когда данные дозреют.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Codex потерял дракона: переносим легендарный текстовый квест в Telegram без кодинга
Иногда лучший способ понять, на что способен ИИ, это дать ему задачу с известным правильным ответом и посмотреть, где он соврёт. Почему это важно Автор собрала…
Что такое ИИ-агент для кода и где его взять в РФ: 18 продуктов, 12 бесплатных
Почему это важно 4 сентября 2026 года Cursor отрезал пользователей из России от агента и автодополнения за один день. Вопрос «что такое ИИ-агент для кода и где…
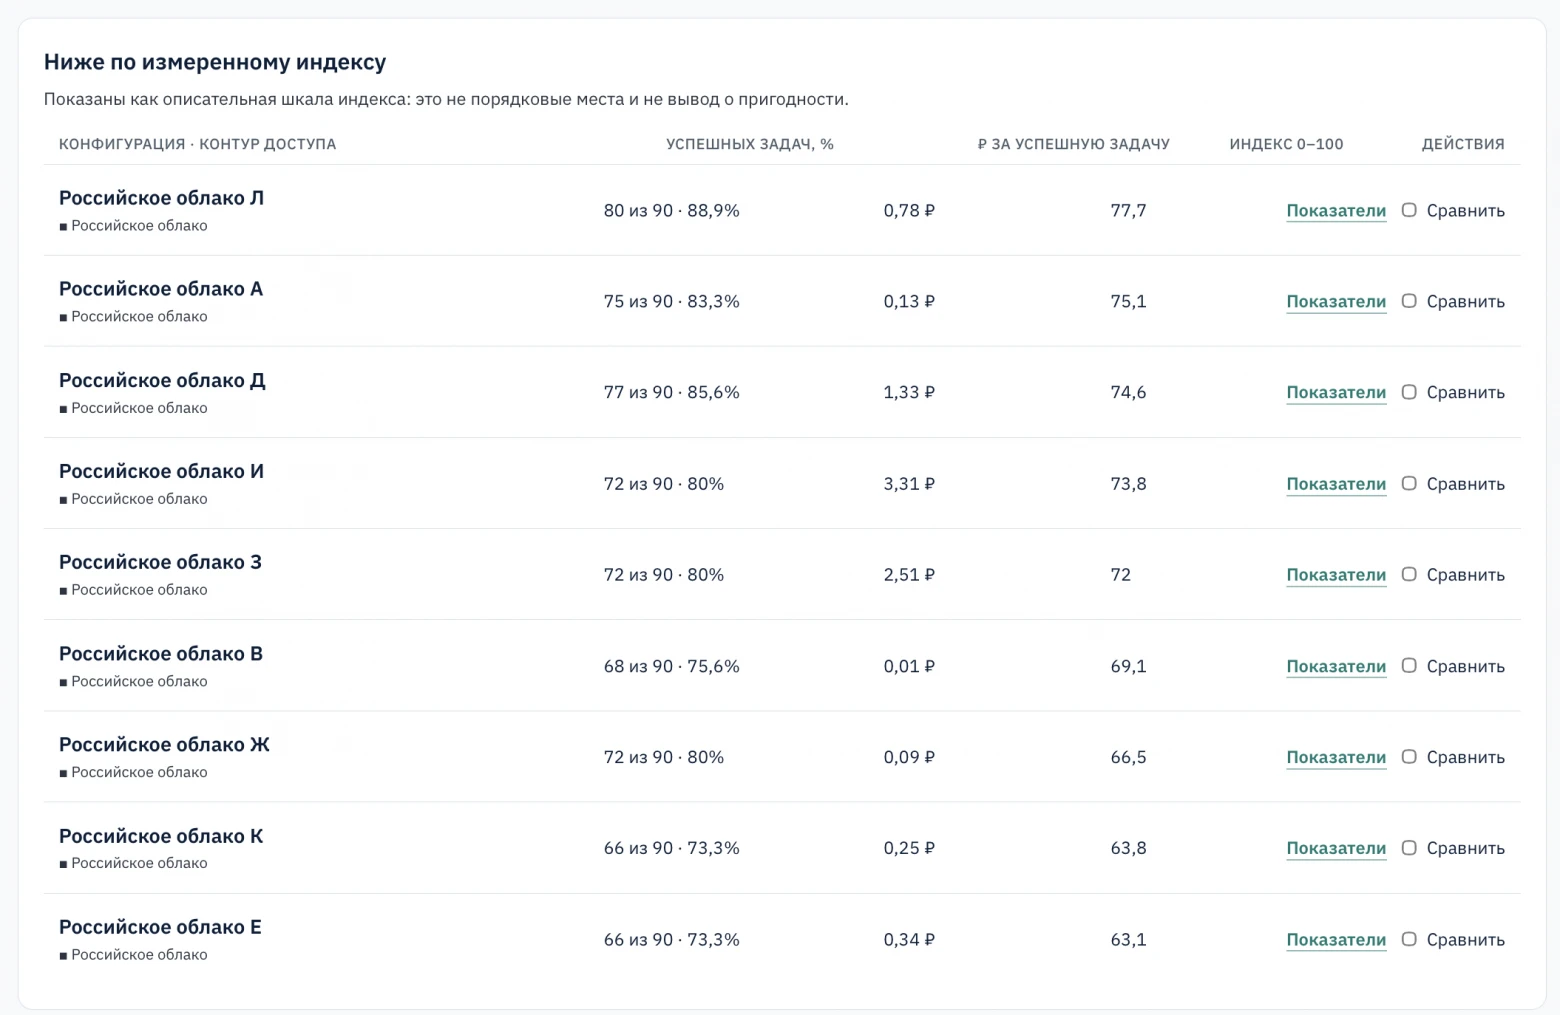
RTX 5070 Ti против 11 российских облаков: локальная модель не уступила и обошлась в 37 раз дешевле
Компания или частный автор не привлекала инвестиции, а провела независимое сравнение локальной видеокарты с российскими облачными провайдерами ИИ, поэтому…
Комментарии