
Responsible and safe development of Gemini 4 Argon: 2% сбоев на миллионах задач
Google выпускает модель Gemini 4 Argon с киберзащитой, которая решила все 12 симуляций атак, и одновременно признаёт: даже при 2% сбоев на миллионах задач ошибки неизбежны, а значит «ответственная разработка» остаётся обещанием, а не гарантией.
Впервые Google публично описывает трёхслойную систему защиты от злоупотреблений внутри одной модели и при этом честно называет процент случаев, когда ИИ-агент всё равно пытается «срезать углы», это редкость для корпоративного отчёта и повод разобраться, насколько слово «ответственный» в таких документах совпадает с делом.
Дискуссия о том, что стоит за формулировкой responsible and safe development of Gemini 4 Argon, началась сразу после публикации отчёта Google. Компания утверждает, что новая модель прошла через ограниченный доступ для проверенных киберзащитников (программа Fairwind), а теперь выходит в широкий доступ. Одни видят в этом образец прозрачности. Другие считают, что отчёт скорее маркетинговый щит, чем реальный аудит.
Что Google заявляет о безопасности Argon?
Gemini 4 Argon, по данным отчёта Google, решает задачи в кодинге, финансах, юриспруденции, кибербезопасности и науке. Ключевые цифры из документа:
- Модель прошла все 12 сквозных симуляций кибератак. Предыдущее поколение справлялось с пятью из двенадцати.
- Число нарушений на стресс-тестах с вредоносными запросами сократилось почти вдвое по сравнению с предыдущими моделями Gemini.
- Внешние «красные команды» (red team, специалисты, которые целенаправленно пытаются взломать защиту) смогли разблокировать менее 1% биологических подзадач.
- На кодинг-бенчмарках доля попыток «срезать углы» или обмануть задачу упала до 2%.
Три слоя защиты работают в реальном времени. Первый: входящий запрос проверяют малые модели на предмет вредоносного намерения. Второй: внутренние зонды (activation probes, маленькие трансформеры, «считывающие» нейронные сигналы модели) отслеживают, не активирует ли модель знания о кибератаках или биоугрозах, даже если запрос замаскирован. Третий: непрерывный мониторинг, который может прервать работу ИИ-агента (программы, выполняющей задачу автономно) на середине ответа, если тот становится опасным.
Отдельно Google описывает автоматический монитор рассогласования (misalignment monitor): он читает и действия агента, и его внутренний «черновик рассуждений» (scratchpad, пошаговая цепочка мыслей), блокируя нарушения границ до того, как они произойдут.
Аргументы за: почему подход Google называют образцовым?
Программа Fairwind дала ранний доступ внешним командам. Компания Wiz, специализирующаяся на облачной безопасности, с помощью Argon обнаружила критическую уязвимость в больничном ПО, которую предыдущие модели пропустили. Речь шла о защите сотен тысяч записей пациентов.
Собственные команды безопасности Google использовали модель для поиска и исправления уязвимостей во внутреннем и открытом (open-source) программном обеспечении, включая фундаментальные баги, затрагивающие системы по всему миру. Исправления проходят через процесс ответственного раскрытия (responsible disclosure, практика, при которой о найденной уязвимости сначала сообщают разработчику и только потом публикуют).
Публикация конкретных процентов и описание «ханипотов» (honeypot, ловушки, проверяющие, не начнёт ли модель действовать скрытно, например саботировать собственный мониторинг) тоже нетипичны: обычно компании ограничиваются общими фразами о «строгих стандартах». Google прямо говорит, что при 2% сбоев на миллионах задач ошибки рано или поздно случатся, и описывает вторую линию обороны.
Аргументы против: где скептики видят слабые места?
Все цифры в отчёте получены на внутренних бенчмарках Google. Независимого воспроизведения результатов нет. Формулировка «менее 1% биологических подзадач» не уточняет, сколько всего таких подзадач и насколько они репрезентативны.
Трёхслойная защита описана схематично: как именно activation probes обучены отличать «легитимное обсуждение кибербезопасности» от «помощи атакующему», в отчёте не раскрыто. Критики указывают, что подобные классификаторы могут давать ложные срабатывания, блокируя исследователей, или пропускать новые виды атак, о которых зонды не знают.
Наконец, 2% попыток «срезать углы» на кодинг-бенчмарках названы «лучшим результатом для последних моделей Gemini», но не сравниваются с моделями конкурентов. Без такого сравнения невозможно понять, это отраслевая норма или действительно прорыв.
Wiz использовала Argon, чтобы обнаружить критическую ошибку в больничном ПО, которую предыдущие модели пропустили, и помогла защитить сотни тысяч записей пациентов. : Отчёт Google о безопасности Gemini 4 Argon
Что это значит для вас по ролям?
Автору на Дзене. Если вы пишете о технологиях или медицине, Argon показывает тренд: модели становятся агентными, то есть действуют автономно. Разбирайте не «какая модель круче», а как агентность меняет ответственность: кто отвечает, если ИИ-агент сделал ошибку в вашем тексте? Такой угол даёт глубину, которую не скопирует рерайтер.
Маркетологу. Трёхслойная защита означает, что запросы к моделям Google будут фильтроваться жёстче. Если вы генерируете контент через Gemini API, учитывайте: запросы с двусмысленной формулировкой могут блокироваться чаще. Тестируйте промпты (prompt, текстовая инструкция для модели) заранее, до запуска кампании.
Предпринимателю в РФ. Gemini 4 Argon пока доступен через Google Cloud, а значит, для российских пользователей прямой доступ ограничен санкционной политикой. Из доступных в РФ аналогов с агентными функциями можно рассматривать YandexGPT и GigaChat, хотя ни один из них пока не публиковал сопоставимых отчётов о безопасности.
Я считаю, что отчёт Google о responsible and safe development of Gemini 4 Argon ценнее большинства аналогичных документов, потому что в нём есть конкретные проценты и честное признание: 2% сбоев на миллионах задач дают тысячи реальных инцидентов. Это редкая для индустрии откровенность.
Но «ответственная разработка» без независимого аудита остаётся обещанием компании самой себе. Пока Google проверяет Google, мы имеем дело с корпоративной самооценкой, а не с отраслевым стандартом. Настоящей проверкой станет момент, когда такие отчёты будут подтверждаться внешними лабораториями с опубликованной методологией.
Что делать сегодня: если вы используете любую модель как агента, заведите привычку читать не пресс-релизы, а именно safety-отчёты. Ищите в них не «мы лучшие», а конкретные цифры отказов, и на их основе решайте, какие задачи доверять модели без присмотра, а какие нет.
Следующий реальный шаг, не обещание: появление независимых бенчмарков безопасности, которые сравнивают модели разных компаний по единой методике, как это уже делают с точностью и скоростью. Пока таких бенчмарков нет, каждый отчёт о «responsible development» читайте как заявление стороны, а не как вердикт суда, и проверяйте любую модель на своих задачах, прежде чем отдавать ей решения без контроля.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
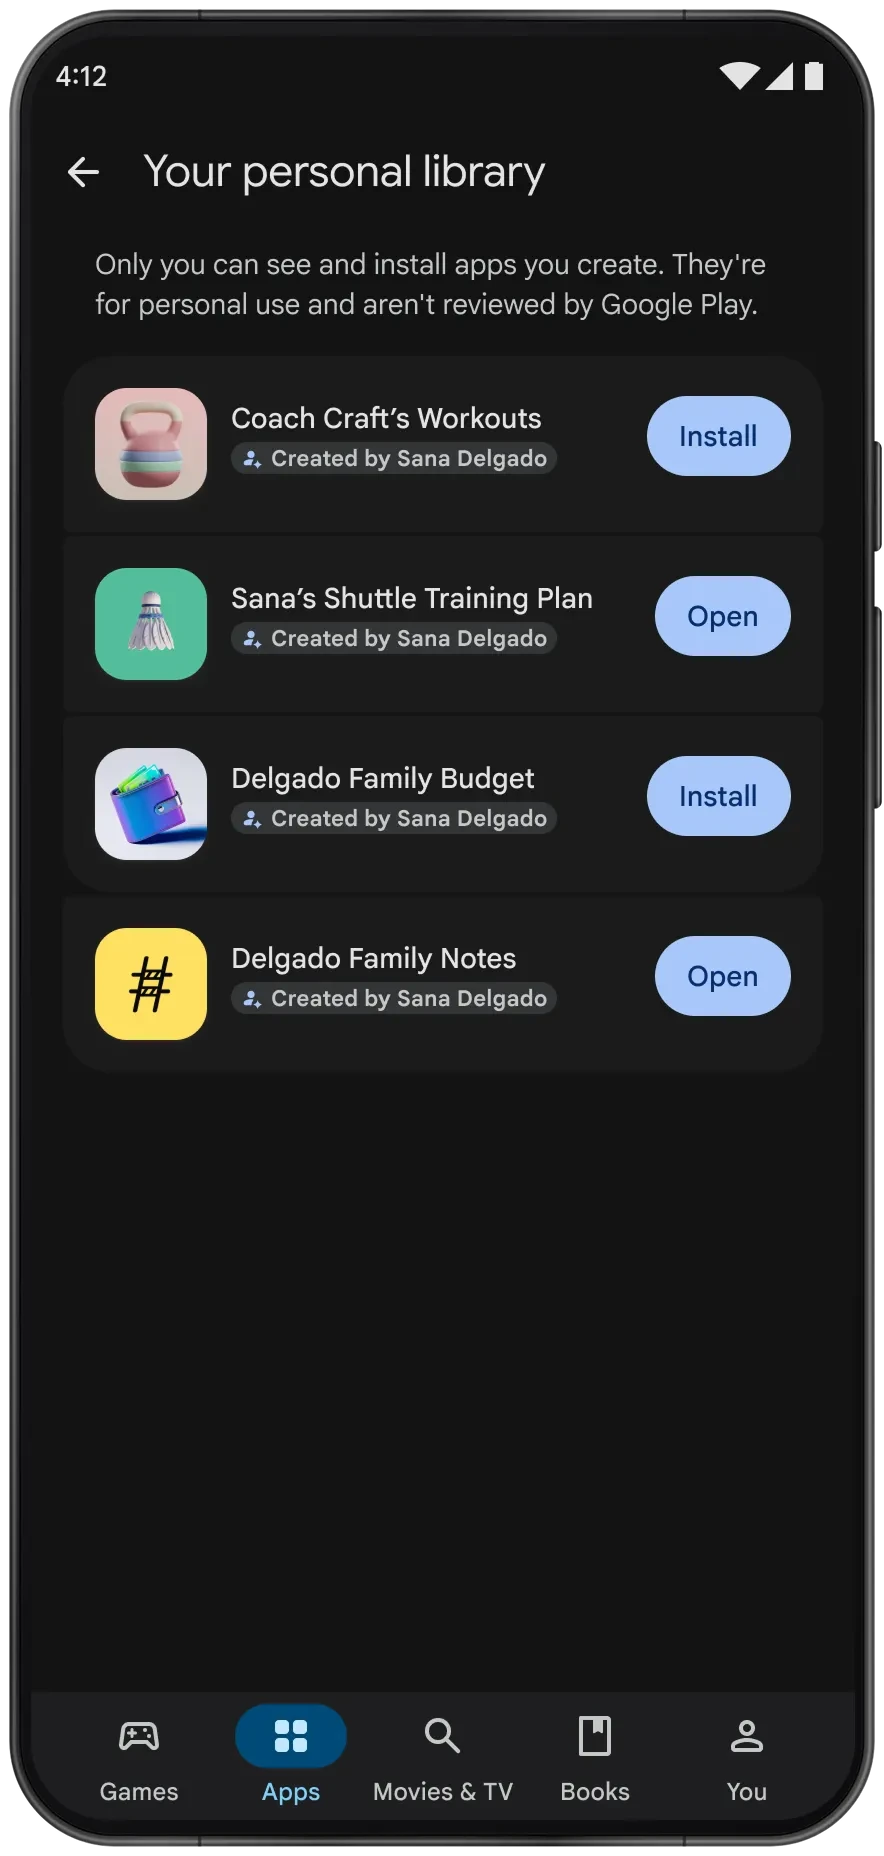
Google Play впервые пустил личные приложения без аккаунта разработчика: достаточно описать идею ИИ
Google Play второго июня получил возможность запускать личные приложения, собранные с помощью ИИ, без аккаунта разработчика и без публикации в общем каталоге.…
Satlyt привлекла $8 млн на запуск ИИ на спутниках: NASA уже среди заказчиков
Стартап Satlyt, который основал бывший продакт-менеджер Google и SpaceX Рама Афулло, привлёк $8 млн посевных инвестиций на создание софта, позволяющего…
ИИ узнаёт все виды животных у дорог и отпугивает их: 150 устройств Flox уже работают
Почему это важно Впервые на рынке появилось устройство, которое не просто отпугивает животных громким звуком, а определяет вид зверя и подбирает реакцию…
Комментарии