
Reflection тратит $150 млн в месяц, чтобы вернуть США в гонку открытых моделей ИИ
Почему это важно Впервые за долгое время американская лаборатория выпустила крупную открытую модель ИИ, обученную с нуля, а не дообученную поверх китайской…
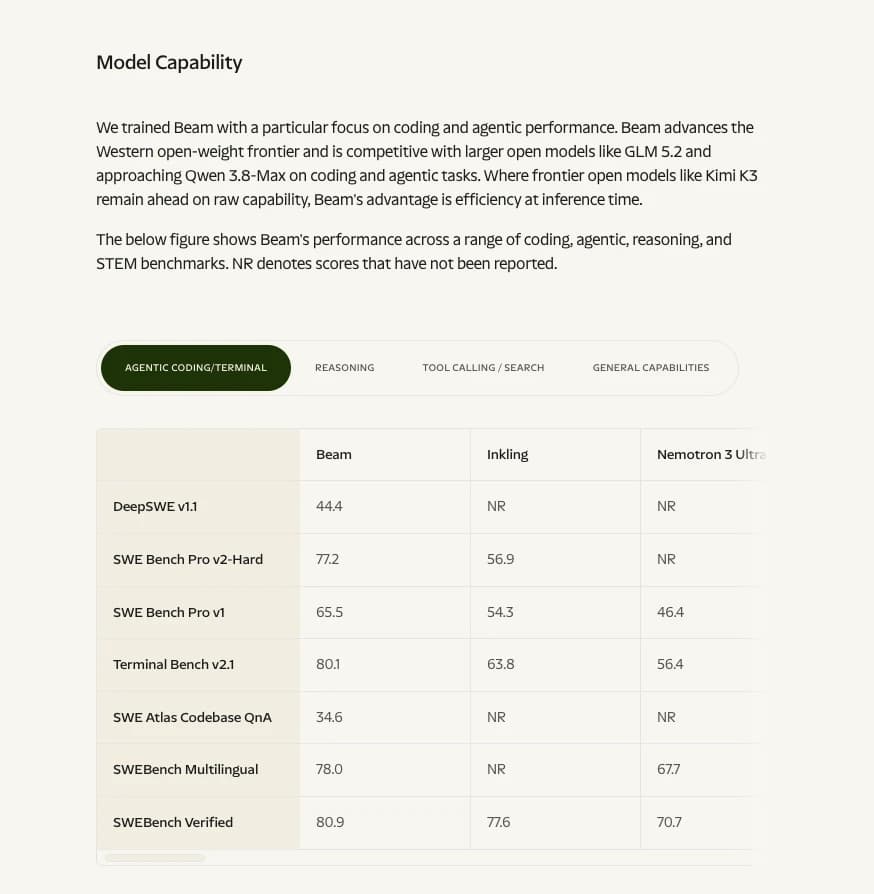
Впервые за долгое время американская лаборатория выпустила крупную открытую модель ИИ, обученную с нуля, а не дообученную поверх китайской базы, и отдаёт веса под свободной лицензией Apache 2.0.
Компания Reflection анонсировала Beam в начале октября 2026 года, после более чем года работы в режиме «стелс», и сразу заявила о конкуренции с ведущими открытыми моделями из Китая.
По данным Axios, запуск был анонсирован заранее: издание сообщило, что Reflection тратит 150 миллионов долларов в месяц на вычислительные мощности кластера Colossus и заключила отдельную сделку с Nebius на 1 миллиард долларов. Axios также упоминает, что другие неназванные американские лаборатории планируют выпустить открытые модели ИИ в том же месяце.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Beam, текстовая модель на 501 миллиард параметров (23 миллиарда активных) | Октябрь 2026, полные веса обещаны в течение месяца | Reflection | Бесплатно, лицензия Apache 2.0 |
Что умеет Beam и чем отличается от конкурентов?
-
Архитектура MoE (Mixture of Experts, «смесь экспертов», когда модель активирует только часть параметров на каждый запрос, экономя ресурсы): всего 501 миллиард параметров, но одновременно работают только 23 миллиарда. Это делает инференс (процесс генерации ответа) заметно дешевле, чем у «монолитных» моделей сопоставимого размера.
-
Обучена с нуля на 23,8 триллиона токенов (токен, это фрагмент текста, примерно три четверти английского слова). Часть обучающих данных получена через OCR-конвейер (распознавание текста) по сотням миллионов PDF-документов, по данным команды Reflection.
-
Заявленные результаты: 80,9 балла на SWE-bench Verified (стандартный тест на способность модели решать реальные задачи из репозиториев кода). Команда также заявляет о трёх-четырёхкратном преимуществе в эффективности инференса по сравнению с GLM 5.2, по собственным замерам Reflection.
-
Специализация: код, агентные сценарии (когда модель сама выполняет цепочку действий) и научные задачи. Модель текстовая, без обработки изображений или видео.
-
RL-обучение (обучение с подкреплением, когда модель учится на собственных попытках решить задачу): команда сообщает о более чем 100 миллионах прогонов по примерно 1 миллиону задач на кластере из порядка 10 500 ускорителей GB300.
Где Beam среди конкурентов?
Сама команда сравнивает Beam с моделями Inkling, Nemotron и GLM 5.2. Однако наблюдатели, в частности Натан Ламберт, отмечают, что более свежие китайские открытые модели ИИ, такие как GLM 5.3, Kimi K3, Qwen 3.8 Max и DeepSeek V4.1 Flash, по ряду тестов опережают Beam.
Аналитики Artificial Analysis, получившие ранний доступ, ожидают, что Beam окажется одной из наиболее эффективных по соотношению «интеллект на токен» открытых моделей. Элие Бакуш оценивает эффективность использования вычислений (MFU) при предобучении примерно в 12% в формате BF16 и отмечает, что по перплексии на отложенной выборке кода Beam показывает результаты лучше, чем DeepSeek V4.
Важный контекст: Beam обучена полностью в США. Для организаций, которым по регуляторным или внутренним причинам нужны открытые модели ИИ не китайского происхождения, это редкий вариант такого масштаба.
Как попробовать?
-
Дождитесь публикации весов: Reflection обещает выложить полные открытые веса (open weights, файлы с обученными параметрами модели) под лицензией Apache 2.0 в течение октября 2026 года. Следите за анонсами Reflection и лично Ильи Ласкина.
-
Подготовьте инфраструктуру: модель на 501 миллиард параметров потребует серьёзных мощностей для локального запуска. Для экспериментов без своего железа подойдут облачные платформы, поддерживающие крупные MoE-модели.
-
Проверьте совместимость: команда обещает интеграции с популярными фреймворками для работы с открытыми моделями. Технический отчёт также заявлен, но пока не опубликован.
Сравнение с доступными в России вариантами
Из доступных в РФ инструментов ближайшие по назначению, это YandexGPT и GigaChat от Сбера. Однако прямое сравнение затруднено: российские модели закрытые (закрытая модель, когда веса не публикуются и доступ только через API провайдера), их архитектура и размер не раскрываются. Beam, напротив, полностью открыта, и после публикации весов её можно будет запустить локально или дообучить (fine-tuning, обучение модели на ваших примерах под узкую задачу) под свои данные, чего с YandexGPT или GigaChat сделать нельзя.
Для разработчиков из РФ и СНГ, которым важен контроль над моделью и возможность запуска на собственных серверах, Beam представляет практический интерес именно как альтернатива китайским открытым моделям, не привязанная к экосистеме DeepSeek или Qwen.
Что делать с этим прямо сейчас, по ролям
Разработчику и техническому автору: если вы строите продукт на открытых моделях и вам нужна сильная кодовая база не из Китая, Beam стоит протестировать сразу после выхода весов. Результат 80,9 на SWE-bench, это уровень, достаточный для автоматизации рутинных задач в коде.
Автору Дзена и контент-маркетологу: прямо сейчас Beam недоступна для генерации текстов, это модель для кода и агентных сценариев. Следите за появлением сервисов и API на её основе, но для написания постов пока используйте привычные инструменты.
Предпринимателю в РФ: Apache 2.0 позволяет коммерческое использование без ограничений. Если вашей команде нужна модель, которую можно развернуть на собственных серверах без зависимости от китайских или американских облаков, Beam после публикации весов, кандидат для пилота.
Beam пока не обогнала лучшие китайские открытые модели ИИ по абсолютным показателям, наблюдатели ставят её примерно на уровень GLM 5.2, а не GLM 5.3 или DeepSeek V4.1 Flash. Но для рынка имеет значение сам факт: появилась крупная модель, обученная в США с нуля и отданная под Apache 2.0. До сих пор в этом весе доминировали китайские лаборатории, и выбор для тех, кому важно происхождение модели, был ограничен.
Оговорка: технический отчёт ещё не вышел, веса не опубликованы, независимые тесты только начинаются. Заявленные цифры, это пока цифры самой команды. Я бы рекомендовал дождаться публикации весов и первых независимых прогонов, прежде чем принимать решение о миграции.
Частые вопросы
Beam уже можно скачать и запустить?
Пока нет. Reflection анонсировала модель, но полные веса обещаны к концу октября 2026 года. На момент анонса доступны только заявленные результаты и ранний доступ для отдельных аналитиков, включая Artificial Analysis.
Чем Beam отличается от DeepSeek V3 и других китайских моделей?
По оценке наблюдателя Teortaxes, Beam, это примерный аналог DeepSeek V3 по затраченным вычислениям (iso-FLOP). Ключевое отличие не в архитектуре, а в происхождении: модель полностью обучена в США, данные собраны командой Reflection, лицензия Apache 2.0. Для организаций с требованиями к цепочке поставок это может быть решающим фактором.
Подойдёт ли Beam для генерации контента на русском языке?
Reflection позиционирует Beam как модель для кода, агентных задач и науки. О поддержке русского языка команда не сообщала. После публикации весов это можно будет проверить самостоятельно, но рассчитывать на качество уровня моделей, специально обученных на русском, пока оснований нет.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google Gemini 4 Argon обошла GPT-6 в 13 из 19 тестов, но в гонке поисковых систем с ИИ доступ закрыт
Google третьего июня представила Gemini 4 Argon, новую флагманскую модель, которая обошла GPT-6 Astra и Claude Opus 5.5 в 13 из 19 тестов, но пока доступна…
Карьера в науке глазами докторанта MIT: рекурсивные модели обошли Astra от OpenAI
Лид Алекс Чжан, докторант MIT и участник сообщества GPU Mode, в июне 2025 года дал развёрнутое интервью подкасту Latent Space, где объяснил, как рекурсивные…
Airbnb пишет 60% кода с помощью ИИ: уроки для тех, кто читал Тима Джонса
Airbnb под руководством нового технического директора Ахмада Аль-Дахле перестроила внутренние процессы разработки так, что 60% кода теперь пишет ИИ, а число…
Комментарии