
Карьера в науке глазами докторанта MIT: рекурсивные модели обошли Astra от OpenAI
Лид
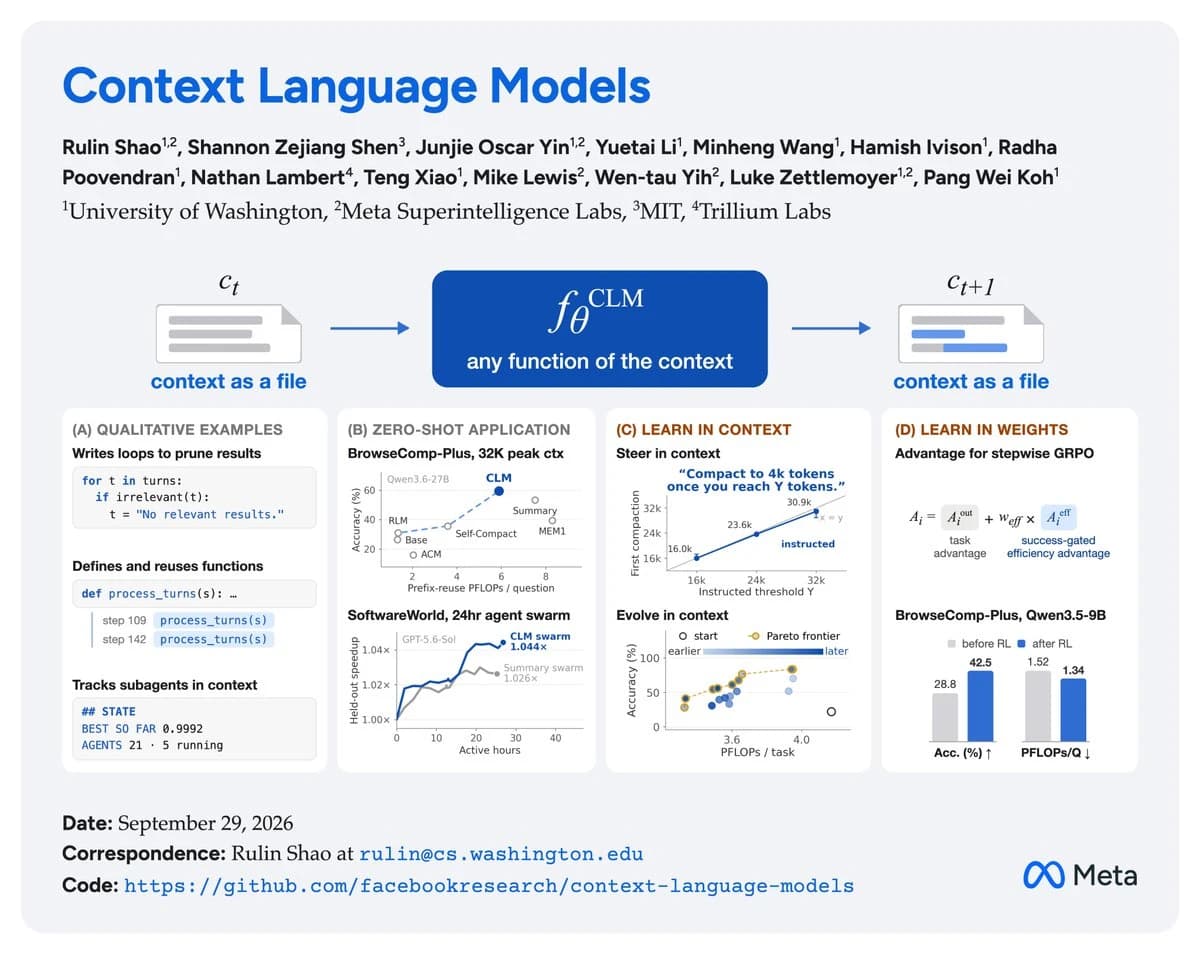
Алекс Чжан, докторант MIT и участник сообщества GPU Mode, в июне 2025 года дал развёрнутое интервью подкасту Latent Space, где объяснил, как рекурсивные языковые модели и мультиагентные рои могут сменить привычную архитектуру больших языковых моделей.
Подход Чжана к рекурсивным языковым моделям (RLM) позволил решить бенчмарк ARC-AGI-3 раньше, чем это сделала модель Astra от OpenAI, и ставит под вопрос саму идею, что языковая модель обязана быть автогрессивным декодером текста.
Подкаст Latent Space, который ведёт Swyx, обычно фокусируется на индустрии, но раз в год выделяет выпуск на перспективного исследователя. В 2024 году героем был Шуньюй Яо, который затем строил Operator в OpenAI, а сейчас занимает пост Chief AI Scientist в Tencent. В 2025 году подкаст представил Джека Морриса, сооснователя компании Engram с оценкой в 600 млн долларов (по данным Latent Space). В этом году выбор пал на Алекса Чжана.
Разговор затрагивает темы, напрямую связанные с карьерой в науке: как выбирать исследовательские ставки, почему стоит браться за задачи, которые на первый взгляд выглядят тривиальными или бессмысленными, и где сейчас лежат незанятые ниши в архитектурах моделей.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Выпуск подкаста Latent Space с Алексом Чжаном (MIT) | Июнь 2025 | Latent Space (ведущий Swyx) | Бесплатно |
Какие идеи Чжан вынес на обсуждение?
-
Рекурсивные языковые модели (RLM) (Recursive Language Models, модели, которые вызывают сами себя как подагентов, передавая контекст и разделяя память между копиями). Подход Чжана на основе RLM решил бенчмарк ARC-AGI-3 раньше модели Astra от OpenAI.
-
Языковая модель не обязана быть автогрессивной. Чжан обсуждает концепцию GEV (Generalized Entropy-based View) как альтернативу стандартному автогрессивному декодеру «текст на входе, текст на выходе». Это значит, что будущая «языковая модель» может оказаться невидимым роем ИИ-агентов под простым интерфейсом.
-
Мультиагентные рои. Разговор затрагивает эксперимент OpenAI с 10 000 агентами, 130 млрд выходных токенов (токен, минимальная единица текста для модели, примерно часть слова) и расходами порядка 40 млн долларов на решение задач (цифры приводятся Latent Space). Чжан отмечает, что значительная часть работы роя может быть «потерянным поиском», а сходимость остаётся нерешённой проблемой.
-
Capability overhang (скрытый запас возможностей). Текущие передовые модели, по мнению Чжана, уже обладают большим запасом неиспользованных способностей, который раскрывается через правильный «harness» (обвязку, код и логику, которые управляют вызовами модели).
-
GPU-ядра, написанные ИИ, пока уступают людям. Несмотря на прогресс, одна экспертная идея человека всё ещё может заменить огромный объём перебора токенов.
-
Neuralese (гипотетический внутренний «язык» моделей). Открытый вопрос: ограничивает ли английский язык или код способ рассуждения моделей, и не нужен ли им принципиально иной формат.
Как попробовать?
- Послушайте полный выпуск подкаста Latent Space, он доступен бесплатно (ищите Latent Space, выпуск с Alex Zhang, июнь 2025).
- Познакомьтесь с работой Чжана на его сайте: alexzhang13.github.io. Там же ссылки на статьи по RLM и KernelBench.
- Если интересуют GPU-ядра и низкоуровневая оптимизация, присоединяйтесь к сообществу GPU Mode в Discord, оно открытое и бесплатное.
Есть ли аналоги в России?
Прямого российского аналога RLM-подхода Чжана пока нет в публичном доступе. YandexGPT и GigaChat работают как стандартные автогрессивные модели и не предлагают пользователю инструментов для построения рекурсивных агентных цепочек. Однако тема мультиагентности активно обсуждается в русскоязычном сообществе, а подходы с «обвязкой» (harness) можно воспроизвести поверх любой доступной модели, включая открытые (open-source, модели с доступным кодом и весами).
Карьера в науке: что берёт Чжан от академии?
Отдельная линия разговора посвящена тому, как строить карьеру в науке, если ты PhD-студент. Чжан формулирует принцип: стоит делать ставки на задачи, за которые индустриальные лаборатории не берутся, потому что те выглядят «тривиальными, странными или бессмысленными». Именно такие ставки привели его к RLM. Для тех, кто ищет карьеру в науке за пределами стандартного пути «опубликовать статью и попасть в Google», это конкретный совет с подтверждённым результатом.
Любопытно, что запрос «карьера наука в Симс 3» регулярно всплывает в поиске: в игре есть ветка научной карьеры с лабораторией и изобретениями. Реальная карьера в науке в 2025 году, судя по истории Чжана, устроена похоже: берёшь странную задачу, ковыряешь её в одиночку, а потом результат обгоняет лабораторию с бюджетом в десятки миллионов.
Этот выпуск стоит послушать не ради хайпа, а ради конкретных архитектурных идей. RLM, это не абстрактная теория: подход уже обошёл OpenAI на конкретном бенчмарке. Для тех, кто строит ИИ-агентов или пишет обвязки для моделей, здесь есть практичная мысль: правильный harness важнее, чем размер модели.
Оговорка: все цифры (10 000 агентов, 130 млрд токенов, 40 млн долларов) приведены в подкасте без ссылок на первоисточник, относитесь к ним как к оценкам, а не как к подтверждённым данным.
Что сделать сегодня: если вы автор на Дзене и пишете про ИИ, разберитесь в термине «harness» (обвязка модели). Через полгода это слово будет в каждой второй новости, и вы будете объяснять его читателям.
Частые вопросы
Что такое RLM и чем отличается от обычного чат-бота?
RLM (Recursive Language Model, рекурсивная языковая модель) вызывает саму себя как подагента: разбивает задачу на части, раздаёт их своим копиям, делит с ними память и собирает результат. Обычный чат-бот отвечает за один проход, RLM строит дерево вызовов. Результат: подход на основе RLM решил бенчмарк ARC-AGI-3 раньше, чем Astra от OpenAI.
Нужны ли для экспериментов с RLM мощные GPU?
В подкасте этот вопрос не раскрыт детально. Чжан работает в MIT и связан с сообществом GPU Mode, которое занимается оптимизацией GPU-ядер. Но сам принцип RLM (рекурсивный вызов модели с разделением контекста) можно тестировать поверх API любой доступной модели, не обязательно владеть дорогим оборудованием.
Где послушать полный выпуск?
Подкаст Latent Space доступен бесплатно на основных подкаст-платформах. Выпуск с Алексом Чжаном вышел в июне 2025 года, длится около полутора часов и содержит таймкоды по всем темам.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Airbnb пишет 60% кода с помощью ИИ: уроки для тех, кто читал Тима Джонса
Airbnb под руководством нового технического директора Ахмада Аль-Дахле перестроила внутренние процессы разработки так, что 60% кода теперь пишет ИИ, а число…
Pi AI нейросеть получила защиту от сбоев: агенты больше не теряют контекст
Компания Inflection AI 1 июля 2026 года выпустила Pi 1.0 и Pi Durable, два инструмента для разработчиков ИИ-агентов (программ, которые выполняют задачи…
Gemini 4 Argon лидирует в 13 из 19 тестов: втрое меньше галлюцинаций и вдвое дешевле Astra
Google запустила Gemini 4 Argon 30 сентября 2026 года, первую за семь месяцев модель уровня выше Flash, и она лидирует в 13 из 19 публичных тестов, опережая…
Комментарии