
Нейросеть для тестирования классификации: Jev в 5 раз дешевле GPT, но ошибается тише
Почему это важно Независимое тестирование 160 тысяч запросов к нейросети Jev показало: она классифицирует текст на уровне gpt-4.1-mini, но ошибается «тихо», с…
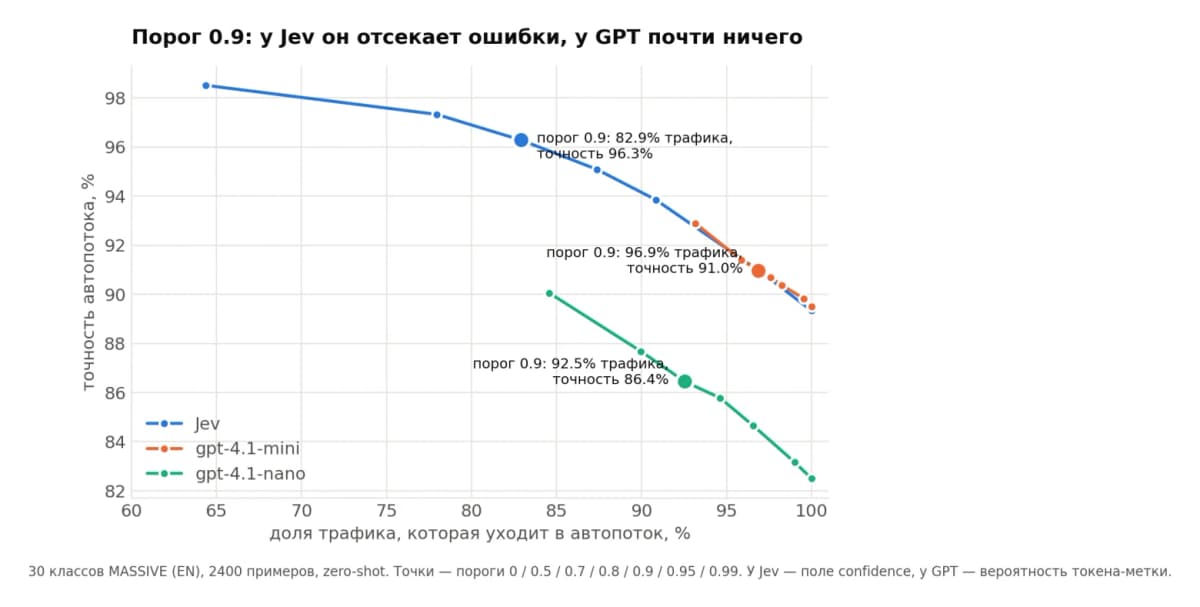
Независимое тестирование 160 тысяч запросов к нейросети Jev показало: она классифицирует текст на уровне gpt-4.1-mini, но ошибается «тихо», с низкой уверенностью, тогда как GPT ошибается «громко», и это критично для любого, кто строит автоматическую обработку текстов.
Разработчик из российского сообщества с 19 по 30 сентября 2026 года провёл 22 эксперимента и отправил около 160 тысяч запросов к модели jev-1.13.0 и контрольным моделям OpenAI, чтобы найти практические границы нейросети Jev, специализированной модели для классификации текста. Результаты он опубликовал на Хабре, и они важны для всех, кто подбирает нейросеть для тестирования задач классификации в продакшене.
Jev не генерирует текст, как ChatGPT или YandexGPT. Она принимает текст и набор вопросов к нему, а возвращает ответ с распределением вероятностей. Три типа вопросов: выбор из списка, оценка по шкале и «да/нет». Вся «настройка» сводится к описанию классов на естественном языке, без дообучения (fine-tuning, обучения модели на ваших примерах под узкую задачу).
Всё тестирование обошлось автору примерно в 18 долларов через API (программный интерфейс) раннего доступа.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| jev-1.13.0, модель классификации текста (не генеративная) | Тестирование: 19–30 сентября 2026 | Typesafe AI | $0,042 за миллион входных токенов, выход бесплатен |
Что показали 22 эксперимента?
- Точность на уровне gpt-4.1-mini. Если обеим моделям дать только описания классов, результат сопоставим, но Jev в 2,4 раза быстрее и в 5 раз дешевле.
- Калибровка уверенности принципиально другая. 83% ошибок gpt-4.1-mini сделаны с уверенностью (confidence, числовая оценка от 0 до 1, насколько модель «уверена» в ответе) выше 0,9. У Jev при том же пороге только 29% ошибок. Это значит, что автоматический фильтр «не пропускай ответы с низкой уверенностью» у Jev работает, а у GPT почти бесполезен.
- Порог уверенности нельзя переносить между схемами. Добавили новых классов, тот же порог начинает пропускать больше ошибок. Каждую схему нужно калибровать заново.
- 40 вопросов к одному тексту обрабатываются почти за время одного и обходятся до 86% дешевле, чем по одному.
- Качество описаний классов важнее выбора модели. С хорошими описаниями название метки почти не влияет на точность. Без них название решает всё.
- Русский текст втрое дороже английского по токенам. Токены (единицы текста, за которые платишь) у Jev считаются иначе, чем у LLM (больших языковых моделей): один и тот же запрос «весит» вдвое больше токенов, чем у GPT.
- Посторонний текст вредит сразу, а не только у границы контекстного окна. Jev чувствительнее к «мусору» на входе, чем GPT.
- Цитата письма в мусоре опаснее случайного шума: она тянет ответы в «почтовый» класс. Явный класс «other» (прочее) в разы надёжнее порога для фильтрации чужого входа.
- С несколькими сотнями размеченных примеров (около 16 на класс) обычный обученный классификатор догоняет Jev по точности.
Как попробовать Jev самостоятельно?
- Зарегистрируйтесь на сайте Typesafe AI и получите API-ключ раннего доступа.
- Отправьте тестовый запрос через API: передайте текст в поле
state, опишите классы на естественном языке в полеquestionsи укажите модельjev-1.13.0. - Проанализируйте ответ: модель вернёт выбранный вариант, уверенность (confidence) и распределение вероятностей по всем вариантам.
- Перед интеграцией в продакшен откалибруйте порог уверенности именно на вашей схеме классов: автор тестирования подтвердил, что готовый порог между задачами не переносится.
Jev и российские аналоги: что учесть?
Jev решает узкую задачу: классификация текста, а не генерация. В России генеративные модели YandexGPT и GigaChat тоже умеют классифицировать, но они делают это «через генерацию»: вы просите модель назвать категорию, она формирует текстовый ответ.
Для нейросетей для тестирования программного обеспечения и автоматической маршрутизации обращений разница существенная: Jev возвращает числовую уверенность, по которой можно строить автоматический роутинг (направление запроса нужному специалисту или боту). GPT и российские аналоги такой встроенной калибровки не дают, порог приходится подбирать по доле трафика, а не по значению.
Главное ограничение для локальной интеграции: русский текст обходится в Jev втрое дороже английского по токенам. Если ваша задача целиком на русском языке, экономическое преимущество «в 5 раз дешевле GPT» может сократиться до полутора раз или исчезнуть.
Результаты этого тестирования, пожалуй, самое подробное независимое сравнение Jev с GPT-моделями, которое я видел на русском языке. Автор не рекламирует продукт: он честно показывает, что при 16 размеченных примерах на класс обычный классификатор догоняет Jev. Для меня главная находка в другом: разница в калибровке уверенности. Если вы строите автоматическую обработку обращений или сортировку контента и хотите, чтобы «сомнительные» ответы уходили на ручную проверку, у Jev это работает из коробки, а у GPT, по данным автора, 83% ошибок выглядят как уверенные ответы, и фильтр бесполезен.
Оговорка: все цифры привязаны к версии jev-1.13.0 и к конкретным датам замеров. Модель в раннем доступе, API может измениться. Русский язык втрое дороже по токенам, и это нужно считать до интеграции, а не после.
Что сделать сегодня: если вы автор Дзена и автоматически сортируете комментарии или входящие заявки, попробуйте отправить десяток тестовых запросов на русском и сравните стоимость с вашим текущим решением. Именно цена на русском тексте покажет, есть ли смысл переходить.
Частые вопросы
Jev заменяет ChatGPT или YandexGPT?
Нет. Jev не генерирует текст. Она классифицирует: определяет категорию, оценивает по шкале или отвечает «да/нет» с числовой уверенностью. Для написания статей, ответов клиентам или генерации контента она не подходит. Её задача, автоматическая сортировка и маршрутизация.
Почему русский текст дороже?
Токенизатор Jev (механизм разбиения текста на единицы оплаты) устроен иначе, чем у LLM. Один и тот же запрос на русском «весит» втрое больше токенов, чем на английском. Автор тестирования подтвердил это прямыми замерами. При интеграции в российские системы это главная статья расходов, которую нужно считать заранее.
Можно ли доверять уверенности модели для автоматических решений?
Да, но с оговоркой: порог уверенности нужно калибровать под каждую конкретную схему классов. Добавили новый класс, перекалибруйте. Перенесли порог из одной задачи в другую без проверки, получите больше пропущенных ошибок. Именно это тестирование показало как сильную сторону Jev (ошибки с низкой уверенностью легко отсеять), так и обязательное условие: ручная настройка порога под вашу задачу.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google отправила свой ИИ-чип на орбиту: космические дата-центры потребуют 1800 запусков Starship
Google впервые отправила свой серверный чип в космос на борту ракеты SpaceX, запущенной из Калифорнии 5 июня, и начала практическую проверку идеи космических…
Нейросеть «Амазон» не пишет, а решает: модель на 2B параметров работает на ноутбуке бесплатно
Почему это важно Amazon выложила в открытый доступ компактную модель для принятия решений, которая работает локально и стоит в разы дешевле полноценных…
Суд отклонил иски к Google: антитраст не защитит издателей от ИИ-обзоров
Google платит издателям, но суд решил: ожидание трафика не равно договору, и антимонопольное право тут бессильно. Почему это важно Федеральный суд США впервые…
Комментарии