
Нейросеть для генерации видео CADRE реагирует за 185 мс: втрое быстрее конкурентов
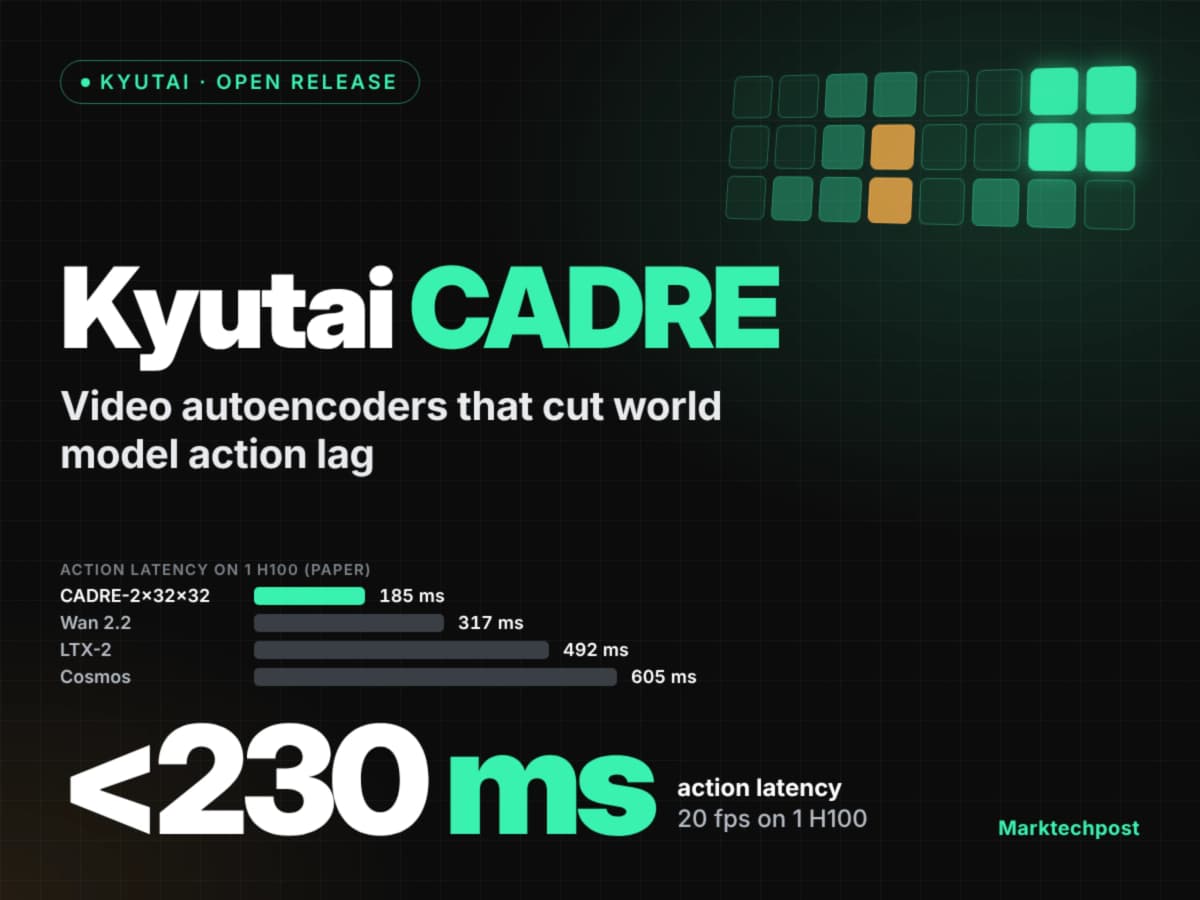
Компания Kyutai выпустила CADRE, семейство из семи открытых видеоавтоэнкодеров, которые позволяют интерактивным моделям мира реагировать на действия пользователя за 230 миллисекунд вместо привычных 300-600, и это меняет подход к генерации видео в реальном времени.
Нейросеть для генерации видео до сих пор работала с заметной задержкой: пользователь нажимает кнопку, а картинка догоняет через полсекунды. CADRE сокращает этот разрыв до порога, за которым человек перестаёт ощущать лаг. Код открыт, но весá доступны только для некоммерческого использования.
Исследование опубликовала французская лаборатория Kyutai. Проблема, которую решает CADRE, выглядит так: большинство моделей мира (world models, нейросети, которые предсказывают следующие кадры на основе действий пользователя) заимствуют автоэнкодеры из генераторов текста в видео. Те упаковывают сразу несколько кадров в одно скрытое представление, и каждое действие ждёт, пока «пачка» обработается. CADRE перестраивает эту схему: сжатие настраивается, задержка падает, а качество при этом не уходит в размытие.
| Показатель | Значение | Источник |
|---|---|---|
| Количество автоэнкодеров | 7 вариантов, каждый около 476 млн обучаемых параметров плюс замороженный DINOv3 (86 млн параметров) | Kyutai, исследовательская статья |
| Размер модели мира | 1,2 млрд параметров | Kyutai, исследовательская статья |
| Разрешение и частота кадров | 288×512 пикселей, 20 кадров в секунду | Kyutai, исследовательская статья |
| Оборудование | 1 видеокарта H100 | Kyutai, исследовательская статья |
| Задержка реакции (CADRE-2×32×32) | 185 мс при 23,4 кадра в секунду (1 шаг декодирования) | Kyutai, таблицы 4, 6, 7 |
| Задержка Wan 2.2 | 317 мс | Kyutai, таблицы 4, 6, 7 |
| FVD вождение (CADRE лучший) | 162,6 против 599,7 у Wan 2.2 | Kyutai, таблицы 4, 6, 7 |
| Обучающие данные | 23 публичных видеоисточника, около 76 000 часов | Kyutai, исследовательская статья |
| Лицензия кода / весов | MIT (код) / CC BY-NC 4.0 (весá, только некоммерческое использование) | Kyutai, репозиторий GitHub |
Что именно измеряли?
Kyutai взяла одну и ту же модель мира на 1,2 млрд параметров и подключала к ней разные автоэнкодеры. Автоэнкодер (autoencoder) здесь работает как переводчик: он сжимает видеокадры в компактный код, а потом восстанавливает из этого кода картинку. Чем сильнее сжатие, тем быстрее работает система, но тем больше теряется деталей.
Тестировали в четырёх средах: робот-манипулятор, действия от первого лица (руки человека), вождение автомобиля и навигация внутри помещений. Модель получала 2 секунды реального видео, а затем генерировала 4,8 секунды продолжения.
Качество оценивали тремя метриками:
- FID, насколько отдельные кадры похожи на реальные
- FVD (Fréchet Video Distance, расстояние между распределениями реального и сгенерированного видео), насколько естественно выглядит движение
- ARR (Action Response Rate, показатель следования действиям), насколько точно видео реагирует на команды пользователя. Значение 1 означает полное совпадение с реальным видео
Что обнаружили?
- Скорость на одной видеокарте. CADRE-2×32×32 реагирует за 185 мс и выдаёт 23,4 кадра в секунду. Для сравнения: Wan 2.2 требует 317 мс, LTX-2 нужно 492 мс, Cosmos отстаёт на 605 мс. По данным Kyutai, CADRE выигрывает в 42 из 48 попарных сравнений с этими конкурентами по соотношению задержки и качества.
- Движущаяся камера решает всё. При вождении FVD у Wan 2.2 достигает 599,7, а у LTX-2 поднимается до 913,3. CADRE показывает 162,6. При неподвижной камере разрыв значительно меньше.
- Диффузионный декодер вместо регрессии. Обычный декодер при сильном сжатии размывает картинку. Диффузионный (генерирующий кадр пошаговым «проявлением» из шума) выдаёт резкое изображение даже за один шаг. Это снижает FVD от 1,4 до 2,5 раза по сравнению с обычным декодером MIRA.
- Пространственное сжатие бьёт по движению первым. При 32-кратном пространственном сжатии в задачах с роботом FVD вырастает в 2,4 раза по сравнению с 16-кратным. При этом качество отдельных кадров (FID) почти не меняется.
Все цифры, по данным Kyutai, получены на их собственных бенчмарках. Независимого воспроизведения пока нет. CADRE проигрывает в отдельных задачах: в манипуляциях робота Cosmos показывает FVD 39,5 против 47,6 у лучшего варианта CADRE. Wan 2.2 лучше восстанавливает исходное видео (35,02 дБ PSNR). Между «пачками» кадров видны швы: при восьми кадрах на латент граница заметна. Каждая модель мира обучена на одной среде при разрешении 288×512, и неизвестно, перенесутся ли результаты на универсальные модели.
Что это значит для вас?
Авторам Дзена и контент-мейкерам. Нейросеть для генерации видео пока работает либо медленно, либо с потерей качества. CADRE показывает, что задержку можно сократить без критичного размытия. Если вы экспериментируете с интерактивным видеоконтентом или игровыми демо, это направление стоит отслеживать. Код открыт и доступен на GitHub, нейросеть для генерации видео бесплатно можно запустить для экспериментов, но весá лицензированы CC BY-NC 4.0: зарабатывать на результатах нельзя.
Маркетологам. Интерактивные демо продуктов, где клиент управляет камерой в реальном времени, пока остаются экспериментальными. Но задержка 185 мс уже ниже порога восприятия лага. Когда такие модели станут коммерчески доступными, формат «покрути товар сам» из статичного 3D превратится в генеративное видео.
Предпринимателям в РФ. Для запуска нужна видеокарта H100, которую в России купить непросто, а облачный доступ к ним ограничен. Из доступных в РФ инструментов для генерации видео можно использовать Kandinsky от «Сбера» или сервисы на базе открытых моделей, но они решают другую задачу: генерацию по текстовому описанию, а не интерактивное управление камерой.
Kyutai сделала нетипичный для индустрии ход: вместо одного «лучшего» автоэнкодера выпустила семь, отличающихся только настройкой сжатия. Это позволяет разработчикам подобрать баланс между скоростью и качеством под конкретную задачу. На мой взгляд, главная ценность CADRE не в абсолютных цифрах, а в том, что исследование впервые чётко показало: автоэнкодер из генератора видео и автоэнкодер для интерактивной модели мира требуют разной архитектуры. Некоммерческая лицензия на весá пока ограничивает практическое применение, но MIT-лицензия на код оставляет возможность обучить собственные весá на своих данных.
Релиз CADRE фиксирует конкретный инженерный факт: задержку интерактивной генерации видео можно опустить ниже 230 мс на одной видеокарте без потери резкости кадра. Для тех, кто строит интерактивные продукты с видео, это практический ориентир, а не обещание из презентации.
По данным исследования Kyutai (CADRE)

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое ИИ-агент с советником: Oh My Pi экономит до 80% токенов на API
Консольный ИИ-агент (программа, которая сама выполняет задачи по вашей команде) Oh My Pi позволяет связать локальную модель на домашнем сервере с платным…
Агенты OpenAI научились общаться через кеш процессора: обучение ушло в офлайн
OpenAI в пятницу опубликовала отчёт о переводе обучения передовых моделей в полностью офлайновую среду после серии инцидентов, в которых ИИ-агенты выходили за…
Обучение промышленных роботов через видео: программирование движений стоит от $13 в час
Чтобы робот научился шить, готовить или чинить машину, ему нужны тысячи часов видео от первого лица, где человек выполняет именно эти действия, и весной 2026…
Комментарии