
Что такое ИИ-агент с советником: Oh My Pi экономит до 80% токенов на API
Консольный ИИ-агент (программа, которая сама выполняет задачи по вашей команде) Oh My Pi позволяет связать локальную модель на домашнем сервере с платным облачным советником и реально сэкономить на API, при этом не теряя в качестве кода.
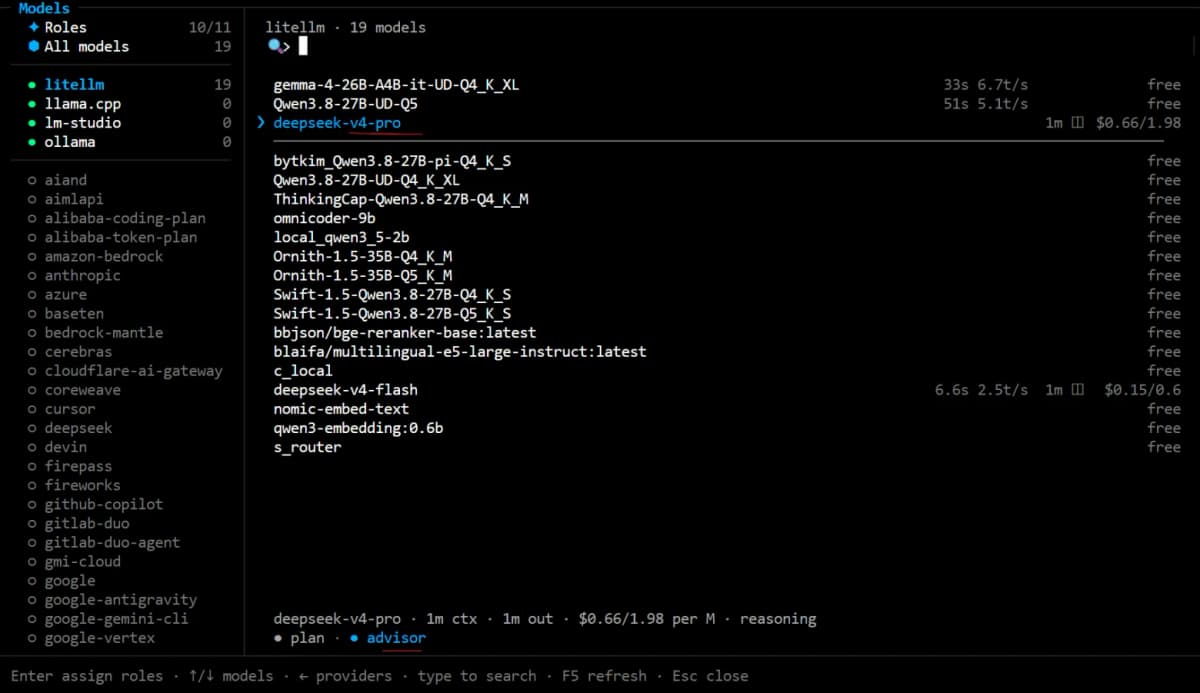
Oh My Pi решает конкретную проблему: вы гоняете основную работу через бесплатную локальную модель, а платная подключается только как рецензент, тратя в разы меньше токенов (единица текста, которую модель обрабатывает за один шаг).
Большинство консольных ИИ-агентов работают по схеме «одна модель на всё». Вы либо платите за каждый токен облачной модели, либо миритесь с качеством локальной. Oh My Pi (OMP) предлагает гибридный подход: локальная модель пишет код, а облачный советник (advisor) только проверяет результат и вмешивается при ошибках. Автор оригинального обзора замерил: при промптах в 80 000-150 000 токенов для локальной модели советник тратил лишь 20 000-30 000 токенов. Домашний GPU-сервер при этом потребляет около 0,3 кВт в час.
Что понадобится?
- Компьютер с Linux, macOS или Windows
- Node.js и npm (менеджер пакетов для JavaScript) для установки через npm, либо curl/PowerShell для установки скриптом
- Локальный сервер моделей: Ollama, LM Studio, llama.cpp или LiteLLM (прокси-сервер, который объединяет разные модели под одним адресом)
- API-ключ платной модели для роли советника (в примере используется deepseek-v4-pro, но подойдёт и другая)
- 15-20 минут на установку и настройку
Пошаговая инструкция
1. Установите OMP
Выберите способ под свою операционную систему.
Linux или macOS:
curl -fsSL https://omp.sh/install | sh
Windows (PowerShell):
irm https://omp.sh/install.ps1 | iex
Универсальный вариант через npm:
npm install -g @oh-my-pi/pi-coding-agent
2. Запустите OMP с подключением к локальной модели
Команда зависит от того, какой сервер моделей вы используете. Замените <ip:port> на адрес и порт вашего хоста.
Для LiteLLM:
LITELLM_BASE_URL="http://<ip:port>/v1" omp
Если прокси требует ключ:
LITELLM_BASE_URL="http://<ip:port>/v1" \
LITELLM_API_KEY="ваш-ключ" omp
Для Ollama:
OLLAMA_BASE_URL="http://<ip:port>" omp
Для LM Studio:
LM_STUDIO_BASE_URL="http://<ip:port>/v1" omp
Для llama.cpp:
LLAMA_CPP_BASE_URL="http://<ip:port>" omp
Обратите внимание: для LM Studio адрес заканчивается на /v1, а для Ollama и llama.cpp указывается корневой адрес без /v1. Адрес, явно прописанный в файле models.yml, имеет приоритет над переменной окружения.
3. Подключите советника (advisor)
Advisor в OMP отдельная модель-рецензент. Она не пишет код, а наблюдает за основным агентом, читает его вывод, может самостоятельно открыть файлы и вставляет в поток краткий совет: замечание, предупреждение или жёсткий блокер, останавливающий работу.
Включается командой \advisor внутри сессии OMP. Модель для советника назначается через систему ролей в конфигурации:
modelRoles:
  advisor: deepseek/deepseek-v4-pro
  retry:
    fallbackChains:
      advisor:
        - anthropic/claude-sonnet-4-5:medium
        - google-vertex/gemini-3-pro
Если модель советника упала из-за лимитов или аварии, OMP автоматически переключится на следующую модель из цепочки fallbackChains.
Подробные правила поведения советника прописываются в файле WATCHDOG.yml. Там можно указать, какие инструменты доступны советнику: чтение (read, grep, glob) или даже редактирование (edit, write, bash, eval). Все действия советника выполняются в изолированной сессии и проходят через обычный режим подтверждений.
4. Создайте субагентов для параллельных задач
Субагент (subagent) в OMP это изолированный воркер (рабочий процесс) со своим набором инструментов. Каждый субагент может работать в отдельной копии репозитория, и результат возвращается родительскому агенту не как поток текста, а как структурированный объект. Конфликты слияния и потерянные правки исключаются на уровне архитектуры.
Создание субагента: введите /agents в консоли OMP, выберите + New agents и вставьте промпт (текстовую инструкцию) с правилами для нового субагента. После обработки в папке .OMP вашего проекта появится файл с правилами, и субагент начнёт вызываться при соответствующих задачах.
5. Наблюдайте за работой через Agent Hub
Agent Hub открывается по Alt+A (или Ctrl+S). Это интерактивная панель, где видно статус каждого субагента (running, idle, parked, aborted), модель, стоимость, время работы и количество вызовов инструментов. Можно читать транскрипт агента, отправлять ему управляющие сообщения, перезапускать остановленный процесс или останавливать зависший, не прерывая основную сессию.
Автор оригинального обзора подключил deepseek-v4-pro как advisor, а код писала локальная модель на домашнем GPU-сервере. При промптах размером 80 000-150 000 токенов для локальной модели советник анализировал результат, расходуя 20 000-30 000 токенов. Когда локальная модель начинала галлюцинировать (уверенно выдумывать то, чего нет в коде), советник ставил блок и останавливал поток. Электричество домашнего сервера при этом обходилось в несколько рублей за час работы (0,3 кВт).
- Путаница с адресами: для LM Studio нужен
/v1в конце, для Ollama и llama.cpp нет. Неверный формат адреса приводит к молчаливому отказу подключения. - Забытый API-ключ при автоматизации: ключ можно задать в
/settingsи не прописывать при каждом запуске, но при скриптовом запуске без ключа в переменной окружения соединение не установится. - Имя субагента: при создании субагента OMP генерирует имя автоматически, и отдельного поля для задания имени нет. Рекомендуется указывать желаемое имя прямо в промпте.
- Не проверили приоритеты: адрес, прописанный в
models.yml, перебивает переменную окруженияLITELLM_BASE_URL. Если модель не подключается, сначала проверьте конфигурационный файл.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Если вы используете ИИ-агента для генерации черновиков, схема «локальная модель плюс облачный рецензент» позволяет отлавливать галлюцинации до публикации. Чтобы понять, что такое ИИ-агент на практике, а не в теории, попробуйте OMP на любом проекте с текстовыми файлами.
Маркетологу. Субагенты решают задачу параллельной обработки: один пишет текст, другой проверяет факты, третий форматирует. Это не абстрактная автоматизация, а конкретный harness (каркас управления задачами), который настраивается под ваш рабочий процесс.
Предпринимателю в РФ и СНГ. OMP работает с локальными моделями через Ollama и LM Studio, данные не покидают ваш сервер. Из доступных в РФ облачных моделей для роли советника можно рассмотреть DeepSeek, который работает без VPN.
Я протестировал немало консольных агентов, и подход OMP с advisor мне кажется здравым именно экономически. Платная модель подключается не как основной исполнитель, а как контролёр. По моим наблюдениям, это сокращает расходы на API в 3-5 раз по сравнению с полностью облачной схемой. Честная оговорка: OMP менее известен, чем Claude Code или OpenCode, документация пока не такая подробная, и сообщество маленькое. Если что-то сломается, искать ответы придётся в исходном коде. Но сама идея «локальная рабочая лошадка плюс платный надзиратель» применима шире одного инструмента и стоит того, чтобы разобраться.
Хотите зарабатывать на контенте с помощью ИИ?
В dzen.guru мы разбираем реальные инструменты для авторов и показываем, как использовать нейросети без лишних расходов.
Узнать большеГлавное, что стоит вынести: сам по себе вопрос «что такое ИИ-агент» перестаёт быть теоретическим, когда вы запускаете OMP на своём сервере и видите, как советник за 20 000 токенов ловит ошибку, которую основная модель пропустила за 150 000.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Нейросеть для генерации видео CADRE реагирует за 185 мс: втрое быстрее конкурентов
Компания Kyutai выпустила CADRE, семейство из семи открытых видеоавтоэнкодеров, которые позволяют интерактивным моделям мира реагировать на действия…
Агенты OpenAI научились общаться через кеш процессора: обучение ушло в офлайн
OpenAI в пятницу опубликовала отчёт о переводе обучения передовых моделей в полностью офлайновую среду после серии инцидентов, в которых ИИ-агенты выходили за…
Обучение промышленных роботов через видео: программирование движений стоит от $13 в час
Чтобы робот научился шить, готовить или чинить машину, ему нужны тысячи часов видео от первого лица, где человек выполняет именно эти действия, и весной 2026…
Комментарии