
Локальные нейросети и ИИ агенты на устройстве
Почему это важно Модель с 2 млрд активных параметров на каждый токен впервые конкурирует с нейросетями, у которых активных параметров на 50% больше, и при этом…
Модель с 2 млрд активных параметров на каждый токен впервые конкурирует с нейросетями, у которых активных параметров на 50% больше, и при этом целиком помещается на ноутбук без облака и без подписки.
Liquid AI выпустила LFM2.5-24B-A2B, открытую рассуждающую модель, которая запускает полноценных ИИ-агентов прямо на пользовательском устройстве, и сделала это в момент, когда бизнес всё острее нуждается в локальных нейросетях для работы с конфиденциальными данными.
Модель выложена на Hugging Face с открытыми весами (open weights, когда разработчик публикует параметры модели и любой может запустить её у себя). Она построена на архитектуре MoE (Mixture of Experts, «смесь экспертов», когда из 64 блоков-специалистов на каждый запрос активируются только 4, и модель работает быстро, хотя «знает» много). Контекстное окно выросло с 32 тыс. до 131 тыс. токенов (токен, минимальная единица текста для модели, примерно три четверти слова). Это значит: модель может «прочитать» и удержать в памяти текст размером с небольшую книгу.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| LFM2.5-24B-A2B, рассуждающая модель для локальных ИИ-агентов | Доступна на Hugging Face сейчас | Liquid AI | Бесплатно, открытые веса |
Что умеет модель и чем отличается от предшественника?
-
Рассуждает перед ответом. Модель всегда выстраивает цепочку рассуждений (chain of thought) до финального ответа. Предыдущая версия так не работала.
-
Скорость на ноутбуке. По данным Liquid AI, на Apple M5 Max модель выдаёт 184 токена в секунду, на AMD Ryzen AI Max+ 395 составляет 114 токенов в секунду. Это, по заявлению разработчиков, до 1,7 раза быстрее ближайшего конкурента сопоставимого размера при меньшем расходе памяти.
-
Скорость на серверном GPU. На одном NVIDIA B300 модель достигает 21 тыс. токенов в секунду при высокой параллельной нагрузке.
-
Агентные задачи на уровне более крупных моделей. На бенчмарке LiveClaw (тест на работу ИИ-агента в реальном времени) LFM2.5-24B-A2B набрала 48,09 балла против 38,19 у Qwen3.6-35B-A3B, модели с примерно на 50% большим числом общих и активных параметров. На бенчмарке AutomationBench результат превышает показатель ближайшего конкурента более чем втрое.
-
Словарь удвоен. Объём словаря вырос с 65 тыс. до 128 тыс. токенов, что улучшает работу с нелатинскими языками, включая русский.
-
Обучение на вдвое большем корпусе. Объём данных предобучения вырос с примерно 17 трлн до примерно 33 трлн токенов. Дообучение (fine-tuning, обучение модели на ваших примерах под узкую задачу) включало пять этапов, в том числе агентное обучение с подкреплением внутри реальных «обвязок» для агентов.
-
Слабые стороны названы честно. По данным Liquid AI, на задачах, требующих глубоких знаний (GPQA Diamond, HLE) и на бенчмарках по коду (SWE-Bench Verified, SciCode), более крупные модели сохраняют преимущество. Разработчик рекомендует дополнять LFM2.5-24B-A2B поиском или базой знаний для таких задач.
Примечательно, что Liquid AI сразу указала ограничения модели и дала рекомендацию по их обходу. Для локальных нейросетей это редкость: обычно слабые места прячут за общими формулировками.
Как попробовать?
-
Скачайте модель с Hugging Face. Доступны две версии: базовая (LFM2.5-24B-A2B-Base) и инструктивная (LFM2.5-24B-A2B). Обе с открытыми весами.
-
Установите библиотеку transformers версии 5.0.0 или новее командой
pip install -U transformers. Модель также работает через llama.cpp, MLX, vLLM, SGLang и ONNX. -
Запустите локально и подключите к агентной обвязке. Например, через Hermes Agent: укажите адрес локального сервера, имя модели и длину контекста 131 072 токена. Подробные конфигурации для разных обвязок есть в карточке модели на Hugging Face.
-
Дообучите под свою задачу, если нужно: Liquid AI опубликовала руководства по дообучению (fine-tuning tutorials) на странице проекта.
Есть ли аналог в России?
Для аудитории, которая работает из РФ и СНГ, вопрос практический: можно ли получить похожие возможности без скачивания зарубежной модели?
| Параметр | LFM2.5-24B-A2B (Liquid AI) | YandexGPT | GigaChat (Сбер) |
|---|---|---|---|
| Работает локально | Да, на ноутбуке | Нет, только облако | Нет, только облако |
| Открытые веса | Да | Нет | Нет |
| Агентные задачи | Заточена специально | Ограниченно | Ограниченно |
| Русский язык | Улучшен (расширенный словарь) | Родной | Родной |
| Конфиденциальность данных | Данные не покидают устройство | Данные на серверах Яндекса | Данные на серверах Сбера |
Главное отличие: YandexGPT и GigaChat работают только через облако, а значит, данные уходят на сервер. Локальные нейросети вроде LFM2.5-24B-A2B позволяют держать всё на своём устройстве, и это принципиально для тех, кто работает с персональными или корпоративными данными.
Я вижу два конкретных сценария для наших читателей. Первый: автор Дзена, который использует ИИ для подготовки черновиков, проверки фактов или генерации идей, теперь может делать это без подписки и без отправки текстов в облако. Второй: предприниматель в РФ, который обязан хранить клиентские данные на территории страны, получает модель, которую можно развернуть на собственном сервере или даже на рабочем ноутбуке.
Оговорка честная: для запуска на полной скорости нужен MacBook на M5 Max или аналогичное железо с большим объёмом оперативной памяти. На среднем офисном ноутбуке модель будет работать, но медленнее. Кроме того, модель слабее крупных конкурентов в задачах на глубокие знания и написание кода, как признают сами разработчики.
Что сделать сегодня: если у вас MacBook на Apple Silicon или мощная рабочая станция с AMD, скачайте модель и попробуйте через llama.cpp. Если железо послабее, дождитесь квантизованных (сжатых) версий, они обычно появляются в сообществе в первые недели после релиза.
Частые вопросы
Нужна ли видеокарта для запуска?
Нет. Модель работает на CPU через llama.cpp и MLX. На Apple M5 Max она выдаёт 184 токена в секунду без видеокарты. Но на мощном GPU (например, NVIDIA B300) скорость вырастает кратно, до 21 тыс. токенов в секунду при высокой нагрузке.
Модель понимает русский язык?
Словарь модели удвоен до 128 тыс. токенов специально для улучшения работы с нелатинскими языками. Liquid AI не публикует отдельные бенчмарки по русскому, но расширение словаря прямо указано как мера для улучшения работы с такими языками. Проверить качество русского можно бесплатно сразу после скачивания.
Чем это отличается от ChatGPT или Claude?
ChatGPT и Claude работают в облаке: вы отправляете запрос на сервер компании, получаете ответ. LFM2.5-24B-A2B запускается целиком на вашем устройстве. Данные никуда не уходят. Платить за токены не нужно. Взамен вы ограничены мощностью своего железа и получаете модель, которая уступает крупным облачным нейросетям на задачах, требующих энциклопедических знаний.
Для тех, кому конфиденциальность данных важнее абсолютного качества ответов на общие вопросы, локальные нейросети такого класса становятся рабочим инструментом, а не экспериментом.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Дипфейк Мии Гот обманул СМИ и миллион подписчиков: Instagram удалил фото только после запроса журналистов
Почему это важно Фейковое фото реального человека собрало сотни тысяч лайков, попало в крупные СМИ и несколько дней считалось настоящим, потому что аккаунт…
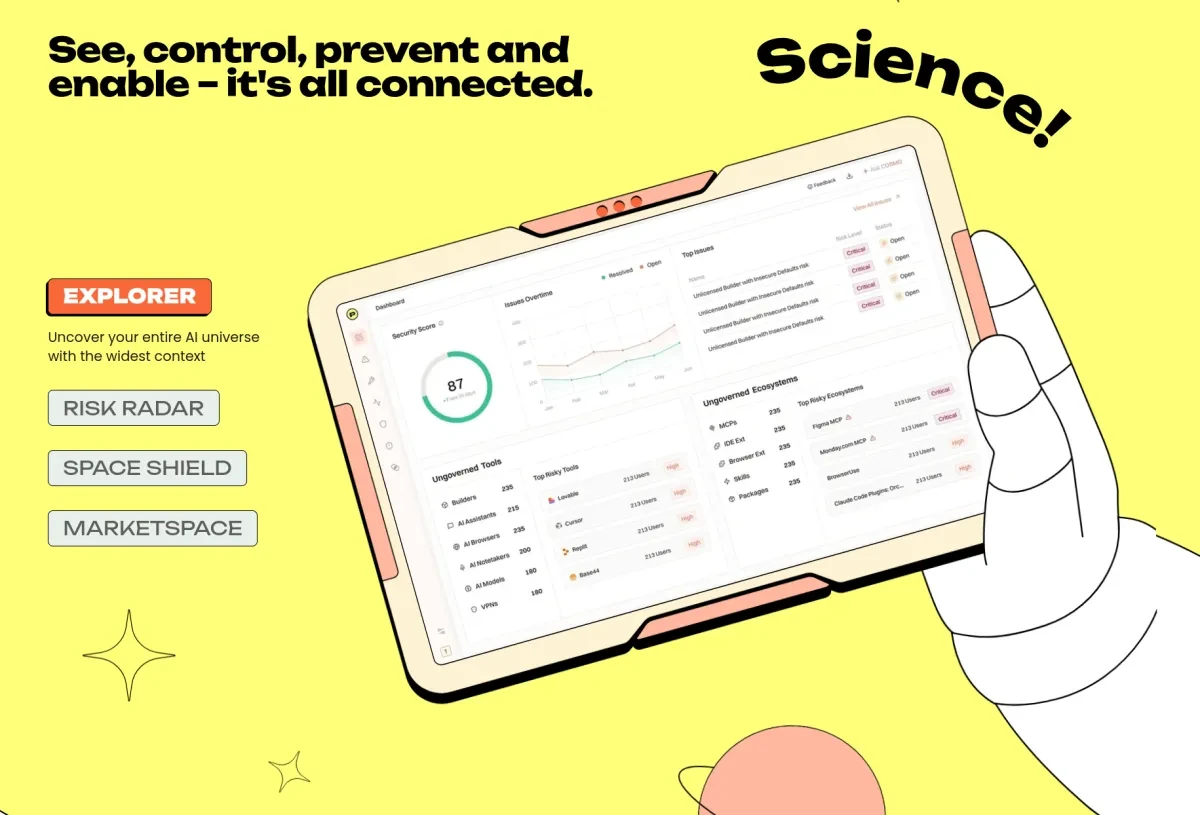
Pluto Security привлекла $42 млн на безопасность ИИ: 60% рисков создают не разработчики
Pluto Security, стартап из Израиля и США, 3 июня вышла из режима скрытности с суммарным финансированием в 42 млн долларов, чтобы закрыть одну из самых…
Gemini 4 вышла в открытый доступ: промо-цена $2 за 1 млн токенов удвоится в декабре
Почему это важно Google выпустила модель, которую сама же считает потенциально опасной без защитных мер, и одновременно установила промо-цену, которая удвоится…
Комментарии