
Fable 5.2 вернула Anthropic первое место перед IPO: токены дешевле на 20%, задача дороже
Anthropic в день, когда начались встречи с инвесторами перед выходом на биржу, выпустила Claude Fable 5.2 и отобрала первое место у Gemini 4 Carbon, продержавшейся на вершине всего 10 дней.
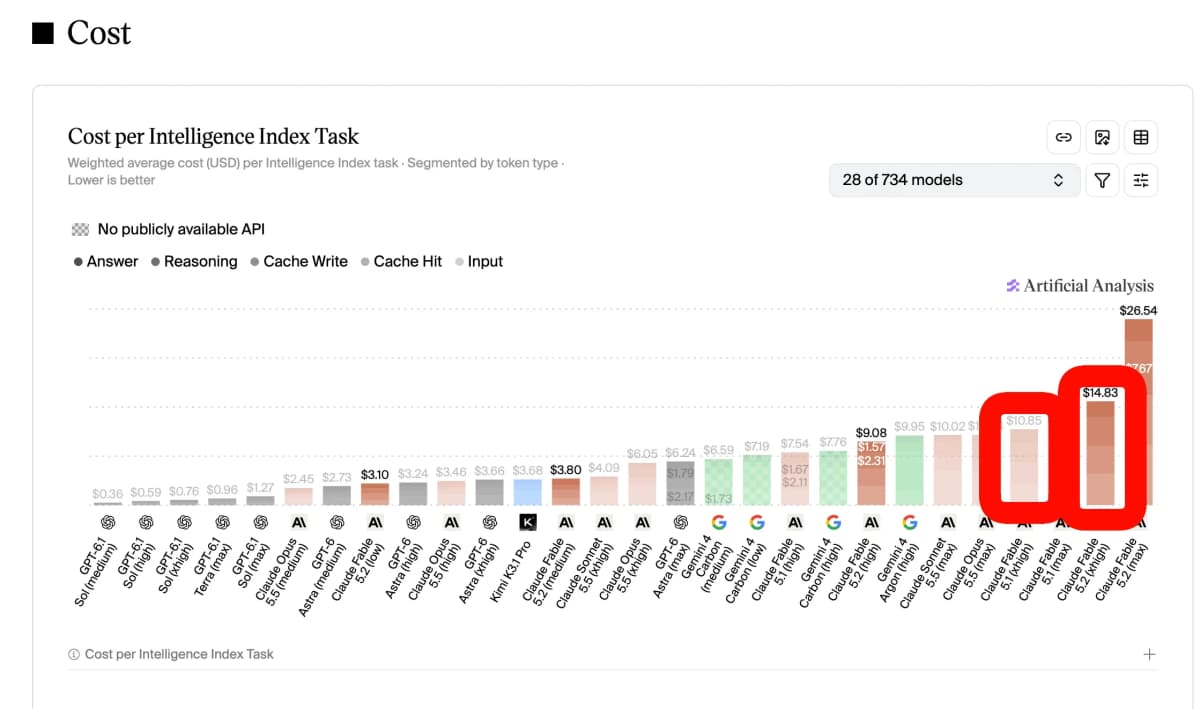
Вместе с Fable вышла Claude Mythos 5.2. Обе модели, по системной карточке, работают на одной общей базовой модели. Выпуск рассылки AINews (раздел издания Latent Space) вышел под заголовком [AINews] Fable 5.2 retakes World #1 LLM spot as $ANT IPO roadshow begins, то есть «Fable 5.2 возвращает первое место среди языковых моделей, пока стартует роудшоу перед IPO Anthropic». Главная деталь выпуска: токены подешевели на 20%, а одна задача обходится дороже, чем раньше.
| Показатель | Значение | Источник |
|---|---|---|
| Цена Fable 5.2 за 1 млн токенов, вход и выход | 8 и 40 долларов | Anthropic, Artificial Analysis |
| Цена Fable 5.1 за 1 млн токенов, вход и выход | 10 и 50 долларов | Anthropic, Artificial Analysis |
| Intelligence Index v5 | 65 у Fable 5.2, 60 у Gemini 4 Carbon, 59 у Opus 5.5, 57 у GPT-6 Astra | Artificial Analysis |
| Стоимость одной задачи на GDPx | 88,15 доллара против 67,16 у Fable 5.1 | SemiAnalysis |
| Результат на GDPx | первое место, 16,4% | SemiAnalysis |
| Стоимость задачи на уровне max | около 26,5 доллара, у Opus 5.5 около 10 | Artificial Analysis |
| Epoch Capabilities Index | 174 против 169 у GPT-6 Astra | Epoch AI |
| Скорость выдачи текста | до 30% быстрее моделей 5.1 | Anthropic, данные разработчика |
| Контекст | 1 млн токенов, текст и изображения | Artificial Analysis |
Что измеряли?
Независимые лаборатории прогнали модель через бенчмарки, то есть стандартные наборы задач, на которых сравнивают нейросети. Artificial Analysis сводит десяток таких тестов в общий индекс интеллекта. SemiAnalysis проверяет модель на GDPx, наборе профессиональных задач, и считает, сколько денег уходит на одну задачу.
Цена здесь считается в токенах. Токен (кусочек слова, в которых нейросеть меряет и текст, и счёт) оплачивается отдельно на входе и на выходе. Чем дольше модель «думает» и проверяет себя, тем больше токенов она тратит.
У Fable 5.2 пять уровней усилия: low, medium, high, xhigh и max. Уровень задаёт, сколько работы модель вкладывает в ответ. В приложениях Claude и в Claude Code по умолчанию стоит medium.
Что обнаружили?
- Первое место в индексе. Fable 5.2 на уровне max набрала 65 баллов в индексе Artificial Analysis против 60 у Gemini 4 Carbon и 49 у своей предшественницы Fable 5.1.
- Дешевле токен, дороже задача. На GDPx задача стоила 88,15 доллара вместо 67,16, хотя тариф снизился с 10 и 50 до 8 и 40 долларов.
- Самопроверка как причина. По логам SemiAnalysis, Opus 5.5 и Fable 5.1 пробовали около 20 тестовых случаев, а 5.2 иногда писала сотни и тысячи. Ещё она запускала субагентов (вспомогательных ИИ-агентов, которые независимо перепроверяют её работу).
- Средний уровень экономнее. На high и xhigh модель набирает 62 балла и тратит около 98 тысяч выходных токенов на задачу, а Opus 5.5 на max тратит 173 тысячи.
- Максимум дорогой. На max задача обходится примерно в 26,5 доллара, это около 2,6 раза дороже Opus 5.5 и вдвое дороже Fable 5.1.
- Слабые места. На Terminal-Bench 4.0 у модели 60%, вровень с Opus 5.5 и ниже Kimi K3.1 Pro с 67%. На GDP.pdf у неё 24% против 26% у Opus 5.5.
Anthropic отдельно сообщает, что Fable на уровне high повторила результат Opus 5.5 на max на тесте FrontierCode 2.0 примерно за половину стоимости задачи. Про стоимость самого уровня max компания в этом сравнении молчит, и AINews это прямо подчёркивает.
Часть громких цифр дал сам разработчик: ускорение до 30%, половина стоимости на FrontierCode 2.0, формализация доказательства теоремы Ферма силами 1000 агентов за 30 часов. Независимые замеры подтверждают лидерство, но показывают, что по цене за задачу модель обходится дороже предшественницы, а в части тестов уступает конкурентам.
Есть и ограничения доступа. По подписке Fable может расходовать только 50% недельного лимита. Тарифы Pro и Team Standard получают неделю пробного доступа с потолком в половину лимита. Данные по умолчанию хранятся на серверах Anthropic, чтобы работали фильтры безопасности. Отказ от хранения доступен только подходящим корпоративным клиентам.
Первым днём модель появилась в Cursor, GitHub Copilot, Perplexity, Factory и на агрегаторе OpenRouter. Запуск совпал с первым днём роудшоу (серии встреч с инвесторами перед IPO, первичным размещением акций на бирже), и это совпадение явно не случайное.
Что это значит для вас?
Автору Дзена. Для статей, сценариев и рубрик хватит уровня medium. Максимальный уровень нужен для длинной аналитики и сверки фактов, и платить за него придётся заметно больше.
Маркетологу. Считайте бюджет по стоимости готовой задачи, а не по тарифу за токен. Скидка в 20% съедается, если модель на каждую задачу пишет тысячи проверок.
Предпринимателю РФ и СНГ. Источник не сообщает, доступна ли модель в России. Учтите обязательное хранение данных: клиентские документы через такой сервис лучше не прогонять. Из доступных в РФ аналогов есть YandexGPT и GigaChat.
На мой взгляд, главная новость тут не первое место, а экономика. Модель стала умнее за счёт того, что больше проверяет себя, и счёт за эту самопроверку платите вы. Gemini 4 Carbon лидировала 10 дней, и я не жду, что Fable продержится сильно дольше. Для работы с текстами я бы поставил high и сравнил результат с medium на десятке своих задач.
Проведите такой тест на своих задачах до того, как переводить на модель всю работу: разницу между уровнями лучше увидеть в собственном счёте, чем в чужом рейтинге.
По данным AINews (Latent Space)

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-агент Grok Bot звонит вместо человека: за каждый звонок отвечает пользователь
Компания SpaceXSI научила Grok Bot звонить вместо человека на номера в США для платных подписчиков, пока конкуренты движутся туда же, а юридическую…
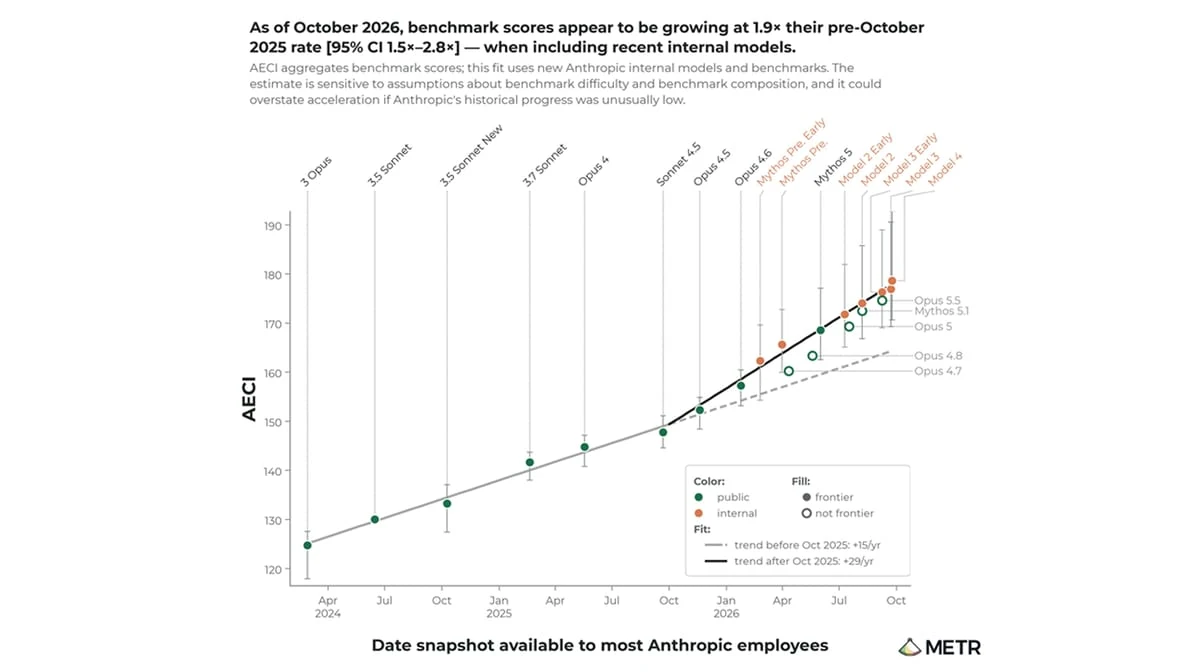
METR: Anthropic разрабатывает ИИ вдвое быстрее, внутри есть модели сильнее Claude
METR, некоммерческая организация по проверке ИИ, после 11 недель внутри Anthropic оценила, что компания разрабатывает ИИ примерно вдвое быстрее прежнего и,…
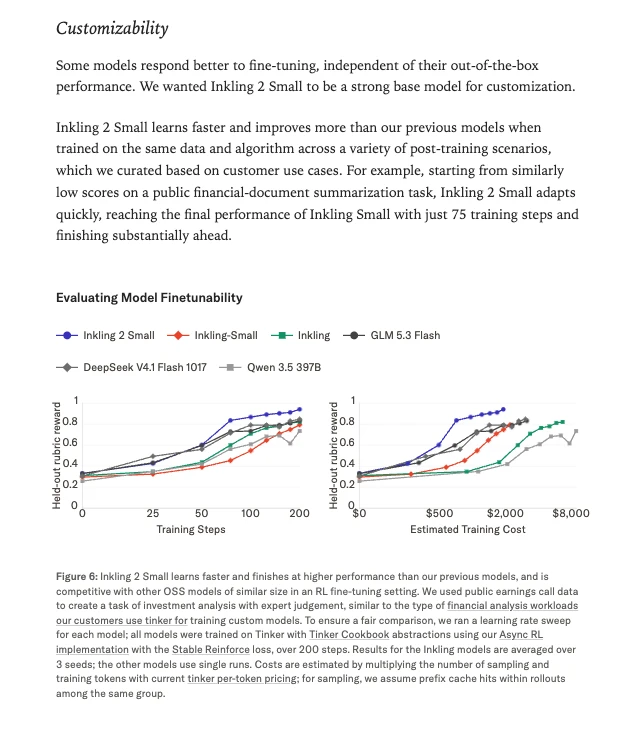
Нейросеть Inkling 2 Small выдумывает вдвое реже: задача стоит $1,18 против $7,77 у Gemini
Thinking Machines выпустила Inkling 2 Small, мультимодальную нейросеть на 594 млрд параметров, которую уже можно дообучать через сервис Tinker, а открытые веса…
Комментарии