
API-шлюз для AI в компании: как не слить данные и не попасть на штраф от 20 млн ₽
Когда к языковым моделям в компании подключаются десятки команд, IDE и внутренние автоматизации, личные ключи и устные договорённости перестают работать, и здесь нужен API-шлюз (API Gateway), единая точка, через которую проходит каждый запрос к любой модели.
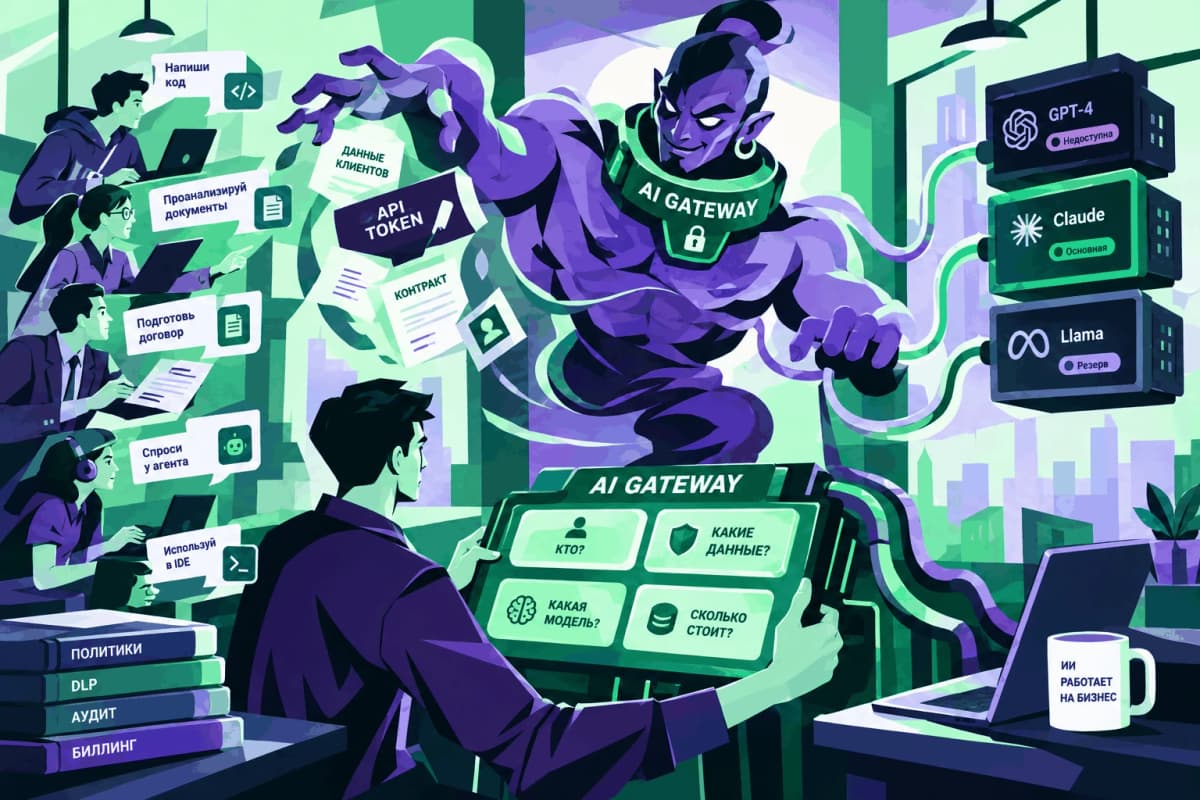
ChatGPT официально недоступен в России, и сотрудники обращаются к нему через неуправляемые каналы. API-шлюз для ИИ закрывает эту брешь: проверяет данные до отправки, обезличивает персональную информацию и позволяет компании избежать оборотных штрафов за утечки, которые начинаются от 20 млн рублей по 152-ФЗ «О персональных данных».
Назар Башинский, разработчик компании AGIMA, описал на Хабре, как устроен корпоративный API-шлюз для работы с LLM (большими языковыми моделями). Суть простая: между сотрудником и моделью встаёт управляемый слой, который решает, кому что разрешено, какие данные можно отправлять, а какие нужно замаскировать, и к какому провайдеру направить запрос. На фоне того, что российские компании обязаны соблюдать 152-ФЗ, а привычный ChatGPT здесь заблокирован, такой шлюз из удобства превращается в необходимость.
Зачем шлюз, если можно просто раздать доступ?
API-шлюз для ИИ не делает модель умнее. Он делает использование моделей наблюдаемым и управляемым. Перед каждым запросом шлюз принимает цепочку решений:
- Кто делает запрос и из какого инструмента.
- К каким моделям и функциям у этого пользователя есть доступ.
- Содержит ли запрос персональные данные, токены (уникальные ключи доступа), секреты или клиентскую информацию.
- Нужно ли замаскировать часть данных до отправки.
- Какая модель подходит по качеству, стоимости и скорости отклика.
- Куда переключиться, если основной провайдер недоступен.
- Как отнести стоимость запроса на конкретную команду или проект.
По описанию Башинского, рынок уже видит LLM не как отдельный чат, а как трафик, который нужно контролировать. Cloudflare AI Gateway предлагает аналитику, логи, кеширование и fallback (автопереключение на резервную модель). Kong выделяет маршрутизацию и governance (управление политиками) для ИИ-трафика. Microsoft показывает шлюзовые паттерны в Azure API Management с лимитами токенов и балансировкой нагрузки.
Что понадобится
- Доступ к провайдеру моделей. Любой совместимый с форматом OpenAI API: облачный или локальный. Для России это могут быть китайские провайдеры или собственные развёрнутые модели с открытыми весами (open weights, когда параметры модели опубликованы и можно запустить её на своём сервере).
- Сервер или облачная виртуальная машина для размещения шлюза.
- Шлюзовое решение. Открытые варианты: Kong AI Gateway, LiteLLM Proxy. Облачные: Cloudflare AI Gateway, Azure API Management.
- Настроенная служба авторизации (LDAP, SSO или API-ключи по командам).
- DLP-модуль или правила фильтрации (DLP, предотвращение утечки данных, система, которая ловит пароли, персональные данные и секреты до того, как они уйдут наружу).
- Время: базовая настройка занимает от нескольких часов до пары дней, в зависимости от числа команд и политик.
Пошаговая инструкция
-
Определите контур данных и юридические рамки. Согласуйте с отделом информационной безопасности и юристами, какие данные допустимо отправлять внешнему провайдеру, а какие должны оставаться внутри периметра. Для сценариев с персональными данными проверьте требования 152-ФЗ по трансграничной передаче.
-
Выберите и разверните шлюз. Установите выбранное решение на сервер. Укажите адрес вашего провайдера моделей как upstream (точку назначения):
# Пример: LiteLLM Proxy, файл config.yaml
model_list:
  - model_name: "gpt-4o"
    litellm_params:
      model: "openai/gpt-4o"
      api_base: "https://your-provider.example.com/v1"
      api_key: "sk-YOUR-KEY"
-
Настройте авторизацию и лимиты. Создайте виртуальные ключи для каждой команды или проекта. Задайте квоты: максимальное число токенов в сутки, допустимые модели, бюджетный потолок.
-
Подключите DLP-фильтрацию. Добавьте правила, которые перехватывают запросы с паролями, ключами, номерами паспортов и другими чувствительными сущностями. Настройте действие: блокировать запрос или заменить найденные данные на маркеры-заглушки до отправки модели.
-
Перенаправьте клиентские инструменты на шлюз. В IDE, чатах и скриптах сотрудников замените прямой адрес провайдера на адрес вашего шлюза:
# Было (прямой вызов)
OPENAI_API_BASE=https://api.openai.com/v1

# Стало (через корпоративный шлюз)
OPENAI_API_BASE=https://ai-gateway.your-company.ru/v1
Для пользователя меняется только адрес и токен. Инструмент продолжает работать как раньше.
-
Настройте маршрутизацию и fallback. Укажите, какие запросы идут к какому провайдеру. Добавьте резервную модель: если основной провайдер не отвечает, шлюз автоматически переключается на запасной.
-
Включите аудит и биллинг. Каждый запрос должен записываться в лог с указанием пользователя, команды, модели и количества потраченных токенов. Это позволяет видеть реальную экономику: сколько тратит каждый отдел и на какие задачи.
Разработчик в IDE пишет код и вызывает автодополнение. Запрос уходит не напрямую к провайдеру, а на адрес корпоративного шлюза. Шлюз проверяет: пользователь авторизован, его команда имеет доступ к выбранной модели, лимит токенов не исчерпан. DLP-модуль обнаруживает в промпте (тексте запроса к модели) фрагмент клиентского договора с ФИО и номером паспорта. Шлюз заменяет эти данные на маркеры вида [PII_NAME_1], [PII_DOC_1] и только после этого отправляет запрос модели. Ответ возвращается разработчику, а в лог записывается: кто, когда, какая модель, сколько токенов потрачено, сработало ли DLP-правило.
Проверка только после отправки. Если в промпт попал API-токен или фрагмент клиентского договора, увидеть это в логах постфактум уже поздно: данные ушли к внешнему провайдеру. Фильтрация должна работать до выхода запроса наружу.
Ложная совместимость при смене провайдера. По описанию Башинского, на бумаге китайские провайдеры заявляют совместимость с форматом OpenAI API, но часть функций (веб-поиск, распознавание изображений) может отсутствовать или работать иначе. Тестируйте каждый сценарий отдельно, не верьте спецификациям.
Запрет вместо контроля. Простой запрет на использование ИИ не работает: сотрудники находят обходные пути, и компания теряет контроль полностью. Шлюз даёт третий вариант между «запретить всё» и «разрешить всё».
Игнорирование юридической стороны. Не каждый промпт с именем создаёт юридическую проблему, но состав данных, цель обработки и контур передачи нужно проверять с юристами до запуска, а не после первого инцидента.
Что делать с этим прямо сейчас, по ролям?
Автору на Дзене и копирайтеру. Если вы работаете с ИИ через браузерные чаты и отправляете туда тексты клиентов, подумайте, что именно уходит наружу. Даже фрилансеру полезно понимать, как работает API-шлюз для ИИ: ваш заказчик из крупной компании может потребовать работу только через корпоративный контур.
Маркетологу и руководителю отдела. Шлюз позволяет увидеть, сколько реально тратит каждая команда на запросы к моделям, и перераспределить бюджет. Без него расходы на ИИ остаются невидимой статьёй.
Предпринимателю и техдиректору в РФ. ChatGPT официально недоступен, а штрафы за утечку персональных данных начинаются от 20 млн рублей (по данным из источника, это оборотные штрафы за повторные нарушения). Развёрнутый внутри периметра API-шлюз для ИИ закрывает и юридический, и операционный риск. Из доступных в России вариантов можно рассмотреть собственный шлюз на базе LiteLLM Proxy с подключением к YandexGPT, GigaChat или моделям с открытыми весами.
По моим наблюдениям, большинство российских компаний до сих пор находятся на стадии «личные ключи и устные договорённости». Это работает, пока пользователей три-пять человек. Как только число подключённых команд переваливает за десяток, начинаются проблемы: непонятные счета, утечки данных, невозможность понять, кто и что отправляет наружу. Шлюз не решает проблему выбора модели и не делает ответы точнее. Но он превращает хаотичное использование ИИ в управляемый процесс. Честная оговорка: настройка DLP-правил требует участия безопасников и юристов, а не только разработчиков. Без них шлюз будет пропускать то, что должен ловить.
Башинский точно обозначил ключевую мысль: шлюз нужен не для того, чтобы модель стала умнее, а для того, чтобы компания понимала, что происходит с её данными и деньгами. Для российского рынка, где привычный ChatGPT заблокирован, а закон о персональных данных работает с оборотными штрафами, это не вопрос удобства, а вопрос выживания корпоративного ИИ-контура.
Нейросети для авторов: как использовать ИИ в работе на Дзене
Разбираем реальные сценарии, промпты и инструменты, которые помогают авторам Дзена работать быстрее и не нарушать правила площадки.
Узнать больше
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
AI видимость бренда зависит от истории чата: эксперимент на 45 диалогах
Маркер Markdown-тела начинается ниже. Если вы измеряете, как часто нейросеть упоминает ваш бренд, но задаёте ей только одиночные запросы без контекста,…
277 часов с нейросетью для тестирования: 94 бага найдены, но человек потратил ещё 213 часов рядом
Компания Anthropic не выпускала новый продукт и не объявляла релиз. Речь о другом: практик-тестировщик 11 недель вёл дневник совместной работы с Claude Code и…
Провалы виртуальной стены на границе
Американское правительство потратило миллиарды долларов на «виртуальную стену» из камер наблюдения с искусственным интеллектом вдоль южной границы, но…
Комментарии