
AI видимость бренда зависит от истории чата: эксперимент на 45 диалогах
Маркер Markdown-тела начинается ниже.
Если вы измеряете, как часто нейросеть упоминает ваш бренд, но задаёте ей только одиночные запросы без контекста, результаты могут не совпадать с тем, что видит реальный пользователь в диалоге с историей.
Эксперимент на 45 диалогах с ChatGPT, Perplexity и Алисой AI показал: один и тот же финальный вопрос о CRM для России даёт разный набор брендов в зависимости от того, какие реплики шли до него. Замер AI-видимости по изолированным промптам может недооценивать или переоценивать присутствие бренда.
Стандартная методика оценки AI-видимости (AI Visibility, то есть того, насколько часто бренд появляется в ответах нейросетей) опирается на фиксированный набор независимых промптов. Каждый запрос отправляют в чистый чат, повторяют несколько раз и считают частоту упоминаний. Автор исследования проверил, что происходит, если перед тем же коммерческим вопросом идёт управляемая история разговора. Результаты опубликованы в разборе методики замера AI-видимости брендов.
Как был устроен эксперимент?
Финальный промпт во всех сценариях был одинаковым:
Какие CRM-системы ты бы рассматривал для компании в России?
Перед ним шли разные «предыстории»:
- S0 (контроль): чистый чат, сразу финальный вопрос, без контекста.
- S1: система заранее узнавала, что речь о небольшой B2B-компании с восемью продавцами, которая не хочет сложного внедрения.
- S5: контекст описывал B2B-услуги с длинным циклом сделки в несколько месяцев, множеством звонков, писем и повторных контактов.
- S9: пользователь нейтрально упоминал одну CRM, говорил, что ничего о ней не знает, и просил посмотреть рынок шире.
- S11: нейросеть сама называла несколько CRM, потом разговор уходил к принципам выбора и завершался тем же финальным вопросом.
На каждый сценарий приходилось три новых чата в каждой из трёх систем. Итого 45 диалогов. Отправку реплик и сохранение ответов выполнял ChatGPT Work по заранее заданному протоколу; исследовательский вопрос, критерии и выводы автор определял сам.
Три уровня упоминания бренда
Не каждое появление названия CRM в ответе весит одинаково. Автор разделил упоминания на три уровня:
- Mention (упоминание): бренд просто встретился в тексте.
- Consideration (рассмотрение): система включила продукт в набор вариантов.
- Recommendation (рекомендация): продукт привязан к условиям пользователя и получил явное обоснование.
Основной единицей сравнения стал набор брендов на уровне Consideration и выше: CRM, которые система действительно предлагала рассмотреть.
Даже без контекста ответы «плывут»
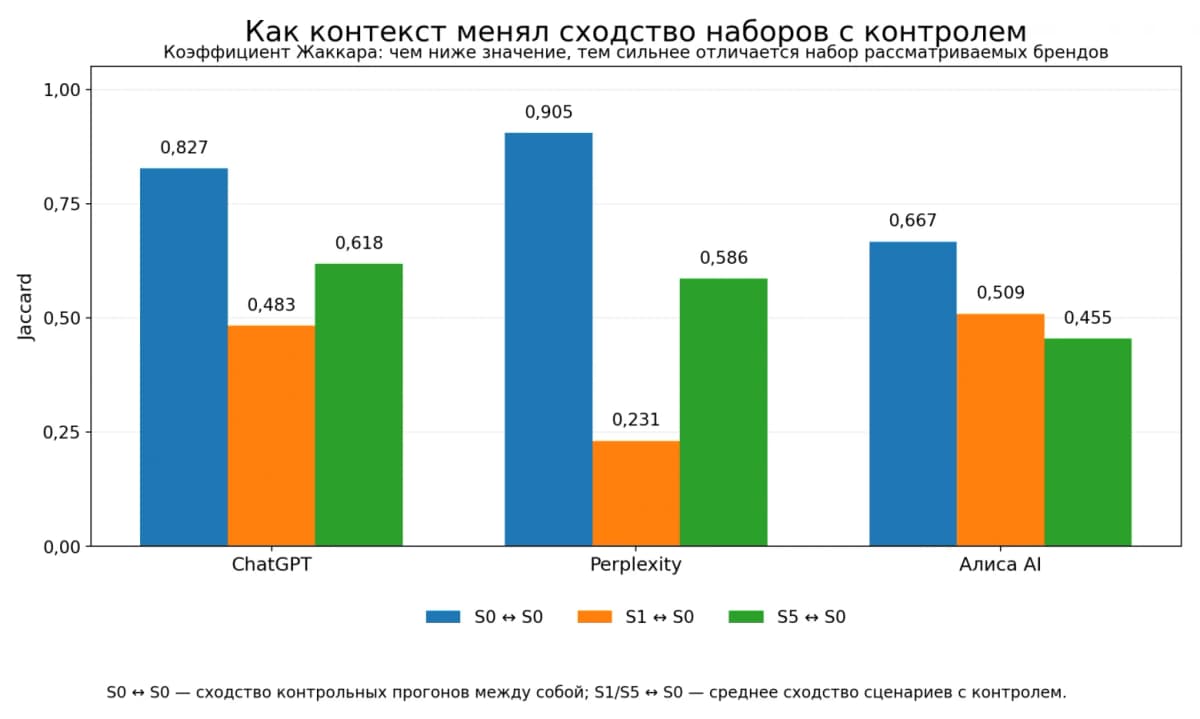
Прежде чем сравнивать сценарии, автор измерил разброс внутри контрольных прогонов S0. Для этого использовался коэффициент Жаккара (Jaccard), который показывает долю совпадений между двумя наборами: 1 означает полное совпадение, 0 означает ни одного общего бренда.
- Perplexity: средний Jaccard между контрольными прогонами составил 0,905. Устойчивый набор из 7 CRM, первым трижды был amoCRM.
- ChatGPT: 0,827. Тоже 7 CRM, первым во всех трёх случаях оказался Битрикс24.
- Алиса AI: 0,667. Набор шире, первая позиция менялась.
Уже здесь видно: одного ответа на один промпт для оценки AI-видимости недостаточно, потому что состав брендов меняется даже при неизменном запросе.
Контекст меняет списки заметнее, чем случайный разброс
В сценарии S1 (небольшая компания, простое внедрение) различия оказались значительно сильнее естественного разброса.
ChatGPT. Среднее сходство контекстных наборов с контрольными упало до 0,483 (против 0,827 между контрольными). Списки сократились до трёх-четырёх CRM. amoCRM, Битрикс24 и Мегаплан вошли во все три ответа.
Perplexity. Сходство упало до 0,231 (против 0,905). В каждом прогоне система оставляла четыре CRM. В среднем сохранялось два бренда из контрольного набора, пять исчезали и два новых появлялись.
Алиса AI. Разница была мягче: сходство 0,509 (против 0,667). Списки оставались длиннее, по семь-восемь вариантов.
Значения получены не из одного сравнения, а из всех девяти пар (три контекстных прогона к трём контрольным). Финальный вопрос не менялся, но набор брендов, которые система предлагала рассмотреть, изменился ощутимо.
Что делать с этим прямо сейчас?
Автору Дзена и копирайтеру. Если вы пишете обзоры продуктов или сервисов и хотите, чтобы нейросети упоминали ваш бренд, проверяйте AI-видимость не одним изолированным промптом, а серией диалогов с разным контекстом. Один замер в чистом чате покажет только часть картины.
Маркетологу. Стандартные отчёты по AI Visibility, построенные на независимых запросах, могут завышать или занижать присутствие бренда. Добавьте в протокол замеры с контекстными сценариями: «малый бизнес ищет простое решение», «крупная компания с длинным циклом сделки». Это ближе к тому, как реальные пользователи разговаривают с чатами.
Предпринимателю в РФ. Эксперимент проводился именно на российских CRM (Битрикс24, amoCRM, Мегаплан и другие), так что результаты напрямую применимы к вашему рынку. Если вы продвигаете продукт и отслеживаете, как его «видят» нейросети, учитывайте: ваш конкурент может появляться в ответах чаще просто потому, что пользователь задал предварительный вопрос, а не потому, что конкурент лучше оптимизирован.
В контрольном прогоне S0 ChatGPT предлагал набор из семи CRM. В сценарии S1, где перед тем же вопросом шёл контекст о небольшой команде без сложного внедрения, список сократился до трёх-четырёх. Бренды, которые стабильно попадали в контрольные ответы, исчезли, а на их месте появились другие. Один и тот же промпт, разный диалог, разный результат замера AI-видимости в чате.
Самая распространённая: принимать один ответ нейросети за устойчивый результат. Даже три контрольных прогона одного запроса дают разный состав брендов (коэффициент Жаккара у Алисы AI всего 0,667). Ещё одна ловушка: сравнивать AI-видимость разных брендов без учёта того, какой контекст предшествовал запросу. Бренд, который «выигрывает» по изолированным промптам, может проигрывать в диалогах, где пользователь описал свою ситуацию.
Это исследование ставит важный вопрос для всех, кто занимается AI-видимостью в чатах: мы замеряем присутствие бренда в условиях, которые не совпадают с реальным пользовательским поведением. Люди не приходят в ChatGPT или Perplexity с одним голым вопросом. Они ведут разговор: описывают свой бизнес, уточняют задачу, упоминают то, что уже слышали. И этот контекст перекраивает список рекомендаций. По моим наблюдениям, в России мало кто учитывает это при оценке AI-видимости. Попробуйте добавить хотя бы два-три контекстных сценария к своим замерам. Честная оговорка: исследование проведено на 45 диалогах, и автор прямо указывает, что CRM использовалась как экспериментальный стенд, а не как оценка качества самих систем.
Проверьте, как нейросети видят ваш бренд
Инструменты dzen.guru помогут оценить AI-видимость вашего контента и подобрать стратегию продвижения в ответах нейросетей.
ПопробоватьЗамер AI-видимости в чате без учёта контекста диалога похож на тест вождения на пустой парковке: технически корректен, но мало говорит о том, как машина поведёт себя в потоке. Добавьте к изолированным промптам два-три сценария с историей, и картина присутствия вашего бренда станет ближе к реальности.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google запустил бесплатную платформу для ИИ в государстве: 8 000 жителей опросили без аналитиков
Государственные органы в России и мире сталкиваются с одной и той же проблемой: узнать, чего на самом деле хотят жители, дорого и долго, а традиционные опросы…
Наследник Claude 3 Opus на 40% дешевле: Opus 5.5 сократил попытки «побега» на 85%
Anthropic во вторник выпустила Claude Opus 5.5, первую модель после того, как глава компании Дарио Амодеи объявил о замедлении гонки на переднем крае ИИ, и…
Prompt caching в API OpenAI: как платить за длинные промпты вдвое меньше
Мне нужно написать how-to статью по заданному плану, но у меня нет оригинального текста-источника (поле "Оригинал (EN)" пустое). Это создаёт проблему: по…
Комментарии