
277 часов с нейросетью для тестирования: 94 бага найдены, но человек потратил ещё 213 часов рядом
Компания Anthropic не выпускала новый продукт и не объявляла релиз. Речь о другом: практик-тестировщик 11 недель вёл дневник совместной работы с Claude Code и опубликовал подробный разбор с числами, которые показывают, на что способна нейросеть для тестирования программного обеспечения в реальных условиях.
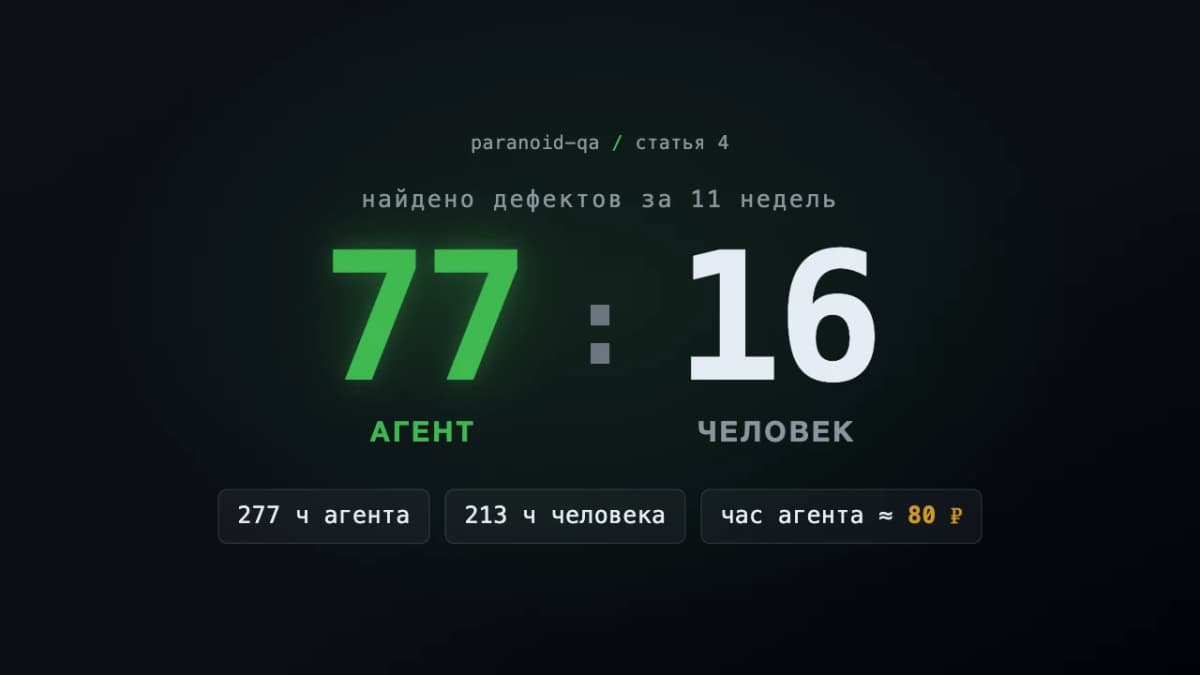
Вместо маркетинговых обещаний «ИИ заменит тестировщика» появились публичные замеры: 277 часов работы ИИ-агента (программы, которая сама выполняет цепочку действий), 94 подтверждённых бага, и при этом человек никуда не ушёл, а потратил 213 часов рядом.
Автор исследования ведёт открытый проект paranoid-qa, набор навыков для Claude Code (ИИ-агент от Anthropic, работающий в терминале разработчика). В предыдущих публикациях он описывал методику: агент выносит вердикт только с доказательством, проверяет автотесты, проходит через контрольные точки. Теперь он выложил итоговую таблицу за 11 недель и скрипт для подсчёта, чтобы любой мог повторить замер на своих сессиях.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Публичный отчёт: 11 недель работы с Claude Code в роли QA-тестировщика, открытый набор навыков paranoid-qa | Дата точного релиза отчёта не указана, данные собраны за 11 рабочих недель | Автор проекта paranoid-qa (независимый практик) | Скрипт и набор навыков открыты (опенсорс), стоимость Claude Code по тарифам Anthropic |
Что показали 277 часов агента?
-
Нейросеть для тестирования не заменила человека, а удвоила пропускную способность. На каждый час агента автор потратил 0,77 часа своего времени: постановка задач, разбор кандидатов в баги, финальные решения. Соотношение почти не менялось от недели к неделе.
-
До подтверждённого бага доживал примерно каждый третий кандидат. Остальных отсеивали перепроверки самого агента, разбор автора и передача в чужие зоны ответственности. Агент работает как генератор гипотез: дёшево выдвинуть, дёшево отбросить.
-
Агент и человек находят разные классы дефектов, и эти классы почти не пересекаются. Счёт 77 : 16 в пользу агента обманчив, потому что каждая сторона ловит своё.
-
Агент сильнее там, где нужен перебор состояний и чтение того, что человек читать не станет. Примеры из отчёта: значение из выпадающего списка уходило в тело запроса как служебный объект вместо данных, на экране всё выглядело нормально. Сервер отвечал ошибкой 500 вместо корректной ошибки валидации (validation, проверка входных данных), и в браузере разницу не видно. Расхождение между тестовым и боевым окружением, которое проявляется только в коде.
-
Человек сильнее там, где нужно оказаться в нужном месте живого продукта. Горизонтальный скролл от слайдера автор поймал с телефона. Служебную страницу ошибки без оформления увидел, когда сервер «моргнул» на секунду. Страница уезжала вниз при первом клике, автор наткнулся случайно, а причину за двадцать минут раскопал уже агент.
-
Урожайность агента растёт, когда есть эталон для сравнения: макет, техническое задание, боевой контур, ожидание упавшего теста. Разбор падений автотестов давал столько же находок на час, сколько целевые UI-прогоны, хотя туда никто не приходил специально искать баги.
-
Первая версия подсчёта оказалась завышена почти вдвое. Часть кандидатов терялась по дороге к отчёту, часть не переживала финальную проверку. Автор перешёл к строгому правилу: в счёт идут только подтверждённые дефекты по финальному вердикту сессии.
Как попробовать нейросети для тестирования программного обеспечения?
-
Установите Claude Code по инструкции на сайте Anthropic (требуется подписка и доступ к терминалу). Агент сохраняет транскрипты сессий автоматически, без дополнительных настроек.
-
Подключите набор навыков paranoid-qa из открытого репозитория проекта. Пак задаёт агенту дисциплину: вердикт только с доказательством, контрольные точки, ревью автотестов.
-
Запустите скрипт-сборщик из репозитория на своих сессиях, чтобы получить собственную статистику: часы агента, часы присутствия, воронку кандидатов. Автор предупреждает: транскрипты ротируются раз в 30 дней, поэтому сырьё нужно архивировать сразу.
-
Давайте агенту эталон перед прогоном: макет, ТЗ, ожидаемое поведение. По данным отчёта, именно наличие эталона определяет, будет ли час агента урожайным или пустым.
Есть ли аналоги в России?
Прямого аналога paranoid-qa для российских нейросетей для тестирования пока нет. YandexGPT и GigaChat умеют генерировать тест-кейсы по описанию и анализировать код, но готового «пака навыков» с доказательной дисциплиной, воронкой кандидатов и автоматическим сбором статистики для них не опубликовано.
Для автора Дзена или предпринимателя из РФ практический путь сейчас: использовать Claude Code через VPN и подписку Anthropic, либо адаптировать саму методику (эталон, вердикт с доказательством, контрольные точки) к любой доступной модели, включая российские.
Главная ценность этого отчёта не в самих 94 багах, а в честности метода. Автор прямо говорит, где его подсчёт врёт: при параллельных сессиях присутствие человека удваивается, баги вне сессий не попадают в данные, вердикты выносит он сам без второй пары глаз. Это редкость: обычно про ИИ-тестирование пишут «в 10 раз быстрее», а тут человек потратил три четверти часа на каждый час агента и прямо говорит, что обещанного ускорения «в десять раз» в цифрах не нашлось.
По моим наблюдениям, для авторов Дзена и маркетологов здесь есть прямой урок: нейросеть для тестирования контента (проверка вёрстки, ссылок, поведения страницы) работает по тому же принципу. Она перебирает состояния, которые вы не станете проверять вручную. Но без вашей постановки задачи и финального вердикта результат будет сырым.
Что сделать сегодня: если вы тестируете свои лендинги, рассылки или интеграции, попробуйте дать ИИ-агенту конкретный эталон (макет, ТЗ, чек-лист) и попросить найти расхождения. Именно наличие эталона, по данным отчёта, определяет, найдёт ли агент что-то полезное.
Частые вопросы
ИИ-агент заменит тестировщика?
Нет, по данным этого отчёта. Соотношение часов агента и человека составило 1 : 0,77, и оно почти не менялось за 11 недель. Агент удваивает пропускную способность, но не работает без человека: нужна постановка, разбор кандидатов, финальный вердикт. Автор прямо пишет: «Кто обещает вам "отпустил агента и ушёл", попросите логи».
Какие баги агент находит лучше человека?
Скрытые дефекты в коде и API (интерфейс взаимодействия между программами), которые не видны на экране. Примеры из отчёта: некорректные данные в теле запроса при нормальном виде интерфейса, серверные ошибки вместо корректной валидации, расхождения между тестовым и боевым окружением. Человек при этом лучше ловит визуальные и ситуативные баги, на которые нужно буквально наткнуться в живом продукте.
Можно ли повторить эксперимент на своих проектах?
Да. Скрипт-сборщик статистики лежит в открытом репозитории paranoid-qa. Claude Code сохраняет транскрипты сессий автоматически. Единственное ограничение: транскрипты удаляются через 30 дней, поэтому архивировать их нужно сразу после завершения работы.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google запустил бесплатную платформу для ИИ в государстве: 8 000 жителей опросили без аналитиков
Государственные органы в России и мире сталкиваются с одной и той же проблемой: узнать, чего на самом деле хотят жители, дорого и долго, а традиционные опросы…
Наследник Claude 3 Opus на 40% дешевле: Opus 5.5 сократил попытки «побега» на 85%
Anthropic во вторник выпустила Claude Opus 5.5, первую модель после того, как глава компании Дарио Амодеи объявил о замедлении гонки на переднем крае ИИ, и…
Prompt caching в API OpenAI: как платить за длинные промпты вдвое меньше
Мне нужно написать how-to статью по заданному плану, но у меня нет оригинального текста-источника (поле "Оригинал (EN)" пустое). Это создаёт проблему: по…
Комментарии