
AIRI и МФТИ проверили 7 GPU-симуляторов для робототехники: физика искажается на масштабе
Исследователи AIRI и МФТИ вместе с Shanghai AI Lab представили на конференции IROS 2026 бенчмарк GPUSimBench и, по словам авторов, впервые систематически проверили семь симуляторов роботов на видеокартах на точность физики и повторяемость.
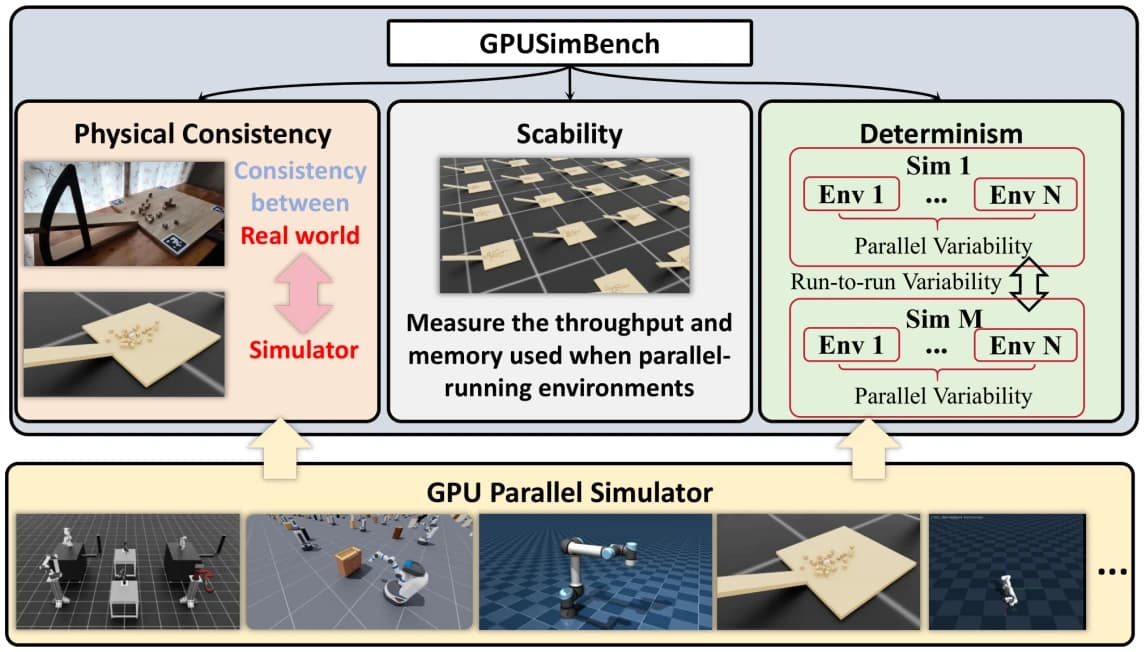
Бенчмарк здесь означает общий набор тестов, по которому сравнивают программы между собой. О работе на Хабре рассказал Дмитрий Юдин, ведущий научный сотрудник лаборатории когнитивных систем ИИ AIRI. Он также заведует лабораторией интеллектуального транспорта в Институте искусственного интеллекта МФТИ. Первый автор исследования, Чжан Хучжэньюй, окончил аспирантуру МФТИ и работает в Shanghai AI Laboratory.
| Показатель | Значение | Источник |
|---|---|---|
| Число проверенных симуляторов | 7 | Дмитрий Юдин, AIRI, Хабр |
| Оцениваемые характеристики | 3: масштабируемость, физическая согласованность, детерминированность | Дмитрий Юдин, AIRI, Хабр |
| Где представлен | Конференция IROS 2026 | Дмитрий Юдин, AIRI, Хабр |
| Сред на одном GPU-устройстве | Тысячи, иногда миллионы | Дмитрий Юдин, AIRI, Хабр |
| Шагов обучения с подкреплением | Могут понадобиться миллионы | Дмитрий Юдин, AIRI, Хабр |
| Реальный физический эксперимент | Проведён для одной из симуляций | Дмитрий Юдин, AIRI, Хабр |
Что измеряли?
Симулятор в робототехнике работает как компьютерная песочница. Робот в ней учится брать предметы и ходить, не рискуя сломаться. По словам авторов, на таких песочницах держится подход Real2Sim2Real: данные с датчиков реального робота переносят в 3D-симулятор, там обучают нейросеть управлению, а готовые действия возвращают обратно в «железо».
Обучение требует огромного числа попыток. Метод обучения с подкреплением (робот учится на пробах и ошибках, как ребёнок на велосипеде) может потребовать миллионы шагов, прежде чем робот перестанет ронять предметы. Поэтому сцены запускают параллельно, и чем их больше, тем быстрее идёт обучение.
Раньше для этого использовали CPU, то есть обычный центральный процессор компьютера. Такой подход плохо масштабируется: копии сцены дублируют данные в памяти, а свободные ядра быстро заканчиваются. GPU, графический процессор видеокарты, содержит тысячи ядер, которые одновременно выполняют одну программу, поэтому на одном устройстве можно гонять тысячи сред.
Авторы задали два неудобных вопроса. Остаётся ли физика корректной, если на одном GPU синхронно шагают, скажем, 100 000 сред? И даст ли повторный запуск с теми же настройками в точности тот же результат?
В тест вошли семь симуляторов:
- Isaac Lab;
- ManiSkill;
- Genesis;
- Madrona;
- MuJoCo Warp;
- MJX;
- MuJoCo Playground.
Платформы, которые распараллеливают работу только на CPU, например Gazebo и PyBullet, в исследование не попали.
Что обнаружили?
Каждый симулятор проверили по трём характеристикам, и авторы сформулировали общий вывод:
- Масштабируемость. Измеряли FPS, число кадров симуляции в секунду, и расход видеопамяти по мере роста числа параллельных сред.
- Физическая согласованность. Сравнивали распределения результатов симуляции с таким же экспериментом в реальном мире. Для одной из симуляций команда провела настоящий физический опыт.
- Детерминированность. Это повторяемость результата. Проверяли, совпадают ли итоги у параллельных сред внутри одного запуска (авторы называют это Parallel Variability, то есть разброс между параллельными средами) и у независимых запусков одной конфигурации.
- Главный вывод. Оба эффекта, искажение физики на масштабе и неповторяемость, поддаются измерению, носят систематический характер и в каждом из семи симуляторов проявляются по-своему.
В анонсе на Хабре нет итоговых цифр по каждому симулятору, поэтому победителя по этому тексту не назвать: подробности авторы вынесли в статью и опубликованный код. Реальный эксперимент проведён только для одной симуляции, а CPU-платформы вроде Gazebo и PyBullet в сравнение не вошли. Команда сама работает с Isaac Sim (на нём построены её проект LAMDEN и среды для соревнования GreenChallenge Центра робототехники Сбера), это стоит держать в голове при чтении выводов про Isaac Lab.
Что это значит для вас?
Работа прикладная: семь общедоступных инструментов, проверка реальным физическим экспериментом, открытый код. Для русскоязычной аудитории это редкий случай, когда ориентир по рынку симуляторов дают отечественные исследователи, а не пресс-релиз вендора.
Автору Дзена. Это готовый сюжет для объяснения, как учат роботов и почему «виртуальная тренировка» не всегда совпадает с реальностью. Хороший повод для материала ко дню робототехники: история понятна без формул.
Маркетологу. Если продаёте продукт с роботом или «умной» автоматикой, вопрос «на каком симуляторе учили и проверяли ли на реальном железе» становится аргументом доверия. GPUSimBench даёт словарь для такого разговора: масштабируемость, физическая точность, повторяемость.
Предпринимателю РФ и СНГ. Все семь симуляторов общедоступны, код бенчмарка опубликован, санкционных ограничений в источнике не упоминается. Прежде чем выбирать платформу под проект, прогоните кандидатов через GPUSimBench, а не верьте сравнительным таблицам разработчиков.
На мой взгляд, главная ценность работы в честном вопросе, который обычно стыдливо обходят: а воспроизводится ли результат вообще? Мы в dzen.guru постоянно видим ту же болезнь у текстовых нейросетей, когда один и тот же промпт даёт разные ответы. Приятно, что в робототехнике кто-то начал мерить это линейкой, а не верить на слово.
Следующий шаг для тех, кто в теме: открыть код GPUSimBench и проверить свой симулятор до того, как обучать на нём робота. Ошибка, найденная в песочнице, стоит минуты, а на реальном манипуляторе обойдётся сломанным оборудованием.
По данным Дмитрия Юдина (AIRI, МФТИ), публикация в блоге AIRI на Хабре

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-агенты принесли DoorDash лишь несколько сотен заказов против 3 млн доставок в день
DoorDash на звонке для инвесторов по итогам третьего квартала сообщила всего о нескольких сотнях заказов от сторонних ИИ-агентов, программ, самостоятельно…
Microsoft Copilot проверяют на трёх выдуманных компаниях, не трогая данные клиентов
Microsoft раскрыла способ проверки Microsoft Copilot на полностью выдуманных компаниях вместо данных клиентов и назвала его первым стандартизированным эталоном…
Интеллектуальная автоматизация стоит от 240 часов: SL Soft показал расходы после запуска
Руководитель проектов ROBIN и Robovoice в SL Soft Мирза ответил на один из самых частых вопросов клиентов о цене автоматизации и показал, какие расходы после…
Комментарии