
Запрос к нейросети проходит 8 этапов: видеокарта нужна только на последнем
Менеджер продукта Selectel Сергей Ковалёв разобрал путь запроса к нейросети от кнопки Enter до ответа, когда ИИ-сервисы стали ежедневным инструментом менеджеров, поддержки и продавцов. Этот разбор объясняет авторам Дзена, почему тормозят длинные чаты.
Российский провайдер показал, что дорогие видеокарты нужны только на последнем этапе: проверка, очередь и лимиты работают на обычных серверах. Такие серверы можно арендовать в России.
Принято думать, что ИИ-сервис, это одна большая модель на мощной видеокарте. В материале Selectel Ковалёв показывает другую картину. До модели запрос проходит несколько систем, и каждая отвечает за свой участок: доступ, очередь, лимиты, память диалога.
Что понадобится, чтобы проверить разбор на себе?
- Любой чат-бот, которым вы пользуетесь: ChatGPT, Claude или доступный в РФ аналог. Например, нейросеть Яндекса YandexGPT или GigaChat.
- Один длинный диалог, который вы ведёте давно, и один свежий.
- Около получаса на чтение и сравнение.
Какой путь проходит ваш запрос, шаг за шагом?
- Входной шлюз (API Gateway). API, это программный интерфейс, через который программы обмениваются запросами. Шлюз работает как охранник на проходной. Он читает служебные данные: кто вы, какой у вас токен авторизации (цифровой пропуск), откуда пришёл запрос.
- Проверка за доли секунды. Шлюз смотрит, действителен ли ключ, не превышен ли лимит, не заблокирован ли аккаунт и какую модель вы выбрали. Если что-то не так, шлюз отвечает сам, и до модели запрос не доходит.
- Выбор модели. У OpenAI и Anthropic несколько моделей. Шлюз определяет нужную: ту, что вы выбрали сами, или ту, что подберёт режим «Авто».
- Балансировщик нагрузки. Это диспетчер, который распределяет миллионы одновременных запросов так, чтобы ни один сервер не перегрузился. Он отправляет запрос на наименее загруженную группу серверов. Ориентируется он не на число соединений, а на активные генерации и длину очереди: один ответ занимает полсекунды, другой полминуты.
- Ограничитель частоты (Rate limiter). Он следит, чтобы один пользователь не забрал все ресурсы. Счётчик хранят в общем хранилище в оперативной памяти, типичный инструмент для этого Redis. У Anthropic три счётчика: запросы в минуту, входные токены в минуту и выходные токены в минуту.
- Код 429. Если лимит превышен, сервер отвечает кодом 429, то есть «слишком много запросов». Заодно он сообщает, через сколько секунд можно попробовать снова.
- Управление контекстом. Сама модель не помнит прошлых сообщений. Отдельная система хранит историю и с каждым новым сообщением отправляет модели весь диалог с самого начала.
- Инференс. Так называют этап, когда обученная модель отвечает пользователю. Текст делится на токены, это кусочки слов по несколько символов, и каждый токен получает номер. Дальше идут перемножения таблиц чисел (матриц), которые повторяются миллиарды раз.
Обратите внимание: на первых шести шагах видеокарта (GPU, графический процессор для вычислений) не участвует. По словам Ковалёва, шлюз, балансировщик и ограничитель работают на NGINX и Envoy, программах для приёма и распределения трафика, или на собственных разработках компаний. Envoy, например, используется в инфраструктуре OpenAI.
Для этих задач хватает обычных серверов на архитектуре x86 от Dell, HPE или Supermicro. В Selectel такие можно арендовать: в пример автор приводит сервер с 16 ядрами на процессоре AMD EPYC 9135 и памятью DDR5 ECC Reg (оперативная память с автоматическим исправлением ошибок). По словам Ковалёва, от гигантов такая инфраструктура отличается только количеством машин.
Масштаб хранения автор показывает на примере платформы Habitat, которую описала OpenAI. Больше 70 миллионов запросов в секунду, больше миллиарда пользователей в неделю, почти 40 регионов и более 500 петабайт данных (петабайт равен миллиону гигабайт). Одно действие пользователя превращается в сотни обращений к базе.
Вы две недели ведёте один чат, где обсуждаете и рубрику канала, и рекламу, и правки к статьям. Каждый новый ответ модель строит, заново обрабатывая всю эту переписку целиком. Поэтому ответ приходит медленнее и стоит сервису дороже. Новый чат под новую задачу снимает этот груз.
Считать, что модель «помнит» вас. Помнит система контекста, и только в пределах контекстного окна, то есть рабочей памяти модели, которую измеряют в токенах.
Бомбардировать сервис повторами после кода 429. Лимит считается по минутам, и сервер сам называет время ожидания.
Ждать от разбора описания российских сервисов. Схема показана на примерах OpenAI и Anthropic, а про устройство YandexGPT и GigaChat материал не рассказывает.
Что делать с этим прямо сейчас, по ролям?
Автору Дзена. Заводите отдельный чат под каждую статью или рубрику. Длинный промпт с инструкциями давайте в начале, а не повторяйте его в каждом сообщении: он и так уходит модели вместе со всей историей.
Маркетологу. Лимиты считают в токенах, потому что длинный запрос обходится сервису дороже короткого. Если команда работает через платный доступ, короткие и точные запросы прямо снижают расход.
Предпринимателю из РФ и СНГ. Если вы собираете свой ИИ-сервис, входной контур можно поднять на арендованных серверах российского провайдера без видеокарт. GPU понадобятся только там, где модель генерирует ответ.
На мой взгляд, главный практический вывод разбора не про железо, а про длину диалога. Я давно держу правило «одна задача, один чат», и после такого объяснения его проще продать авторам на курсах. Честная оговорка: это взгляд инженера провайдера, который заодно рекламирует свои серверы. Цифры по Habitat и лимитам Anthropic взяты из описаний самих компаний.
Работайте с нейросетями осознанно
Разборы, промпты и практика для авторов Дзена от команды dzen.guru
Перейти на dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
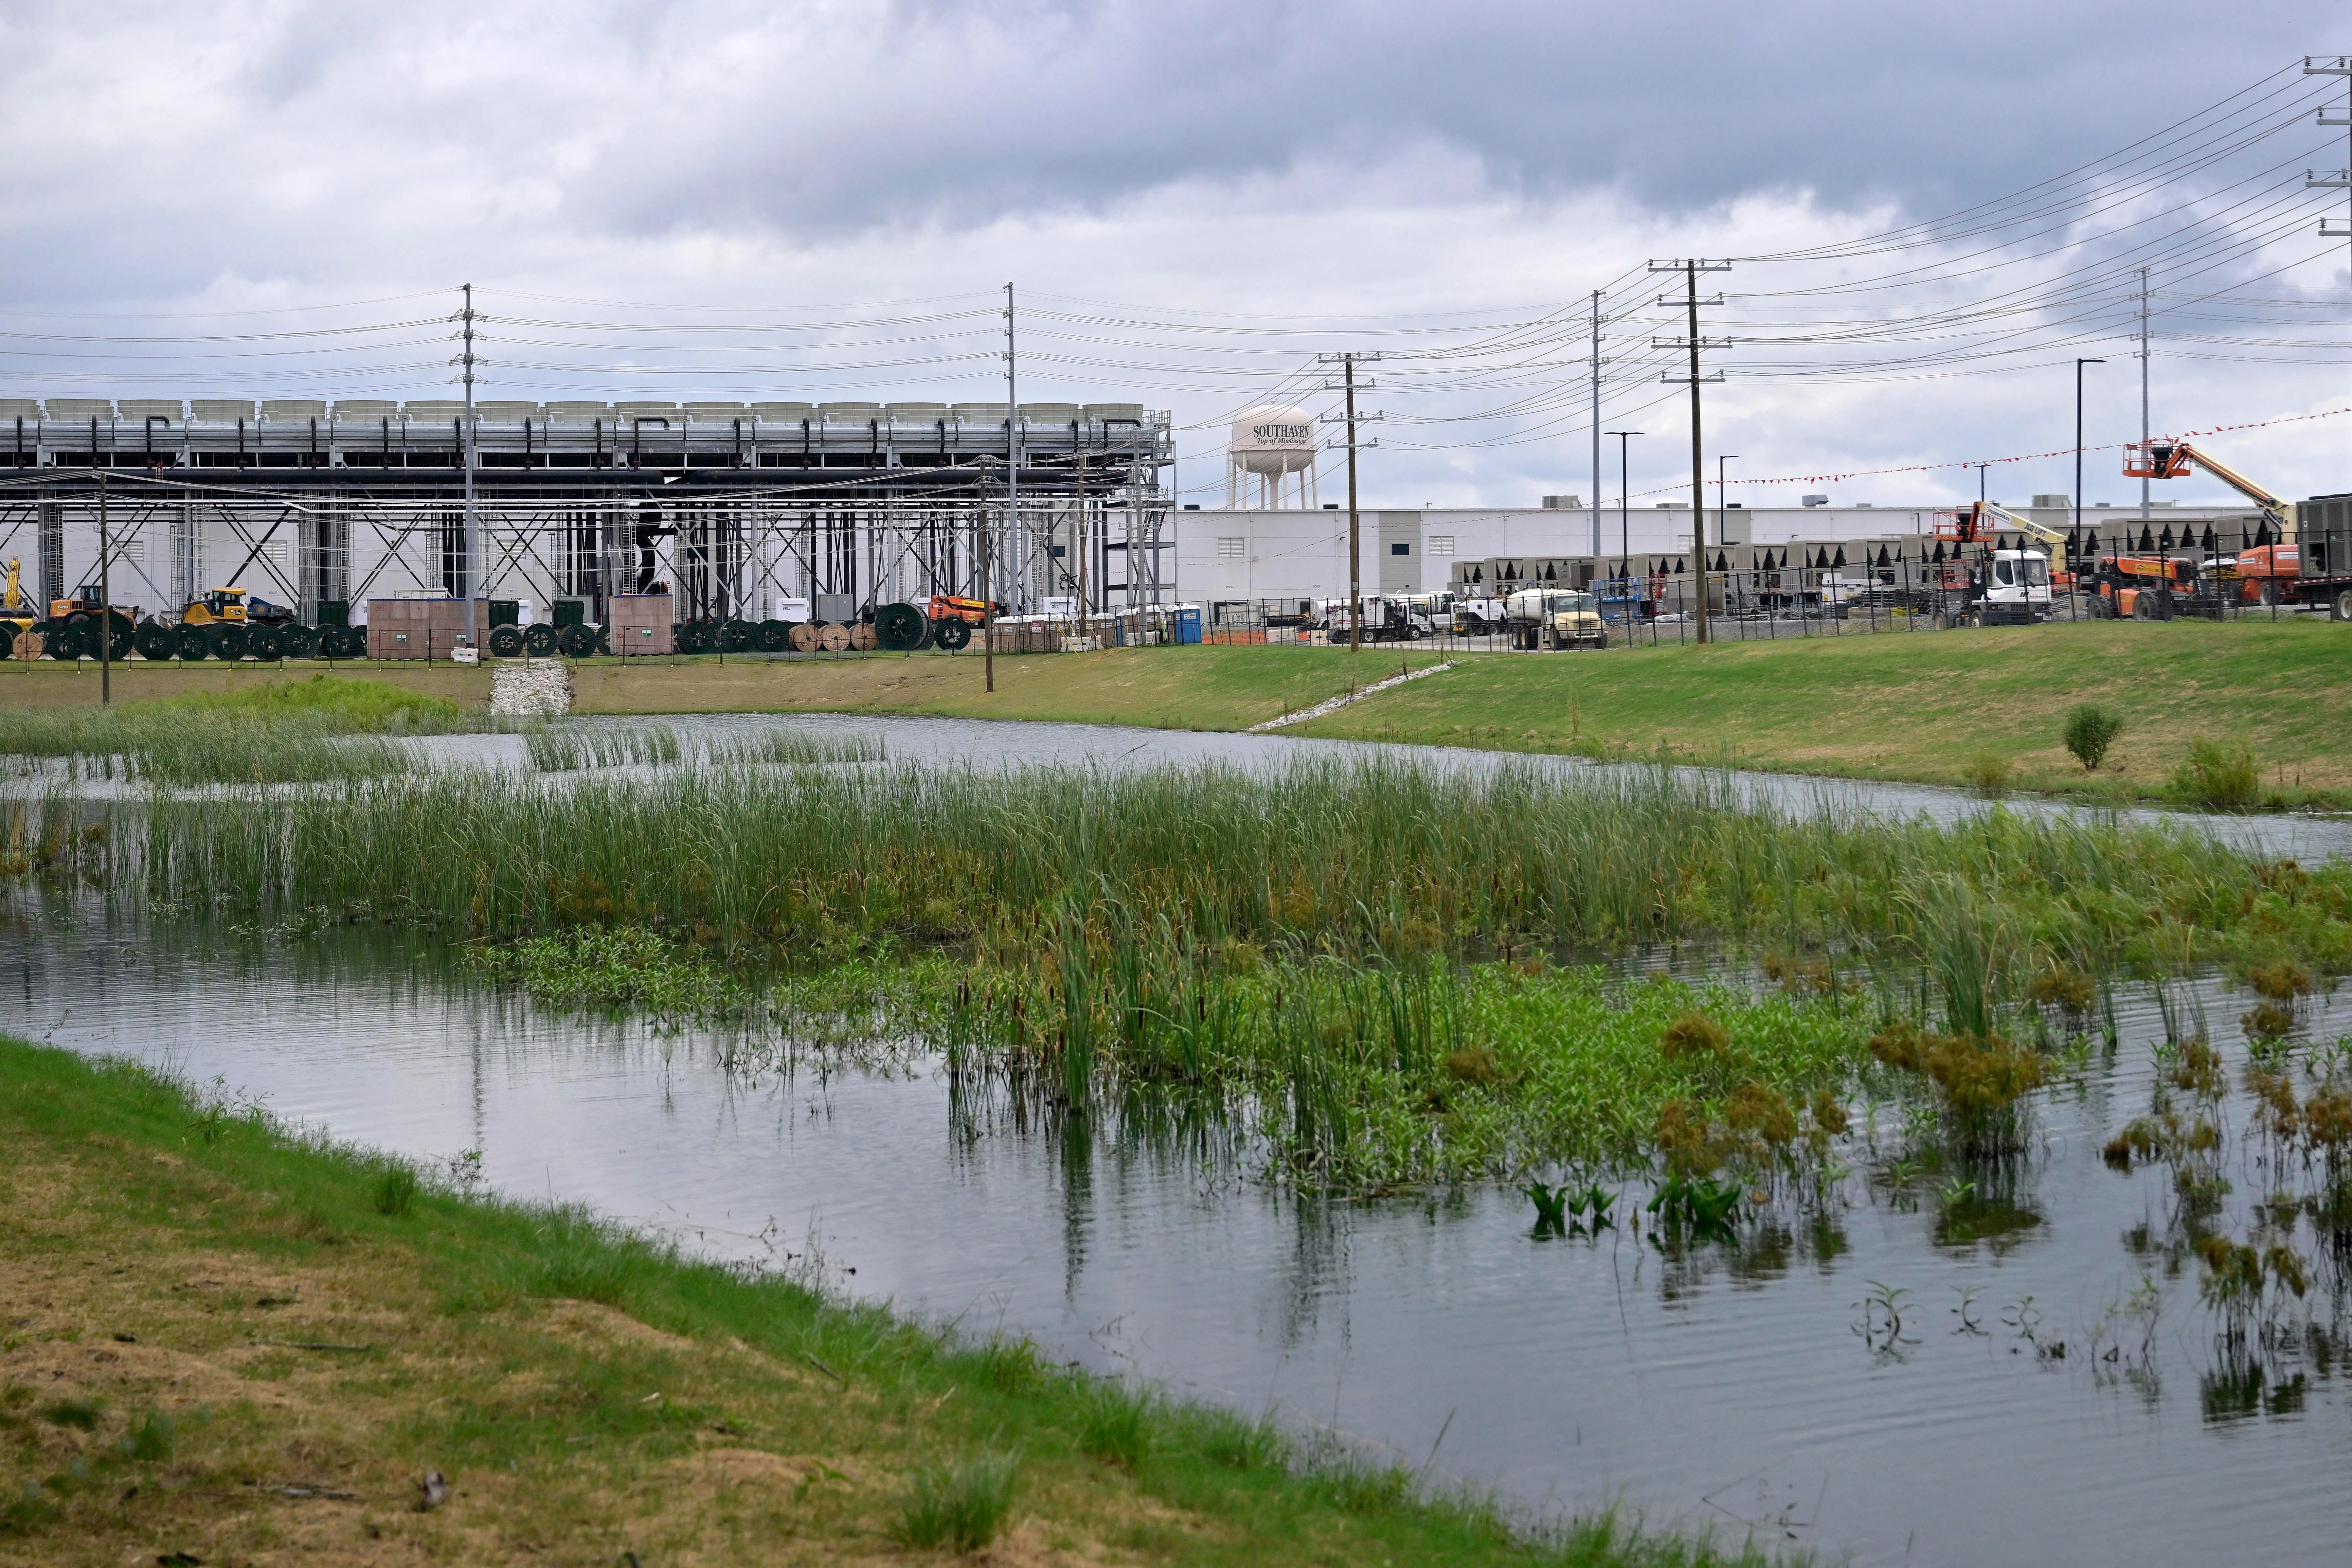
xAI скупает дома у соседей дата-центра: продавцы теряют право судиться за шум
Дочерняя компания xAI Илона Маска предлагает выкупить дома у жителей Саутхейвена в Миссисипи, если те не присоединятся к иску о шуме её дата-центра, на фоне…
Вайбкодинг или опенсорс: автор шлюза Keystone вывел критерий из четырёх вопросов
Автор открытого шлюза Keystone в ответ на частый вопрос эпохи почти бесплатного кода предложил четыре вопроса, которые отделяют задачи для вайбкодинга от задач…
Google Play раздаст $1 млн 10 африканским студиям инди игр, не забирая долю в бизнесе
Google Play назвал 10 студий из Африки южнее Сахары, которые разделят первый фонд компании для инди игр на этом континенте, $1 млн, причём деньги выдают без…
Комментарии