
Языковые модели путаются в 90 инструментах: как роутер на RTX 3090 поднял точность выбора
Языковые модели с набором из девяноста инструментов теряют точность выбора нужного на локальном железе, и эта инструкция показывает, как сузить список кандидатов и поднять качество на обычной RTX 3090.
Популярные ИИ-оркестраторы (программы, которые решают, какой инструмент вызвать для ответа на запрос) рассчитаны на мощные облачные модели уровня Claude или GPT-5. Локальная модель на 27 миллиардов параметров на бытовой видеокарте путается, когда видит все девяносто инструментов сразу. Практик из корпоративной среды измерил разницу и делится цифрами и конкретной схемой.
Откуда взялась задача и почему стандартный подход не работает?
Источник описывает ИИ-оркестратор с более чем девяноста инструментами: таблицы, документы, почта, задачи, веб-страницы, презентации. На каждом шаге языковая модель выбирает, какой инструмент вызвать. Стандартный подход, который используют такие системы, как Hermes, OpenClaw и Ouroboros, показать модели весь список. Ни одна из них не фильтрует инструменты по тексту запроса.
Проблема в том, что эти ИИ-агенты (программы, которые сами решают, что делать дальше, без прямой команды на каждый шаг) рассчитаны на фронтирные модели, способные держать сотню кандидатов без потерь. Для локальной Qwen 3.6 на 27 миллиардов параметров с единственной RTX 3090 24 Gb задача другая: заставить минимальную конфигурацию выполнять корпоративные задачи с приемлемым качеством и скоростью.
Что понадобится?
- Видеокарта: RTX 3090 24 Gb (минимальный рабочий вариант) или доступ к облачной модели (GigaChat-2-Max, gpt-oss 120B или аналог)
- Локальная модель: Qwen 3.6 27B или сопоставимая открытая модель (модель с публично доступными весами)
- Оркестратор с настраиваемым роутингом: система должна позволять переключать режим отбора инструментов для каждой модели отдельно
- Корпус тестовых запросов: от 49 реальных пользовательских задач для замера
- Время: один прогон корпуса занимает от получаса, нужно минимум два прогона (узкий набор и полный) для сравнения
Пошаговая инструкция
-
Разбейте инструменты на разделы и подразделы. Сгруппируйте все инструменты по смыслу: «датасеты», «почта», «презентации» и так далее. Внутри каждого раздела выделите подразделы. Цель: при любом запросе модель должна видеть не все девяносто описаний, а около двадцати.
-
Постройте роутер перед основным вызовом модели. Роутер (предварительный классификатор) по тексту запроса определяет раздел и подраздел, затем передаёт модели только инструменты из этого подраздела. О существовании остальных инструментов модель на этом шаге не знает.
-
Соберите корпус реальных запросов. Минимум 49 задач, которые покрывают разные разделы. Каждый запрос должен иметь эталонный правильный инструмент. Решите заранее: считается ли уточняющий вопрос модели («какой ключ проекта?») допустимым ответом или провалом. Это влияет на итоговый счёт.
-
Прогоните корпус дважды в одинаковых условиях. Первый прогон: модель видит только узкий набор (около двадцати инструментов). Второй прогон: модель видит полный список (все девяносто с лишним). Замеряйте три метрики: точность выбора, размер контекста (в токенах, единицах текста, которыми модель измеряет входные данные), время прогона.
-
Разберите каждый провал вручную. Не смотрите на общий процент, ищите паттерн. По данным автора источника, все четыре ошибки локальной модели на полном наборе пришлись на инструменты с похожими названиями: «объедини датасеты» уходило в «управление датасетами», «построй график» и «переименуй колонки» попадали в «анализ датасета».
-
Настройте режим роутинга отдельно для каждой модели. Привяжите профиль роутинга к модели, а не к системе. Переключение модели в админке должно автоматически переключать и режим отбора инструментов.
-
Проверьте, совпадает ли путь замера с путём продукта. Убедитесь, что тестовый корпус проходит ту же цепочку, что и реальный пользовательский запрос. Иначе вы точно и воспроизводимо меряете не то.
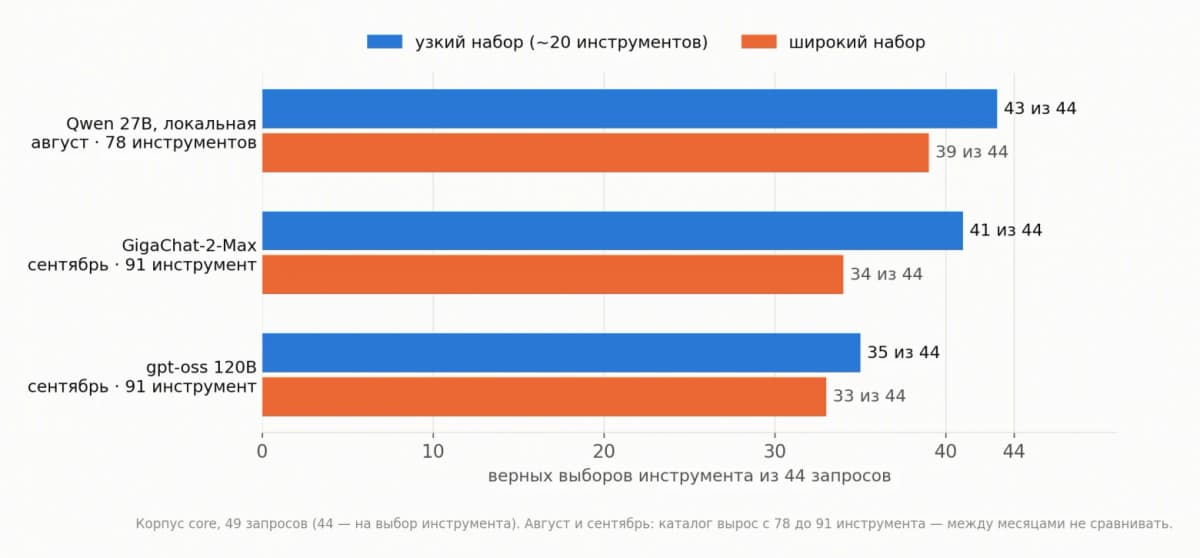
Локальная Qwen 27B, RTX 3090, август, 49 запросов. Узкий набор: 43 верных выбора из 44. Полный набор: 39 верных. Контекст на полном наборе в 2,7 раза больше, прогон дольше на треть.
Две облачные модели (GigaChat-2-Max и gpt-oss 120B), сентябрь, тот же корпус, 91 инструмент, четыре режима отбора. На обеих моделях узкий набор выиграл по всем трём метрикам: точность, размер контекста, задержка.
Показательный разбор провалов GigaChat на узком наборе. Все три провала оказались уточняющими вопросами: «какой ключ проекта?», «в каком слоте датасет?». Если считать разумное уточнение допустимым ответом, счёт становится 44 из 44.
Роутер не нашёл раздел, и модель осталась без инструментов. Это хуже любого неверного выбора. Система решает, что вопрос «на знания», и модель выдумывает ответ. Реальный пример из источника: на запрос «определи, какие устройства есть в сети» модель уверенно написала «выполняю сканирование сети» и расписала план текстом, не вызвав ни одного инструмента. Два хода подряд, ноль вызовов, уверенный тон. Предусмотрите запасной сценарий, когда роутер не может классифицировать запрос.
Похожие названия инструментов. Локальная модель путает не случайных кандидатов, а соседей. Узкий набор помогает не тем, что он короче, а тем, что в нём меньше похожих друг на друга описаний. Если в одном подразделе оказались «объедини датасеты» и «управление датасетами», модель будет ошибаться даже на узком наборе.
Оценка «на глаз» без фиксированного корпуса. Восемь запросов не доказательство. Автор источника получил красивую гипотезу «сильной модели нужен широкий набор» на восьми запросах, а полный прогон на 49 запросах её не подтвердил.
Замер идёт не тем путём, что продукт. Если тестовая цепочка отличается от пользовательской, результаты бесполезны.
Что с этого прямо сейчас, по ролям?
Автору Дзена и копирайтеру. Если вы используете языковые модели с инструментами для генерации контента (поиск источников, создание таблиц, работа с документами), сужение набора инструментов может убрать «галлюцинации» (ситуации, когда модель уверенно выдумывает то, чего нет) при выборе действия. Попробуйте группировать свои промпты (текстовые инструкции для модели) по типу задачи и давать модели только релевантный набор.
Маркетологу. Языковые модели с инструментами для автоматизации рассылок, аналитики, работы с CRM экономят время, но на слабом железе ошибки выбора инструмента съедают выигрыш. Узкий набор, по данным автора, сокращает контекст в 2,7 раза и ускоряет прогон на треть. Для внутренних задач на локальном сервере это разница между «работает» и «зависает».
Предпринимателю в РФ. Закрытый контур (данные не уходят в облако) на RTX 3090 с Qwen 27B реален. Из российских облачных аналогов автор тестировал GigaChat-2-Max от Сбера, и на узком наборе модель отработала без ошибок (если считать уточняющие вопросы допустимым поведением). Для тех, кому критична локальность данных, это рабочая конфигурация.
Этот кейс ценен не выводом «узкий набор лучше», а методом измерения. Автор честно показал, как восемь запросов дали красивую, но ложную гипотезу, а 49 запросов её опровергли. Для тех, кто оптимизирует языковые модели с инструментами на доступном железе, главный урок: не доверяйте интуиции, прогоняйте полный корпус. И обязательно разбирайте провалы поштучно. Половина «ошибок» GigaChat оказались разумными уточняющими вопросами, и это не свойство модели, а вопрос о том, что считать правильным ответом.
Честная оговорка: все замеры проведены на одном оркестраторе с конкретным набором инструментов. На вашей конфигурации результаты могут отличаться. Автор прямо об этом предупреждает.
Попробуйте нейросети для контента на dzen.guru
Подбираем инструменты, которые реально работают для авторов в РФ. Без облаков, без переплат, с измеримым результатом.
Посмотреть инструментыГлавное, что остаётся после этого разбора: режим роутинга привязывайте к модели, а не к платформе, и прогоняйте полный корпус, прежде чем менять архитектуру. Для всех трёх моделей, измеренных автором на полном корпусе, узкий набор победил. Но правило «сильной модели нужен широкий набор» пока не опровергнуто, оно просто ждёт честного замера на фронтирной модели с полным прогоном.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Как работает нейросеть: три операции на бумаге вместо Python и GPU
Здесь задача необычная: объяснить, как нейросеть генерирует текст, без единого компьютера, на чистой математике, которую можно проделать карандашом на бумаге.…
Что такое MCP-сервер на практике: код за вечер, а грабли на недели
Почему это важно MCP-сервер позволяет вашему продукту разговаривать с ChatGPT, Claude и другими ИИ-агентами напрямую, но написать код оказалось проще, чем…
Нейросеть для генерации контента сломала 312 ссылок за секунду: чек-лист скрытых ошибок
Сайты, собранные нейросетью, выглядят готовыми, но поисковый трафик часто не приходит, и причина не в контенте, а в скрытых технических поломках, которые ИИ…
Комментарии