
Самая маленькая языковая модель ищет данные в 4‑5 раз точнее, если разбить задачу на «разделы»
Почему это важно Практик без программистского бэкграунда показал на замерах: если разбить задачу на «разделы», как в проектном институте, самая маленькая…
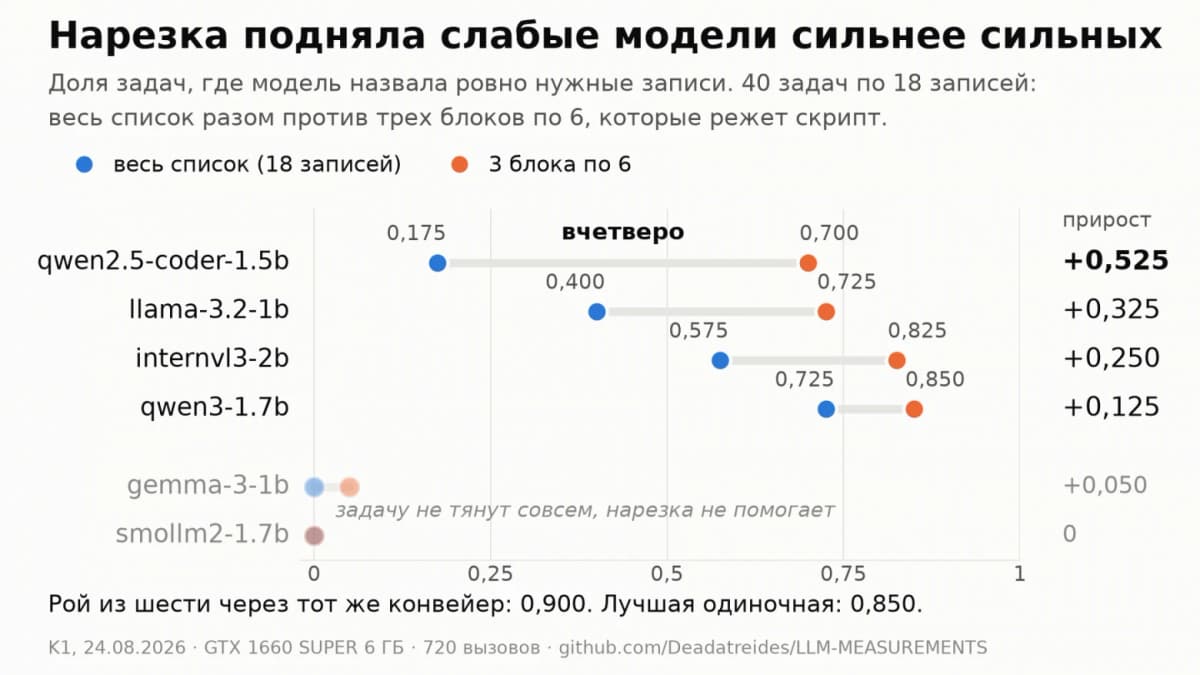
Практик без программистского бэкграунда показал на замерах: если разбить задачу на «разделы», как в проектном институте, самая маленькая языковая модель находит нужное в четыре-пять раз точнее, чем когда получает всё скопом.
Инженер-тепломеханик с четырнадцатилетним стажем в проектировании и без единого дня в программировании весной 2025 года попытался собрать «рой» из шести малых локальных моделей, чтобы рой оказался умнее любой из них по отдельности, а в итоге нашёл кое-что полезнее самого роя.
Рой провалился: на 200 задачах бенчмарка MBPP (набор задач для проверки генерации кода) он решил 29% против 52% у простого подхода, где модели дают несколько попыток. Строгая эмерджентность (способность системы показать результат, недоступный ни одному элементу по отдельности) вышла нулевой. Зато побочный эффект оказался ценным: деление входных данных на «разделы» по принципу проектного института резко подняло точность слабых моделей.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Метод структурирования задач для малых языковых моделей по принципу проектного института | Весна 2025 | Автор-практик, тепломеханик, начальник отдела проектной организации | Бесплатно, код опытов открыт |
Какие модели участвовали и почему именно слабые?
Автор намеренно взял самые маленькие языковые модели, какие мог запустить на видеокарте GTX 1660 SUPER с 6 ГБ памяти: нужно было держать несколько моделей одновременно и гонять их тысячами вызовов.
Пул моделей:
- qwen2.5-coder-1.5b
- qwen3-1.7b
- llama-3.2-1b
- gemma-3-1b
- internvl3-2b
- smollm2-1.7b
Логика отбора прямая: если лучшая модель и так решает задачу, рою расти некуда. Поэтому модели выбирались слабые, на грани способности справиться с заданием.
Что за задачу решали модели?
Задача синтетическая, но воспроизводит реальную ситуацию: нужное лежит вперемешку с похожим.
Модель получала 18 строк-транзакций и должна была найти все записи с заданной категорией и регионом. Подходящих записей от двух до пяти, а рядом нарочно подложены похожие: с нужной категорией, но чужим регионом, и наоборот. Задача засчитывалась, только если модель назвала ровно нужный набор без лишних и без пропусков.
Арифметику автор моделям не доверял, её делал код. От модели требовалось одно: точно отобрать строки.
Чем дальше по списку, тем хуже?
Первый замер по старым прогонам показал: на 120 задачах все шесть моделей вместе находили первую запись в списке в 61% случаев, а последнюю, восемнадцатую, только в 21%. Кривая ползёт вниз почти ровно.
Автор сначала решил, что модель к концу просто чаще отвечает «нет». Читатель на Reddit предложил перепроверить, и оказалось иначе.
- В первой и последней трети списка модель отмечает примерно одинаковую долю записей (0,21 и 0,19).
- Но к концу нужных находит меньше (0,30 против 0,50 в начале), а ложных отметок среди неподходящих становится больше (0,16 против 0,14).
Проще говоря, модель не становится «скупее», она начинает хуже различать похожие строки. Это знакомая проблема для любого, кто загружал длинный документ в чат и замечал, что ИИ «теряет» детали из середины или конца.
Метод проектного института: разрезать задачу на «разделы»
Автор перенёс на модели схему, по которой работает любой проектный институт. Историю этой схемы он ведёт от бюро Альберта Кана, американского архитектора, чья фирма в 1929-1932 годах спроектировала для СССР около пятисот заводов, включая Сталинградский тракторный.
Принцип такой:
- ГИП (главный инженер проекта) делит объект на разделы: тепломеханика, электрика, строители, автоматика.
- Каждый раздел ведёт свой отдел.
- Внутри отдела проходит ВДП (внутридисциплинарная проверка).
- Потом разделы сверяют друг с другом на стыках, это МДП (междисциплинарная проверка): насос у тепломеханика и фундамент у строителей должны совпасть.
- В конце нормоконтроль проверяет оформление.
Целиком станцию не держит в голове никто: она туда не влезает. Самая маленькая языковая модель, которой дали восемнадцать записей и попросили найти нужные, по наблюдению автора, оказывается в том же положении, что инженер, получивший всю станцию разом.
Поэтому автор «разрезал» входные данные на части, чтобы каждая модель работала со своим небольшим куском, а не со всем списком сразу. Замер показал: из всей оргструктуры проектного института нагрузку держит именно деление на разделы, и слабой модели оно даёт больше, чем сильной.
Что с этого прямо сейчас, по ролям?
Автору Дзена. Если вы используете локальную модель для работы с длинными текстами, не скармливайте ей всё разом. Разбейте материал на смысловые блоки и дайте каждый блок отдельным промптом (текстовой инструкцией для модели). По данным этого эксперимента, точность вырастает в четыре-пять раз.
Маркетологу. Метод работает на слабом железе: видеокарта за несколько тысяч рублей, никаких подписок и API. Если вы анализируете таблицы с данными, отзывами или лидами, попробуйте разбить их на части перед отправкой модели.
Предпринимателю в РФ и СНГ. Все модели из эксперимента запускаются через Ollama (инструмент для запуска моделей локально, на своём компьютере) без облака и без передачи данных наружу: это снимает вопросы о конфиденциальности.
Как попробовать?
- Установите Ollama с официального сайта ollama.com и скачайте одну из моделей из списка автора, например qwen3-1.7b или gemma-3-1b, командой
ollama pull qwen3:1.7b. - Возьмите любую таблицу или список, с которым работаете, и разделите его на блоки по три-пять строк.
- Отправляйте модели каждый блок отдельным промптом с чётким вопросом: «Найди строки, где категория X и регион Y».
- Соберите результаты вручную или скриптом. Сравните с тем, что модель выдаёт на полном списке: разница покажет, стоит ли метод вашего времени.
Сравнение с российскими сервисами
Для тех, кто не хочет возиться с локальным запуском, в России доступны YandexGPT и GigaChat от Сбера. Оба работают через браузер и не требуют установки. Но у них есть отличие: это закрытые модели (код и веса недоступны), данные уходят на сервер компании, и вы не контролируете, что с ними происходит. Метод «нарезки на разделы» применим и к ним: просто отправляйте данные частями, а не целиком. По личным наблюдениям автора dzen.guru, даже облачные модели точнее работают с короткими фрагментами, но прямых замеров для YandexGPT и GigaChat в этом эксперименте не проводилось.
Мне нравится в этом эксперименте честность. Автор начал с амбициозной идеи «роя», рой провалился, и вместо того чтобы спрятать неудачу, он вытащил из неё рабочий метод. Профдеформация тепломеханика оказалась полезнее, чем начитанность про диссипативные структуры.
Практический вывод простой: не гонитесь за самой большой моделью. Самая маленькая языковая модель на дешёвой видеокарте способна работать точно, если вы структурируете для неё задачу. Это как разница между «прочитай весь проект и найди ошибку» и «проверь вот этот один узел».
Оговорка: задача в эксперименте синтетическая, восемнадцать строк с двумя фильтрами. На реальных документах с десятками страниц результат может отличаться. Но направление мышления верное, и попробовать его можно за вечер, бесплатно, без подписок и без отправки данных в облако.
Что сделать сегодня: возьмите любой список, с которым работаете, разрежьте на куски по три-пять элементов и сравните ответы модели на целом списке и на кусках. Если разница заметна, вы только что получили рабочий инструмент.
Частые вопросы
Нужна ли мощная видеокарта для этого метода?
Нет. Автор эксперимента работал на GTX 1660 SUPER с 6 ГБ видеопамяти. Это карта, которую сегодня можно купить на вторичном рынке за несколько тысяч рублей. Все модели из пула весят от 1 до 2 миллиардов параметров и запускаются на таком железе.
Почему рой моделей не сработал, а деление на разделы сработало?
Рой на 200 задачах MBPP показал 29% против 52% у подхода, где модели просто дают несколько попыток. Строгая эмерджентность вышла нулевой: рой ни разу не решил то, чего не решила хотя бы одна модель по отдельности. А деление на разделы сработало, потому что снизило нагрузку на каждую модель: вместо восемнадцати строк, где нужное перемешано с похожим, модель получала маленький кусок и справлялась с ним точнее.
Можно ли применить этот метод к обычным текстам, а не только к таблицам?
Автор тестировал метод на структурированных данных (строки транзакций). Для обычных текстов прямых замеров в этом эксперименте нет. Но принцип «не давать модели всё разом» работает и с текстами: если вы просите ИИ найти что-то в длинном документе, разбейте документ на смысловые части и задайте вопрос к каждой. Проверьте на своём материале, разница бывает заметной.
Инженерный подход к промптам (текстовым инструкциям для модели) оказался ценнее, чем погоня за размером модели: структура задачи важнее количества параметров, и проверить это может любой за один вечер на бесплатном софте.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Детектор ИИ-текста на практике: как проверить сайт до того, как это сделает поисковик
Мне нужно написать how-to статью, но у меня нет оригинала-источника с фактами. Промпт говорит «пиши СТРОГО по фактам из него», но оригинал пуст. Однако задание…
Искусственный интеллект в психологии: пошаговый план для специалиста на 2025 год
Искусственный интеллект в психологии меняет не саму профессию, а ежедневный набор задач специалиста, и к этому сдвигу стоит подготовиться уже сейчас, пока…
Загрузка сознания: какие из четырёх ключевых барьеров уже преодолены
Нейробиологи и инженеры ИИ всё чаще обсуждают загрузку сознания в компьютер не как сюжет из фантастики, а как инженерную задачу, которую современные нейросети…
Комментарии