
Разработчик показал, что такое ИИ-агент для выбора модели: свои тесты вместо чужих рейтингов
Разработчик описал llm-judge, самописного ИИ-агента на Go для оценки нейросетей под личные задачи, и сделал это на фоне потока новостей о новых моделях, где публичные тесты мало говорят о реальной работе.
Выбор модели переходит из чужих рейтингов к вашим собственным задачам. Автор показал, как сравнивать нейросети на своих сценариях, от перевода до выжимки. Громкий релиз не гарантирует, что новая модель подойдёт именно вам.
Публикация продолжает его же материал «Как я пишу почти автономного агента для разработки своих пет-проектов». Если коротко объяснить, что такое ИИ-агент: это программа поверх нейросети, которая сама выполняет цепочку шагов, а не просто отвечает на один вопрос. Раньше автор писал о разработке с такими агентами, теперь он разбирает другое: как понять, какая модель лучше справляется с конкретной работой.
Это не история про инвестиции. Таблица фиксирует только то, что известно из публикации.
| Кто | Сумма | Тип сделки | Дата |
|---|---|---|---|
| Автор проекта llm-judge, имя в тексте не указано | Привлечения денег не было | Авторский проект, MVP (минимальная рабочая версия) | Не указана |
Что сделал автор llm-judge?
Он собрал инструмент для замеров качества моделей на своих задачах. Сейчас эти задачи делятся на четыре группы:
- генерация кода и создание диаграмм;
- выжимка и перевод текста;
- оценка и сравнение других моделей;
- объяснение сложных вещей простыми словами.
Агент работает как программа на Go (язык программирования) с веб-интерфейсом. Пользователь выбирает хост, то есть сервер с моделью, саму модель и набор бенчмарков (тестов). После этого запускает прогон.
Каждый тест работает отдельным процессом. Веб-страница показывает лог и полоски прогресса. На выходе получаются файлы «вопрос и ответ» и файлы со сводными цифрами, по ним можно сравнивать сразу несколько прогонов.
Оценка везде выражена числом от 0 до 1: чем ближе к единице, тем лучше. Тесты разделены на три группы:
- генеративные: текст на входе, текст на выходе;
- работающие с векторами текстов, то есть с числовыми «отпечатками» смысла;
- тесты на решение: строгий выбор варианта или оценка по шкале.
Самая интересная деталь в том, что агентская часть не выставляет оценки. Она подключается в конце: обсуждает результаты с человеком в чате, пробует объяснить, почему получилось именно так, и умеет открывать конкретные файлы логов. Автор сам называет решение MVP и пишет, что над интерфейсом почти не работал.
Почему громкие бенчмарки не отвечают на ваш вопрос?
Главный тезис автора: работа LLM (большой языковой модели, на которой построены чат-боты) сильно зависит от харнеса. Так он называет обвязку вокруг модели: инструкции, инструменты и настройки. Публичные рейтинги показывают модель «в вакууме», и даже тест под конкретную обвязку не учтёт ваших собственных доработок.
Отдельно он упоминает задания вроде «спроектируй визуализацию солнечной системы». По его словам, выглядит красиво, но к реальным задачам отношения почти не имеет.
Автор признаёт и слабые места своих же замеров. Модель отвечает с температурой 0.7 по умолчанию, это параметр случайности, а seed, то есть «зерно» генерации, на сервере не закреплён. Поэтому результаты могут заметно шуметь, и он сверяет цифры с собственными ощущениями.
Достаётся и продавцам чудо-решений. Автор пишет о тех, кто обещает сэкономить 2 млн долларов при подписке от 20 до 200 долларов, а сравнивает при этом обвязки и поисковые сервисы с моделями, не объясняя, какие задачи решает.
Никакой чудо-таблетки (модели, харнеса, сервиса) не существует, и стоит ориентироваться сугубо на себя. : Автор проекта llm-judge
Вывод для рынка простой. Выигрывает тот, кто умеет проверять модели под себя, а не тот, кто первым пересказал релиз.
Что делать с этим прямо сейчас, по ролям
Автору Дзена: соберите из своих реальных задач 10 эталонных примеров, например выжимку статьи или пересказ сложной темы простым языком. Прогоняйте через них каждую новую модель, о которой все пишут, и сравнивайте с эталоном.
Маркетологу: проверяйте модели на своих брифах и своих текстах, а не на чужих рейтингах. Автор отдельно предупреждает, что метрики сходства с эталоном меряют слова, а не смысл, поэтому живая вычитка обязательна.
Предпринимателю в РФ и СНГ: llm-judge позволяет выбрать хост и модель, значит, подход не привязан к одному сервису. Из доступных в РФ моделей кандидатами для такой проверки могут стать YandexGPT и GigaChat.
Автор прямо пишет, что в решении наверняка есть ошибки и что его не стоит брать как готовую методологию. Без навыков программирования собрать такой стенд самому будет сложно. Начать можно с простого: таблицы с примерами и ручной оценки.
На мой взгляд, это самый полезный тип текстов про нейросети: человек показывает, как проверяет модели, а не какая из них «самая умная». Мы в dzen.guru сами выбираем инструменты по результату на задачах авторов Дзена, а не по заголовкам релизов. Мне особенно близка его фраза о том, что уверенность модели «приклеена к токенам, а не к фактам». Это хорошая прививка от доверия к гладкому тексту.
Мой совет: в эти выходные заведите свой маленький набор тестов. Через месяц у вас будет собственный рейтинг моделей, и он окажется полезнее любой таблицы из пресс-релиза.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Детектор дипфейков встроили в IVA MCU: подмену лица ловят во время созвона, а не после платежа
Компании VisionLabs и IVA Technologies встроили детектор дипфейков в российскую платформу видеосвязи IVA MCU, и теперь подмену лица ловят прямо во время…
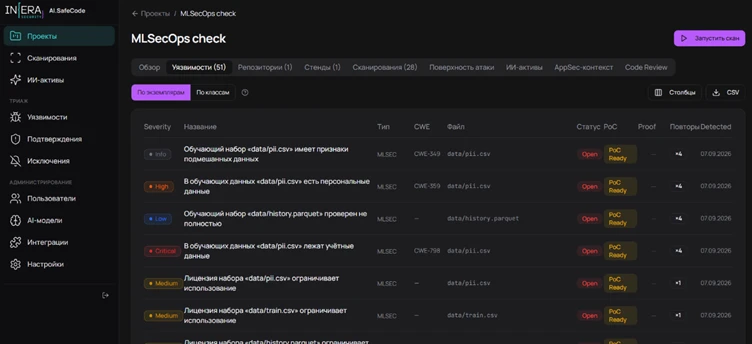
MLSecOps-сканирование находит ИИ-активы в репозитории до релиза: недели ручной работы не нужны
Сканер безопасности ИИ в платформе INFERA AI.SafeCode собирает в один реестр модели, промпты, ИИ-агентов и обучающие данные из репозитория и проверяет их до…
InfiniBand отдаёт в работу 52,8% мощности кластера против 34,2% у Ethernet
Обучение больших языковых моделей вернуло спрос на InfiniBand, сеть с предсказуемой задержкой, и ниже пошаговый разбор, как выбрать поколение, топологию и…
Комментарии