
InfiniBand отдаёт в работу 52,8% мощности кластера против 34,2% у Ethernet
Обучение больших языковых моделей вернуло спрос на InfiniBand, сеть с предсказуемой задержкой, и ниже пошаговый разбор, как выбрать поколение, топологию и управление для кластера видеокарт без потерь производительности.
Задача: понять, когда обычного Ethernet уже мало, и не ошибиться на этапе планирования. Результат: короткий порядок действий, который можно положить перед интегратором или облачным провайдером.
На масштабе в 16 384 графических ускорителя от сети зависит, какая доля вычислительной мощности уходит в работу. По данным автора разбора, на InfiniBand это 52,8%, а на Ethernet под нагрузкой всего 34,2%.
Андрей Бирюков, независимый эксперт по ИТ и информационной безопасности, подробно разобрал InfiniBand на Хабре. Десять лет назад многие предрекали технологии забвение, но обучение больших моделей снова сделало её востребованной. Главная мысль автора: InfiniBand не «ускоренный Ethernet», а отдельный набор протоколов, спроектированный с нуля под высокопроизводительные вычисления.
Разница начинается с устройства сети. Данные не отправляются, пока у получателя нет гарантированно свободного места в буфере, поэтому пакеты на линии не теряются. В Ethernet потеря пакета при перегрузке, наоборот, штатный сигнал сбавить скорость.
Второй элемент, RDMA (удалённый прямой доступ к памяти): данные кладутся сразу в память соседнего сервера, минуя операционную систему. Это похоже на курьера, который несёт посылку прямо на нужную полку, а не оставляет её в отделении почты. Процессор не тратит время на пересылку, и задержка сети приближается к задержке обращения к собственной памяти.
Отсюда цифры из разбора. Для коротких сообщений InfiniBand даёт задержку около 0,5 или 0,6 микросекунды, а базовый Ethernet от 1,2 микросекунды и выше. Под нагрузкой Ethernet проседает сильнее, а InfiniBand сохраняет предсказуемость.
Что понадобится
- Понимание, какую модель вы обучаете: плотную или MoE (модель из «экспертов», где каждый запрос обрабатывает только часть сети).
- Число и тип графических ускорителей (GPU, видеокарт, на которых обучают нейросети).
- Бюджет на оптику с запасом под следующее поколение.
- Специалист, который умеет настраивать Subnet Manager.
- Время на проверку кабелей и топологии при развёртывании.
Пошаговая инструкция
-
Определите тип нагрузки. Плотные модели синхронизируются через AllReduce, операцию, при которой все видеокарты складывают свои результаты и получают общий итог. Модели MoE гоняют трафик «все со всеми». Здесь, по данным автора, адаптивная маршрутизация InfiniBand даёт 89,4% эффективности бисекции (пропускной способности между двумя половинами кластера), а RoCEv2, то есть RDMA поверх обычного Ethernet, теряет 38,6% полезной пропускной способности из-за перекоса нагрузки на отдельные пути.
-
Выберите поколение скорости. Каждое поколение удваивает скорость на порт. Для кластеров на ускорителях H100 и H200 с коммутаторами Quantum-2 автор называет основным выбором NDR на 400 гигабит в секунду. XDR на 800 гигабит рассчитан на системы Blackwell и платформу Quantum-X800.
-
Заложите запас под GDR. Поколение на 1,6 терабита появится в массовой продаже позже, но оптику автор советует планировать с запасом заранее.
-
Выберите топологию. В классическом Fat-Tree («толстое дерево») каждый листовой коммутатор InfiniBand (InfiniBand switch) подключён к каждому магистральному, поэтому между любыми двумя узлами есть несколько путей. В ИИ-кластерах всё чаще берут rail-optimized: видеокарты номер 0 всех серверов подключены к «рельсу» 0, видеокарты номер 1 к «рельсу» 1, и обмен идёт по кратчайшему пути.
-
Проверьте лимит адресов. Внутри подсети устройства адресуются через LID, 16-битный локальный номер. Он ограничивает одну подсеть InfiniBand примерно 49 тысячами адресов.
-
Назначьте Subnet Manager и резерв. Subnet Manager (программа-диспетчер сети) находит устройства, раздаёт им адреса, считает маршруты и рассылает таблицы на все коммутаторы. Обычно он работает на одном из узлов или на отдельном сервере, а резервный ждёт своей очереди.
-
Проверьте кабели при развёртывании. Rail-optimized требует тщательного планирования кабельной инфраструктуры. Одна перепутанная пара ломает кратчайший путь.
Исходные данные: кластер на 16 384 ускорителя, обучение плотной модели через AllReduce. Ethernet-фабрика упирается в переполнение буферов на коммутаторах и каскады пауз, и доля полезных вычислений падает с 51,4% до 34,2%. InfiniBand NDR с технологией SHARPv3 считает сумму прямо на коммутаторе, вдвое сокращает коллективный трафик и держит загрузку на 52,8%.
- Считать InfiniBand быстрым Ethernet и переносить привычки настройки один в один.
- Надеяться, что тонкая настройка RoCEv2 закроет разрыв. Автор пишет, что «лучшей настройкой» его не объяснить.
- Держать один Subnet Manager без резервного.
- Экономить на проверке кабелей: ошибка в топологии или в настройке диспетчера ведёт к неоптимальной маршрутизации.
Что это даёт вам, если вы не строите кластер сами?
Автору Дзена. Это готовый сюжет о том, почему обучение ИИ упирается не только в видеокарты, но и в сеть. Пара цифр загрузки, 52,8% против 34,2%, объясняет это нагляднее любых эпитетов.
Маркетологу и продажнику в ИТ. При выборе подрядчика спрашивайте не пиковую скорость порта, а поведение сети под нагрузкой и долю полезных вычислений. Это вопрос, который отделяет понимающего интегратора от продавца коробок.
Предпринимателю в РФ и СНГ. О доступности оборудования в России автор не пишет, так что уточняйте у поставщика. Если вы арендуете мощности для дообучения, спросите провайдера, какая сеть стоит в кластере. Если вы пользуетесь готовыми моделями, например YandexGPT или GigaChat, сеть кластера остаётся заботой их разработчиков.
На мой взгляд, самая ценная мысль разбора не в скорости, а в предсказуемости: под нагрузкой выигрывает та сеть, которая не теряет пакеты. Честная оговорка: цифры по 16 384 ускорителям относятся к огромным кластерам, а для пары серверов дообучения выгода InfiniBand может не окупить затрат. Считайте масштаб до покупки, а не после.
Разбираетесь в ИИ глубже конкурентов?
В dzen.guru мы переводим сложные темы про нейросети на язык авторов и предпринимателей и показываем, как применять их в работе.
Перейти в dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Детектор дипфейков встроили в IVA MCU: подмену лица ловят во время созвона, а не после платежа
Компании VisionLabs и IVA Technologies встроили детектор дипфейков в российскую платформу видеосвязи IVA MCU, и теперь подмену лица ловят прямо во время…
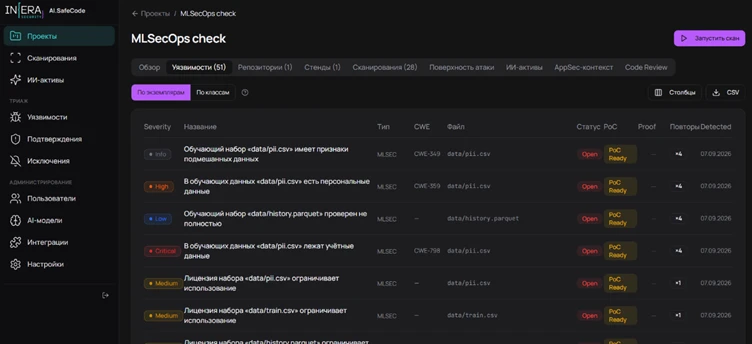
MLSecOps-сканирование находит ИИ-активы в репозитории до релиза: недели ручной работы не нужны
Сканер безопасности ИИ в платформе INFERA AI.SafeCode собирает в один реестр модели, промпты, ИИ-агентов и обучающие данные из репозитория и проверяет их до…
MCP-сервер пустил ИИ-агентов в управление доступом: у Okta, Ping и Auth0 разная готовность
Okta, Microsoft, Ping и Auth0 уже подключают ИИ-агентов к своим системам управления доступом через MCP, общий разъём между нейросетью и сервисом, но сверка…
Комментарии