
Разработчик ИИ-инструментов замерила реальное ускорение: не в 10, а в 1,3–4 раза
Разработчик, работающая с ИИ-инструментами на собственных проектах, опубликовала на Хабре детальный разбор реальной эффективности нейросетей в цикле разработки, от планирования до проверки безопасности, и цифры оказались скромнее, чем обещает маркетинг.
Автор замерила ускорение не по скорости генерации кода, а по времени до рабочего и безопасного результата, и получила от 1,3 до 4 раз вместо обещанных «в десять раз быстрее», а главным узким местом назвала безопасность, которую ИИ-агенты (программы, выполняющие задачи самостоятельно) систематически игнорируют.
Публикация на Хабре ценна тем, что автор использовала не один инструмент, а целый набор: коммерческие модели Claude и GPT-4o в редакторе Cursor, российский GigaCode, а также открытые модели (модели с доступным исходным кодом) Qwen2.5-Coder и DeepSeek-Coder через Ollama (программу для локального запуска нейросетей на своём компьютере). Это не рекламный кейс одного вендора, а сравнение на живых задачах.
| Что | Когда | Кто опубликовал | Цена |
|---|---|---|---|
| Практический разбор ИИ-инструментов в полном цикле разработки | Июнь 2025 | Разработчик ИИ, автор Хабра | Бесплатная публикация |
Где ИИ ускоряет, а где создаёт иллюзию?
-
Планирование даёт самый стабильный выигрыш. Подготовка спецификации, декомпозиция задачи, поиск противоречий и забытых сценариев: 30-60 минут вместо одного-двух вечеров. Разработчик ИИ-помощнику формулирует цель, ограничения, крайние случаи и требования к безопасности, а агент готовит черновик.
-
Типовой код ускоряется в 2,5-4 раза. CRUD-операции (стандартные действия «создать, прочитать, обновить, удалить»), интеграции с API, миграции баз данных, рефакторинг и юнит-тесты (автоматические проверки отдельных функций).
-
Новая бизнес-логика ускоряется только в 1,3-1,8 раза. Архитектурные решения и нестандартные задачи, иногда ИИ даже замедлял работу.
-
Главная иллюзия: агент «написал 70-80% кода». После ревью, исправлений и интеграции значительная часть времени уходила на понимание и доработку результата. Просто вместо набора кода разработчик ИИ-сгенерированный результат проверяла и исправляла.
-
Типичные ошибки нейросетей: несуществующие методы и API, код, не вписывающийся в архитектуру, пропущенные проверки, а также галлюцинации (когда модель уверенно выдумывает то, чего нет) в объяснениях.
Безопасность: главное узкое место, которое чаще всего игнорируют
Даже в личных проектах агенты регулярно предлагали небезопасные решения: SQL-инъекции (способ взломать базу данных через поле ввода), XSS (атака через вредоносный скрипт на странице), захардкоженные секреты (пароли прямо в коде) и некорректную обработку данных.
К этому добавились риски, специфичные именно для ИИ-разработки:
- Промпт-инъекция (prompt injection): злоумышленник подсовывает команды через входные данные, и агент выполняет то, что не должен.
- Утечки через логи агентов: модель может записать чувствительную информацию в журнал.
- Supply-chain риски: зависимости и сами ИИ-инструменты могут содержать уязвимости.
Автор описала свой чек-лист: добавила требования безопасности прямо в спецификацию на этапе планирования, ввела отдельный этап проверки безопасности и для чувствительного кода использует локальные модели, которые не отправляют данные на внешние серверы. Это снизило количество очевидных ошибок, но не заменило ручную проверку.
Как попробовать этот подход на своих задачах?
-
Установите Ollama и запустите локально Qwen2.5-Coder или DeepSeek-Coder. Это бесплатно и не требует подписки, данные не покидают ваш компьютер.
-
Начните с планирования, а не с генерации кода. Сформулируйте цель, ограничения, крайние случаи и требования к безопасности. Попросите агента подготовить спецификацию и найти противоречия.
-
Добавьте чек-лист безопасности в промпт (текстовую команду для нейросети). Пропишите в системном промпте (базовой инструкции модели) правила проекта: запрет на хардкод секретов, обязательную валидацию входных данных, проверку зависимостей.
-
Измеряйте время до рабочего результата, а не скорость генерации. Засекайте от постановки задачи до прохождения тестов и ревью, это честная метрика.
Что делать с этим прямо сейчас, по ролям
Автору Дзена и копирайтеру. Подход «сначала спецификация, потом генерация» работает не только с кодом. Если вы используете нейросеть для текстов, попробуйте сначала описать цель, аудиторию, ограничения и потенциальные проблемы, а потом просить черновик. По опыту автора, именно на этапе планирования ИИ стабильнее всего.
Маркетологу. Цифры 2,5-4 раза на типовых задачах и 1,3-1,8 на сложных полезны для оценки реальной экономики ИИ-проектов. Если подрядчик или разработчик ИИ-решений обещает «ускорение в десять раз», есть повод уточнить, что именно считали.
Предпринимателю в РФ. Из упомянутых инструментов GigaCode доступен в России без ограничений. Qwen2.5-Coder и DeepSeek-Coder запускаются локально через Ollama, это тоже работает без VPN. Закрытые модели Claude и GPT-4o требуют зарубежного доступа.
Российские аналоги: GigaCode и YandexGPT
| Параметр | GigaCode (Сбер) | Cursor с Claude/GPT-4o |
|---|---|---|
| Доступность в РФ | Без ограничений | Требует зарубежного доступа |
| Данные остаются локально | Зависит от режима | Нет, отправляются на серверы |
| Тип модели | Закрытая модель | Закрытая модель |
| Стоимость | Бесплатный тариф есть | Подписка от $20 в месяц |
YandexGPT и GigaChat можно использовать для этапа планирования и спецификации, если генерация кода не нужна: сформулировать требования, найти противоречия, подготовить чек-лист безопасности.
Этот разбор ценен именно тем, чего обычно не хватает в хайповых публикациях: честных цифр после ревью. На мой взгляд, ключевой вывод, что скорость генерации кода легко опережает скорость его контроля, применим далеко за пределами программирования. Мы в dzen.guru видим то же самое с текстами: нейросеть выдаёт черновик за минуту, а проверка фактов и доводка до публикации занимают столько же, сколько раньше.
Что стоит сделать сегодня: возьмите любую задачу, которую вы делегируете ИИ, и замерьте не время генерации, а время до готового результата, включая проверку. Скорее всего, реальное ускорение окажется скромнее, чем кажется, но всё равно заметным. И обязательно проверяйте безопасность: даже если вы не программист, промпт-инъекции через входные данные касаются любого, кто встраивает нейросети в свои процессы.
Частые вопросы
Нужна ли мощная видеокарта для локальных моделей?
Qwen2.5-Coder и DeepSeek-Coder через Ollama запускаются на обычном компьютере. Для небольших моделей (7 миллиардов параметров) достаточно 8 гигабайт оперативной памяти. Для моделей покрупнее (33 миллиарда параметров) понадобится видеокарта с 16 и более гигабайтами видеопамяти. Автор не уточняла конфигурацию, но Ollama поддерживает и процессорный режим, просто медленнее.
Правда ли, что открытые модели уже не хуже закрытых?
По данным автора, открытые модели закрывают значительную часть повседневных задач, особенно при хорошем контексте и инструментах. Но на сложных задачах закрытые модели пока часто выигрывают по качеству. Это не приговор: для типовых задач, которые составляют основную массу работы, локальные модели уже достаточны.
Что делать, если я не программист, но хочу использовать ИИ безопаснее?
Главный принцип из разбора: не передавайте нейросети чувствительные данные (пароли, персональные данные клиентов, финансовую информацию) через облачные сервисы. Для работы с такими данными используйте локальные модели. И всегда проверяйте результат, навык постановки задачи и строгой проверки ответа сейчас важнее, чем умение получить ответ от агента.
Самый точный вывод из всего разбора принадлежит автору: главный навык разработчика ИИ-эпохи не в том, чтобы получить код от агента, а в том, чтобы правильно поставить задачу и строго проверить результат, и это касается любой профессии, где нейросеть уже стала рабочим инструментом.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Облачные серверы с GPU строятся на долге: почему Альтман назвал эту модель «глупее глупого»
Архитектура облачных GPU строится на долге, и 2 сентября 2025 года Сэм Альтман публично назвал эту конструкцию «глупее глупого», указав на молодые компании без…
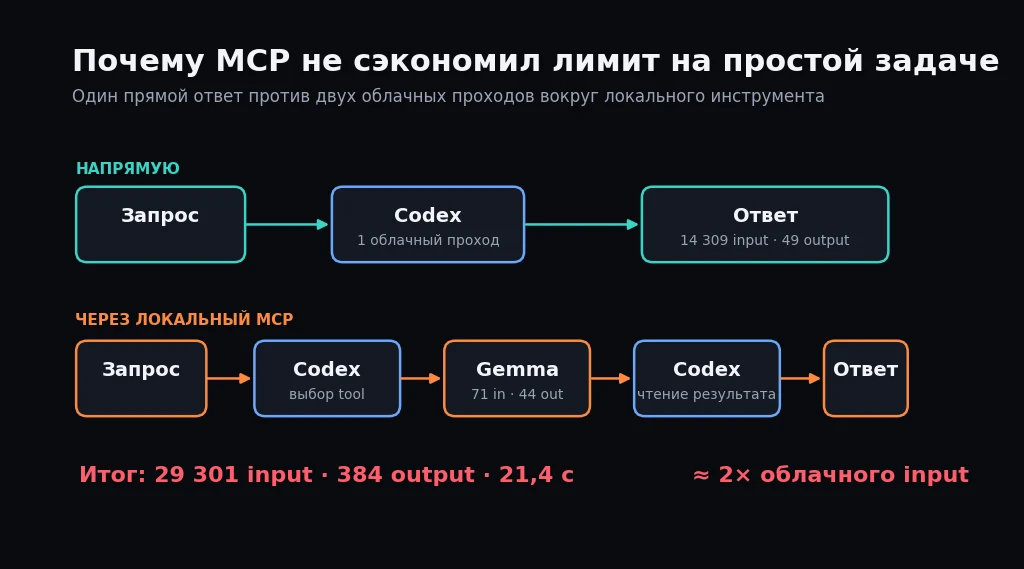
Локальные языковые модели удваивают расход облачных токенов: эксперимент с Gemma на MacBook
Локальные языковые модели на домашнем железе выглядят как способ сэкономить на облачном API, но практический эксперимент с Gemma на MacBook Pro 2019 года…
AI-агенты возвращают пустышки в красивом JSON: 6 ступеней валидации спасают от фальшивого «успеха»
Корректный JSON не значит готовый результат: как не путать «агент ответил» с «задача решена», когда ИИ-агент возвращает пустышку в красивой обёртке. Почему это…
Комментарии