
Локальные языковые модели удваивают расход облачных токенов: эксперимент с Gemma на MacBook
Локальные языковые модели на домашнем железе выглядят как способ сэкономить на облачном API, но практический эксперимент с Gemma на MacBook Pro 2019 года показал, что маршрутизация задач через локальную модель удваивает расход облачных токенов вместо того, чтобы их сокращать.
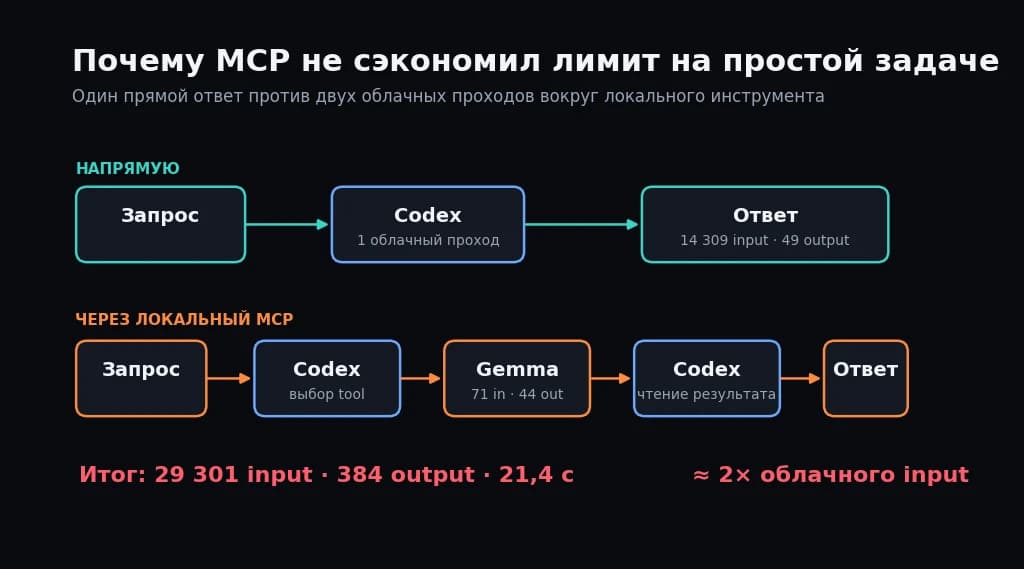
Эксперимент на реальном оборудовании разрушает популярную гипотезу: делегирование простых задач локальной модели не убирает облачные вызовы, а добавляет второй проход. Экономия не просто маленькая, она отрицательная.
Разговор о переносе нейросетей на собственный компьютер идёт давно. Логика кажется железной: зачем платить за облако, если короткий разбор ошибки или сводку лога может сделать компактная модель прямо на ноутбуке? Автор эксперимента, разработчик с MacBook Pro 16 2019 года (шестиядерный Intel Core i7, 16 ГБ оперативной памяти, Radeon Pro 5300M с 4 ГБ VRAM), решил это проверить на практике и опубликовал подробный разбор с замерами токенов.
Что именно тестировалось?
На ноутбуке уже стояла Ollama (программа для запуска локальных языковых моделей) с двумя версиями Gemma: gemma3:4b и gemma2:2b. Это компактные открытые модели от Google, где «4b» и «2b» означают 4 и 2 миллиарда параметров соответственно.
Автор собрал MCP-сервер (Model Context Protocol, протокол, через который Codex от OpenAI общается с внешними инструментами). Схема работы задумывалась так:
- Пользователь ставит задачу Codex
- Codex определяет, что задача простая
- Передаёт её Gemma через локальный инструмент
- Получает результат и проверяет его
- Облачный инференс (вычисление ответа на серверах OpenAI) не тратится на рутину
Сервер записывал не промпты и код, а только хеш запроса, длину контекста, модель, время и число токенов. Подход к приватности разумный: иначе «локальный помощник» превращается в ещё одно хранилище исходников.
Аргументы за локальную маршрутизацию
Идея делегирования простых задач локальным языковым моделям опирается на несколько реальных преимуществ.
Механическая обработка текста работает. Обе модели справились с извлечением портов из Docker Compose, определением зависимости Redis, объяснением ошибки SMTP 535 и написанием commit message. Для задач уровня «распарси, извлеки, перефразируй» даже двухмиллиардная модель даёт приемлемый результат.
Данные не покидают машину. Всё вычисляется локально, промпты не уходят на чужой сервер. Для команд, работающих с чувствительным кодом, это аргумент, который перевешивает вопрос скорости.
Нулевая стоимость самого инференса. Электричество и износ ноутбука стоят несравнимо меньше, чем токены облачного API. Если удастся убрать облачный проход, экономия реальна.
Аргументы против: почему экономия не состоялась?
Два облачных прохода вместо одного. Это центральная проблема. Codex сначала читает запрос и решает, какой инструмент вызвать (первый облачный проход). После того как Gemma отработала, Codex получает контекст вместе с результатом и формирует финальный ответ (второй облачный проход). Локальная модель выполняет работу посередине, но сама эта работа почти ничего не вычитает из контекста Codex.
На одной простой задаче маршрут через локальную модель использовал примерно в два раза больше облачного input, чем прямой ответ Codex.
Качество ответов на задачах безопасности провалилось. Автор дал gemma3:4b фрагмент кода с уязвимостью path traversal (атака, при которой злоумышленник через имя файла вроде ../../etc/passwd получает доступ к чужим файлам). Модель упомянула проблему, но главным исправлением предложила заменить бинарный режим записи на текстовый. Опасное имя файла осталось опасным, а загрузка бинарных файлов дополнительно сломалась.
gemma2:2b выступила немного лучше: указала на пользовательский upload.filename, но посоветовала функции, которые соединяют пути, а не обезвреживают их.
Логические задачи тоже не по силам. На задаче с записью в базу данных, где старая запись навсегда блокировала новую, четырёхмиллиардная модель предложила перевести русское сообщение об ошибке на английский. Двухмиллиардная заметила проблему, но объяснила настолько путано, что готовое исправление из ответа получить нельзя.
Обе модели работали на CPU. Несмотря на дискретную видеокарту с 4 ГБ видеопамяти, Ollama показывала 100% загрузки процессора. Скорость gemma3:4b составила около 9,5 токена в секунду, что делает ожидание ответа ощутимым.
Маленькие модели подходят для механической обработки текста, но не для окончательного ревью безопасности и предметной логики. : Автор эксперимента, разбор с замерами токенов
Что делать с этим прямо сейчас?
Автору Дзена. Локальные языковые модели уже пригодны для черновой работы: суммаризация заметок, генерация вариантов заголовков, переформулировка абзаца. Но доверять им факт-чекинг или финальную редактуру нельзя: галлюцинации (когда модель уверенно выдумывает то, чего не было) на моделях в 2-4 миллиарда параметров случаются чаще, чем в больших облачных.
Маркетологу. Если вы строите пайплайн «локальная модель обрабатывает, облачная проверяет», посчитайте реальный расход токенов до запуска. Схема с маршрутизацией может стоить дороже, чем прямой вызов облака. Экономия появляется только там, где локальная модель полностью заменяет облачный вызов, а не дополняет его.
Предпринимателю в РФ. Codex от OpenAI официально недоступен в России, но Ollama и модели Gemma работают на любом компьютере без ограничений по региону. Из российских аналогов для локального запуска есть модели от Сбера (GigaChat, часть функций доступна через API) и Яндекса (YandexGPT, пока только облачный). Ценность эксперимента в том, что он показывает границы применимости компактных моделей на обычном железе.
Эксперимент ценен не результатом, а методом. Автор не поверил маркетинговому обещанию «запусти локально и сэкономь», а замерил реальные токены по событиям turn.completed. Вывод, на мой взгляд, точный: локальные языковые модели полезны как самостоятельные инструменты для конкретных механических задач, но плохо работают как прослойка между пользователем и облаком. Если Gemma разбирает лог сама и отдаёт готовый ответ, облако не нужно. Если она вставлена в цепочку с Codex, облако платит дважды. Для авторов и маркетологов я бы сформулировал правило так: используйте локальную модель там, где её ответ финальный, и не пытайтесь делать из неё маршрутизатор для облака.
Компактные открытые модели будут расти в качестве, и граница «что можно отдать на локальный инференс» будет сдвигаться. Но архитектурная ловушка с двойным облачным проходом никуда не денется, пока оркестратор сам работает в облаке. Реальная экономия придёт не от маршрутизации, а от момента, когда локальная модель станет достаточно сильной, чтобы закрывать задачу целиком, без проверяющего сверху.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Нейросеть для написания кода сэкономила часы, но проект растянулся на два месяца: почему
Нейросеть пишет код за часы, но 90% времени всё равно уходит на решения, которые она принять не может: русский разработчик разбирает реальный проект с…
Персональные нейросети как хобби: Java-разработчик собрал рабочий дашборд за вечера с ИИ
Персональные нейросети способны превратить рутину разработчика в управляемый конвейер, и Java-программист с 15-летним стажем показал это на собственном…
Облачные серверы с GPU строятся на долге: почему Альтман назвал эту модель «глупее глупого»
Архитектура облачных GPU строится на долге, и 2 сентября 2025 года Сэм Альтман публично назвал эту конструкцию «глупее глупого», указав на молодые компании без…
Комментарии