
qwenGPU добавил Qwen3.5-2B 45 скомпилированных GPU-слоёв на CUDA: модель считает сама
Разработчик Vixhal выложил на GitHub qwenGPU, сборку небольшой модели Qwen3.5-2B со встроенным графическим процессором, и на компиляторе проекта Qwenputer проверил, может ли нейросеть считать точно сама, без внешнего калькулятора.
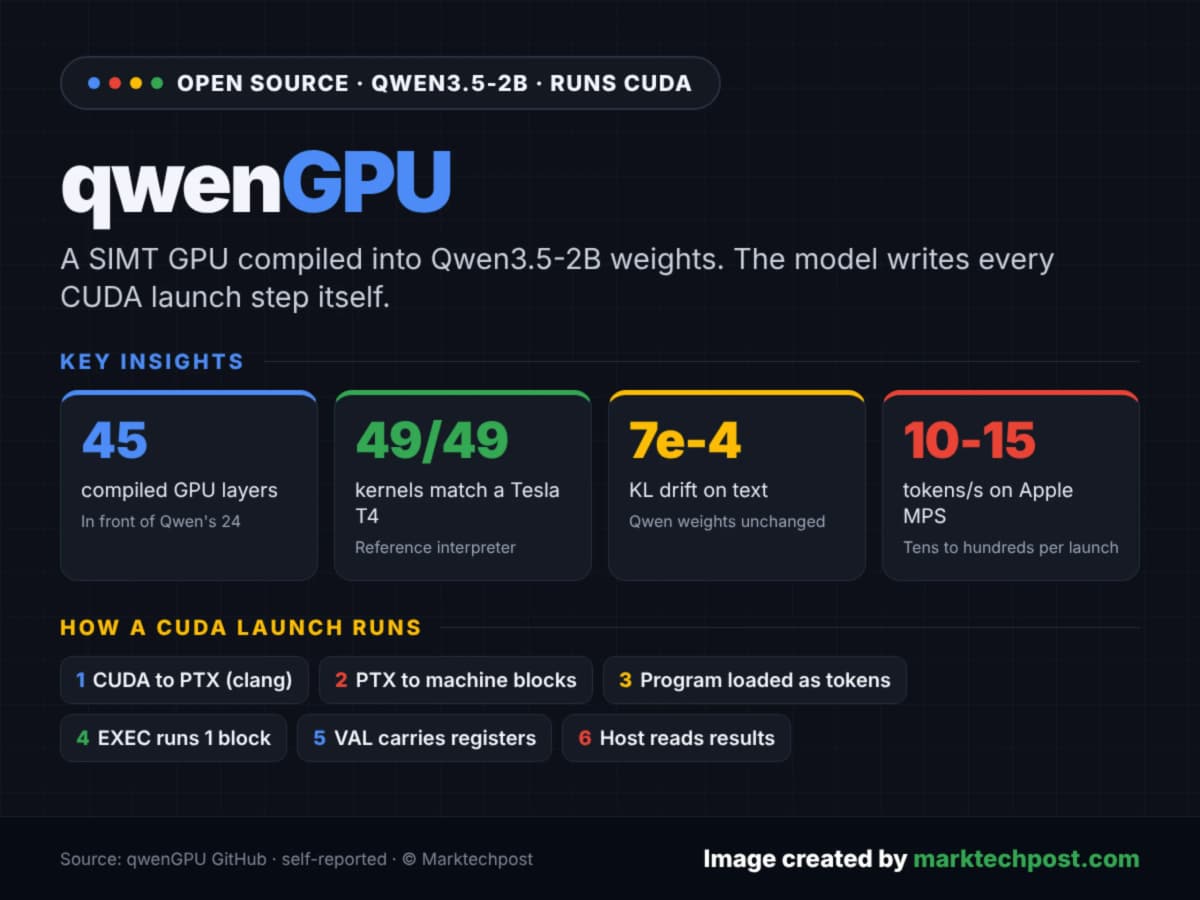
Нейросеть здесь не угадывает число, а вычисляет его: результат лежит во внутренней памяти модели, внешняя программа его только считывает. Это проверка идеи точных вычислений внутри обученной модели, а не рядом с ней.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| qwenGPU, Qwen3.5-2B с 45 скомпилированными GPU-слоями | Дату релиза источник не называет | Разработчик Vixhal (@TheVixhal) | Бесплатный код под лицензией MIT |
Обычно языковая модель лишь пишет программу, а считает её отдельная машина. В qwenGPU, по описанию из репозитория на GitHub и в обзоре Michal Sutter, процессор собран прямо из весов модели (числовых настроек, в которых хранится всё, что модель умеет). Формулировку «знакомьтесь с qwenGPU: Qwen3.5-2B с 45 скомпилированными GPU-слоями, работающими на CUDA» стоит понимать буквально. Это исследовательская демонстрация, а не инструмент для работы.
Что нового?
- Модель стала длиннее, но не умнее. К 24 слоям Qwen3.5-2B спереди добавили 45 слоёв графического процессора, всего 69. Ни один новый слой не обучали: каждый вес рассчитал компилятор.
- Внутри работает маленький параллельный процессор. Это машина SIMT (одна команда выполняется сразу на нескольких потоках, как у видеокарт) на 4 потока. На каждый поток приходится 15 регистров, есть постоянная память на 32 блока программы и 126 ячеек данных.
- Память устроена хитро. Разработчик использовал собственные слои Qwen (Gated DeltaNet, внутренняя «записная книжка» модели): каждая запись перезаписывает ровно одну строку, а запрос читает её обратно, как ячейку памяти.
- Модель запускает настоящий код CUDA, то есть программы, которые пишут для видеокарт NVIDIA. Поддерживаются целочисленная арифметика, ветвления, циклы, общая память и синхронизация потоков.
- Текстовые способности почти не пострадали. На обычном тексте процессорная часть отключена, веса Qwen не менялись. Расхождение KL (мера отличия ответов от оригинальной модели) составляет около 0,0007.
В демо-ролике модель перемножает векторы [1, 2, 3] и [4, 5, 6] и получает 32. Весь запуск занял 47 токенов (токен, это кусочек текста, которым оперирует модель).
Цифры точности самоотчётные, и это главное ограничение
Все результаты разработчик измерял сам на компьютере Apple. Независимой проверки источник не приводит, поэтому читайте их как заявку, а не как вердикт.
- Каждый запуск при повторной проверке дал точный результат.
- Эталонный интерпретатор совпал с настоящей видеокартой NVIDIA Tesla T4 на 49 из 49 тестовых программ.
- В обычном режиме модель ответила на 20 из 24 выборочных вопросов с числами, посчитанными внутри.
- В продвинутом режиме Qwen сама пишет программу на CUDA и сделала её верно с первой попытки в 4 случаях из 5.
Скорость около 10–15 токенов в секунду на Apple, поэтому сам источник называет проект демонстрацией, а не рабочей средой. В описании прямо сказано, что программы, которые пишет модель размером 2B, пока ненадёжны. Готовой сжатой версии нет, нужно около 16 ГБ свободной памяти.
Как попробовать самому?
- Установите Python 3.11 или новее, утилиты uv и just, освободите около 16 ГБ памяти. Подойдут компьютер Apple, видеокарта NVIDIA или обычный процессор.
- Скачайте репозиторий qwenGPU с GitHub.
- Выполните команду just build: она сама загрузит Qwen3.5-2B и встроит в неё процессор. Готовой сборки автор не публикует, собранная модель подпадает под лицензию Qwen Apache-2.0.
- Для продвинутого режима дополнительно поставьте компилятор clang с поддержкой NVPTX.
О региональных ограничениях источник ничего не сообщает: код открыт, модель скачивается при сборке.
Чем это отличается от YandexGPT и GigaChat?
Из доступных в РФ аналогов для повседневной работы, YandexGPT и GigaChat. Прямого сравнения с ними источник не проводит, и оно было бы некорректным: qwenGPU не ассистент для текстов, а опыт по встраиванию вычислителя в модель.
Ближайшие родственники проекта зарубежные. Qwenputer Дивьянша Агравала встраивает 32-битный процессор RISC-V в Qwen3.5-4B, а Percepta в марте 2026 года собрала внутри трансформера интерпретатор WebAssembly. Скорости этих проектов, по оговорке источника, напрямую не сравнить: железо и типы токенов разные.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Это хороший повод для объясняющего материала о том, почему чат-боты ошибаются в расчётах и как разработчики пробуют это исправить. Пример с векторами и ответом 32 понятен без технической подготовки.
Маркетологу. Экономика работы не меняется: продуктом qwenGPU не станет. Но цифры в отчётах, которые считает нейросеть, по-прежнему стоит перепроверять вручную.
Предпринимателю в РФ и СНГ. Внедрять нечего, наблюдать стоит. Если идея точных вычислений внутри модели приживётся в крупных системах, ИИ-агентам (программам, которые сами выполняют задачи) можно будет доверять расчёты без внешних инструментов.
На мой взгляд, это красивая инженерная работа: модель превратили в компьютер, не обучив ни одного нового слоя. Оговорка серьёзная: цифры самоотчётные, скорость черепашья, а свой код модель пишет верно не всегда. Что сделать сегодня: возьмите три последних текста, где нейросеть помогала с цифрами, и пересчитайте их калькулятором. Ошибки найдутся почти наверняка, и это лучший аргумент, зачем вообще нужны такие эксперименты.
Что чаще всего спрашивают про qwenGPU?
Можно ли пользоваться qwenGPU как обычным чат-ботом?
Технически да, текстовые ответы почти не отличаются от исходной Qwen3.5-2B. Но маленькая модель на 2 миллиарда параметров уступает крупным ассистентам, а встроенный процессор ради чата никто не собирал.
Нужна ли видеокарта NVIDIA?
Нет. Проект запускается на Apple, на видеокарте NVIDIA или на обычном процессоре, нужны лишь около 16 ГБ свободной памяти. Компилятор с поддержкой NVPTX понадобится только для продвинутого режима.
Кто считает результат, модель или компьютер?
По описанию разработчика, модель. Компьютер переводит программу в понятный ей вид и подаёт данные, а ответ считывает из памяти модели готовым, ничего не досчитывая.
Если через год точный счёт внутри нейросети станет нормой, начинался он с таких игрушечных 32 из [1, 2, 3] и [4, 5, 6], поэтому следить за проектом стоит уже сегодня.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
OpenAI предложила называть дата-центры «кампусами ИИ-вычислений»: ставка на выборы 2028 года
OpenAI готовит пиар-кампанию на период после выборов в Конгресс США и на фоне непопулярности дата-центров предлагает называть их «кампусами ИИ-вычислений»,…
Нейросеть сама спроектировала редуктор в КОМПАС-3D: от расчёта до чертежей и спецификации
Энтузиаст ИИ-агентов выпустил плагин, через который нейросеть сама строит детали, сборки и чертежи в КОМПАС-3D, и проверил его на типовой студенческой…
OpenAI запустила рекламу в ChatGPT: показ получает не тот, кто больше заплатил
OpenAI запустила рекламу в ChatGPT и 21 октября 2026 года раскрыла её устройство, а значит, борьба за клиента переезжает из поисковой выдачи прямо в диалог с…
Комментарии