
Поиск не спасает от галлюцинаций нейросетей: GPT-4o нередко выдумывает без данных
Авторы работы Sufficient Context показали, что поиск по документам сам по себе не защищает ИИ от выдумки: GPT-4o, Claude 3.5 и Gemini 1.5 Pro при нехватке сведений нередко отвечают вместо честного отказа.
Это один из ответов на вопрос, что такое галлюцинации нейросетей в RAG, то есть в поиске с генерацией: система сначала находит документы, а потом пишет по ним ответ. Галлюцинация здесь означает уверенный ответ, который найденные документы не подтверждают.
| Показатель | Значение | Источник |
|---|---|---|
| Размер проверочной выборки | 115 сложных пар «вопрос плюс контекст» | Joren и соавторы, Sufficient Context |
| Точность оценщика Gemini 1.5 Pro с одним примером в инструкции | 93% | Joren и соавторы, Sufficient Context |
| Размер фрагмента для оценщика FLAMe | 1600 токенов | Joren и соавторы, Sufficient Context |
| Доля правильных ответов при недостаточном контексте на основных бенчмарках | от 35 до 62% | Joren и соавторы, Sufficient Context |
| Число типов свидетельств в проверке поведения моделей | 5, от полного подтверждения до противоречия | Zhang и Wu |
Что измеряли?
Ключевое слово исследования: достаточность. Документ может быть релевантным, то есть близким к вопросу по теме, но не содержать самого ответа. Достаточность относится к паре «вопрос плюс найденный текст»: хватает ли в тексте сведений, чтобы построить ответ.
Пример из работы простой. Если в документе сказано, что мать Боба родилась в Нью-Йорке, из этого нельзя заключить, что там же родился сам Боб. Недостающую связь модель часто достраивает сама, и именно так рождается выдумка.
Большая языковая модель (LLM, программа, которая продолжает текст самым вероятным образом) обучена писать гладко. Гладкая фраза ещё не доказывает, что у ответа есть основания. Собственная оценка уверенности модели тоже может отражать её привычку к определённому ответу, а не качество найденных документов.
Авторы назвали контекст достаточным, если из него можно получить правдоподобный ответ подходящего типа: спрашивают место рождения, значит, ответом должно быть место. Эталонный ответ для такой проверки не нужен, поэтому её можно запускать прямо во время работы бота, когда правильный ответ заранее неизвестен.
Для проверки собрали оценщика на базе LLM: ему передают вопрос и текст и спрашивают, хватает ли сведений. Люди разметили 115 сложных пар из нескольких бенчмарков (стандартных наборов вопросов для сравнения моделей), не опираясь на эталонные ответы.
Что обнаружили?
- Оценщик на Gemini 1.5 Pro с одним примером в инструкции дал 93% точности на этих 115 парах.
- Крупные модели, среди них Gemini 1.5 Pro, GPT-4o и Claude 3.5, обычно хорошо отвечали при достаточном контексте, но при недостаточном нередко выбирали ответ вместо отказа.
- Более слабые модели из исследования, включая Mistral и Gemma, ошибались или отказывались даже тогда, когда нужные сведения в тексте были.
- При недостаточном контексте модели всё равно давали правильный ответ в доле случаев от 35 до 62% на основных бенчмарках. Причины авторы видят в знаниях из обучения, полезной частичной подсказке, удачном выборе между трактовками вопроса и ошибках самого оценщика.
- Более дешёвый оценщик FLAMe работал с фрагментами по 1600 токенов (токен, это кусочек слова, которыми модель считает текст). Пару признавали достаточной, если хватало хотя бы одного фрагмента, а значит, факты, разнесённые по разным кускам, могли потеряться.
Вывод авторов прямой: улучшать поиск полезно, но одного поиска мало, если модель не умеет пользоваться найденным. Две соседние работы копают глубже. Lavi и соавторы ищут сигнал «ответа нет» во внутренних вычислениях модели. Zhang и Wu проверяют, как модели меняют поведение при пяти типах свидетельств.
93% получены на небольшой специально собранной выборке из 115 пар, это не гарантия такого же качества на ваших документах. Оценщик сам по себе модель со своими ошибками, а достаточный контекст не означает, что источник прав: текст может ясно подтверждать ошибочное утверждение.
Что это значит для вас?
Из работы следует практичная мысль: у бота по документам должно быть больше двух исходов. Кроме ответа нужен отказ, вопрос-уточнение или повторный поиск. Обратная крайность тоже плоха: система, которая отказывается при любом сомнении, теряет правильные ответы, поэтому авторы рассматривают выборочную генерацию и меряют долю вопросов, на которые бот ответил.
Автору Дзена. Если пишете статью с помощью ИИ по загруженным материалам, проверяйте каждую связку фактов. Модель может склеить два верных факта в неверный вывод, как в примере с Бобом.
Маркетологу. Перед запуском бота поддержки соберите два набора вопросов. В первом ответ в базе знаний есть, во втором его специально нет. Бот должен отвечать на первые и честно отказываться на вторые.
Предпринимателю в РФ и СНГ. Из доступных в России моделей YandexGPT и GigaChat. Тот же двойной тест стоит прогнать и на них, а в промпт прописать прямую инструкцию: если в документах нет ответа, сообщить об этом и предложить уточнить вопрос.
Правильный ответ при нехватке сведений не доказывает, что он взят из документов. Если вашей сфере нужно строгое подтверждение источником, например в юридических или медицинских текстах, такой ответ лучше запрещать, даже когда он случайно верен.
На мой взгляд, главная ценность работы в том, что она разводит два вопроса, которые обычно смешивают: «нашли ли мы нужные документы» и «есть ли в них ответ». Я бы начинал любой проект с базой знаний не с выбора модели, а с набора вопросов без ответа в документах. Бот, который умеет сказать «в материалах этого нет», в работе ценнее бота, который всегда отвечает гладко.
По данным работы Sufficient Context (Joren и соавторы)

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
OpenAI предложила называть дата-центры «кампусами ИИ-вычислений»: ставка на выборы 2028 года
OpenAI готовит пиар-кампанию на период после выборов в Конгресс США и на фоне непопулярности дата-центров предлагает называть их «кампусами ИИ-вычислений»,…
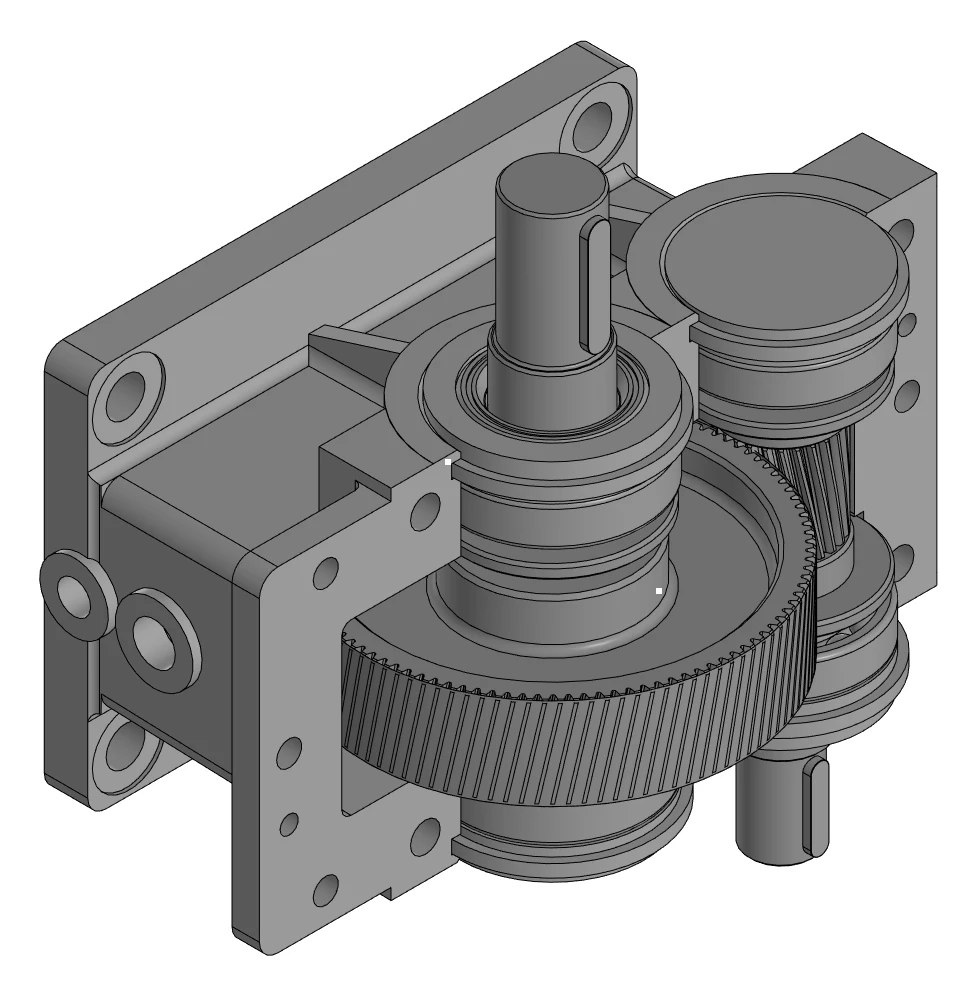
Нейросеть сама спроектировала редуктор в КОМПАС-3D: от расчёта до чертежей и спецификации
Энтузиаст ИИ-агентов выпустил плагин, через который нейросеть сама строит детали, сборки и чертежи в КОМПАС-3D, и проверил его на типовой студенческой…
OpenAI запустила рекламу в ChatGPT: показ получает не тот, кто больше заплатил
OpenAI запустила рекламу в ChatGPT и 21 октября 2026 года раскрыла её устройство, а значит, борьба за клиента переезжает из поисковой выдачи прямо в диалог с…
Комментарии