
Парсеры текстов сайта без LLM: российский проект ускорил разбор документов в 40 раз за 8 млн ₽
Парсеры текстов сайта, анализаторы документов и прочие инструменты извлечения данных из текста привычно ассоциируются с большими языковыми моделями, но российский проект Real AI SA за два года и 8 миллионов рублей построил работающий семантический анализатор вообще без них.
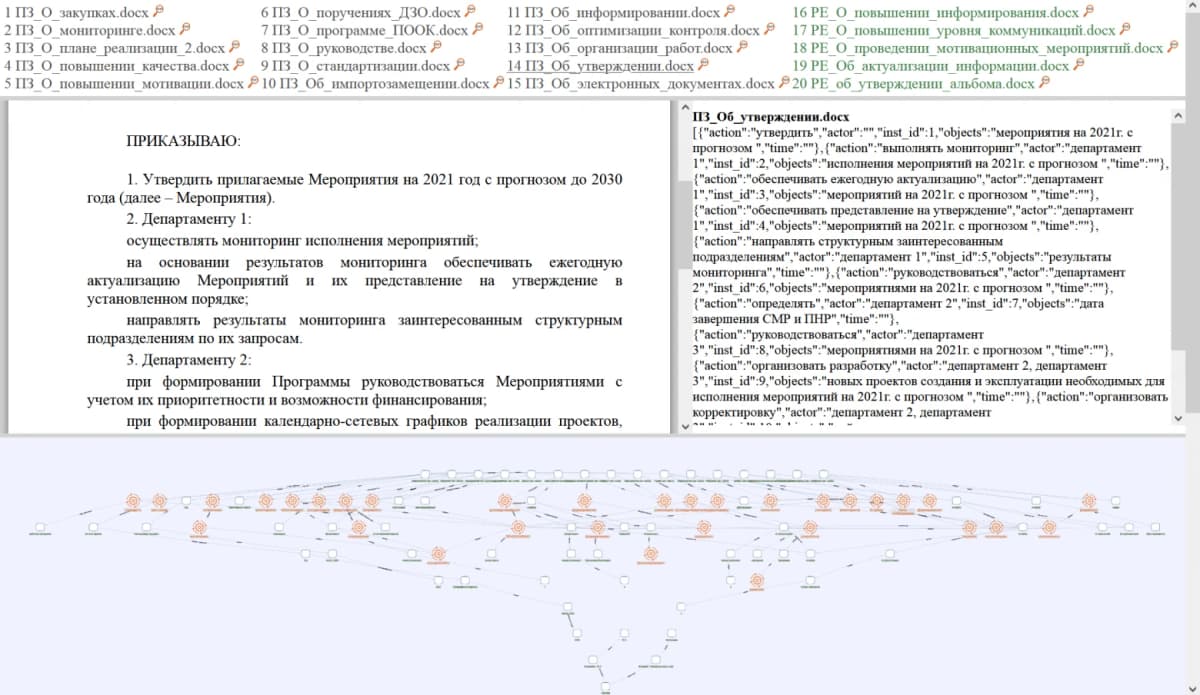
Проект доказал на пилоте, что извлечение поручений из приказов можно ускорить в 40 раз, до 15 секунд на документ, без облака, без интернета и без передачи данных за периметр компании.
Спор о том, нужна ли большая языковая модель для каждой задачи с текстом, идёт с момента массового появления ChatGPT. Одни считают, что LLM (большая языковая модель, программа, обученная на огромных массивах текста и умеющая генерировать ответы на естественном языке) закрывает любую потребность. Другие напоминают: есть сценарии, где облачный ИИ неприменим по соображениям безопасности, бюджета или повторяемости результата. Команда проекта Real AI SA опубликовала отчёт о двух годах разработки и первом бизнес-кейсе, и этот отчёт даёт конкретные аргументы обеим сторонам.
Что сделала команда Real AI SA?
Real AI SA находит в тексте понятия и определяет связи между ними, выстраивая граф (схему связей между элементами) в формате JSON. Текст раскладывается по грамматическим и семантическим признакам, каждый элемент становится либо действием, либо свойством, либо объектом.
Теоретическая основа простая: любой текст описывает действия и их результаты, а объекты представляют собой устойчивую совокупность свойств. Онтология (заранее выстроенная система классов предметной области) не нужна, что упрощает масштабирование.
За два года в базу знаний анализатора внесли около 5000 понятий, потратив 8 миллионов рублей. Первый бизнес-сценарий, автоматическое извлечение матрицы поручений из приказов и распоряжений для системы электронного документооборота (ЭДО, система, через которую организации обмениваются и хранят документы в электронном виде).
На обработку одного документа у помощника руководителя уходило 7 до 10 минут. После внедрения модуля Real AI SA время сократилось до 15 секунд.
Аргументы за: когда парсер без LLM выигрывает?
Команда проекта приводит пять сценариев, в которых LLM либо неприменима, либо избыточна:
- Повторяемость результата. Анализатор выдаёт одинаковый ответ на одинаковый текст. Галлюцинации (ситуации, когда ИИ уверенно выдумывает факты) исключены архитектурно.
- Конфиденциальность. Работа ведётся без доступа в интернет, данные не покидают внутренний контур. Для российских компаний, работающих с закрытыми приказами и распоряжениями, это не каприз, а требование информационной безопасности.
- Минимальные ресурсы. Анализатор запускается на машине с 4 ГБ оперативной памяти. Не нужны GPU-серверы, не нужна оплата облачных API.
- Отсутствие размеченных данных. Дообучение (обучение модели на ваших примерах под узкую задачу) LLM требует массива размеченных данных и специалистов. Real AI SA расширяется через пополнение базы знаний терминами и сокращениями конкретной предметной области.
- Экономия. 8 миллионов рублей за два года разработки вместе с созданием базы знаний, при том что подписка на облачные LLM для крупной организации с большим документооборотом может обходиться в сопоставимые суммы ежегодно.
Аргументы против: где подход без LLM проигрывает?
Честный разбор требует признать ограничения, которые команда сама перечислила в отчёте:
- Только текст. Сканы документов анализатор не обрабатывает. LLM-решения с мультимодальностью (способность модели работать одновременно с текстом, изображениями и другими форматами) справляются и со сканами.
- Только русский язык. Иностранные названия и аббревиатуры допускаются, но после ручного дообучения.
- Ошибки и сленг ломают анализ. Слова с опечатками или сленговые выражения, скорее всего, разберутся неправильно. LLM к ошибкам в тексте устойчивее.
- Нет «общих знаний». У анализатора минимальный набор общеизвестных понятий и связей. Всё, что выходит за рамки базы знаний, нужно вносить вручную.
- Сопровождение. Команда честно предупреждает, что на текущем этапе потребуется их участие при внедрении.
Кроме технических ограничений, пилот выявил организационные. Задача по поручениям оказалась слишком узкой. Крупные организации, которым такой инструмент нужнее всего, имеют множество лиц, принимающих решения, и часть из них не заинтересована в изменениях.
Сократим в 40 раз временные затраты. И чего они будут делать в свободное время, чай пить? : Контраргумент руководителя, приведённый командой Real AI SA
Ещё одно наблюдение команды: в крупных организациях бывает рассинхронизация между тем, как отчитываются руководству о внедрении ИИ, и тем, как работа устроена на самом деле. Топ-менеджеры уверяли, что «ИИ давно всё анализирует», а на деле функции ИИ были возложены на одного перегруженного сотрудника.
Что делать с этим прямо сейчас, по ролям?
Автору Дзена и копирайтеру. Парсеры текстов сайта и документов без LLM пока не заменят ChatGPT в генерации контента. Но если вы работаете с регулярными текстами одной структуры (протоколы, ТЗ, чек-листы) и вам важна повторяемость разбора, такой подход может оказаться точнее нейросети.
Маркетологу. Для задач, где нужно массово извлекать структурированные данные из однотипных документов (договоры, спецификации, прайс-листы), решение без LLM убирает риск галлюцинаций и вопрос утечки данных. Парсеры текстов сайта на базе подобных анализаторов могут работать полностью внутри вашей инфраструктуры.
Предпринимателю в РФ. Проект российский, на русском языке, работает офлайн. Для компаний с конфиденциальным документооборотом и запретом на передачу информации в облако это закрывает реальную боль. Команда сейчас развивает анализатор для более широкой задачи: поддержка архива документов в актуальном состоянии, что актуально и для среднего и малого бизнеса.
Я вижу в этом проекте не конкурента LLM, а инструмент для тех случаев, когда LLM применять нельзя или невыгодно. Команда сама подчёркивает, что не противопоставляет Real AI SA нейросетям. По моим наблюдениям, российские компании, работающие с закрытыми документами, часто вообще не внедряют ИИ-инструменты именно из-за требований безопасности. Для них решение, которое запускается на обычном ноутбуке без интернета, снимает главный барьер. Оговорка: проект в стадии развития, пилот пока один, и организационные барьеры при внедрении в крупных структурах команда описала честно. Если ваш бизнес работает с потоком однотипных документов на русском языке и вы не можете отправлять их в облако, стоит следить за развитием проекта и запросить демонстрацию.
Команда потратила два года и 8 миллионов рублей, чтобы доказать жизнеспособность подхода на одном конкретном кейсе. Следующий шаг, расширение до управления архивом документов, покажет, сможет ли анализатор выйти за пределы узкой задачи и стать инструментом, который покупают без участия разработчиков.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Selectel показала, как за 2 часа добавить LLM-ассистента в Wazuh SIEM
Компания Selectel опубликовала пошаговую инструкцию, которая позволяет за два часа добавить языковую модель в Wazuh SIEM и дать аналитикам безопасности…
Как собрать набор знаний для AI агентов по формату OKF от Google
Если вы работаете с ИИ-агентами (программами, которые сами выполняют задачи по вашим указаниям) и замечаете, что агент путает файлы проекта, выдумывает…
Что такое ИИ-агент на практике: как суперагент на MCP заменил ручную пересылку писем
Разработчики и администраторы уже раздали сотрудникам ИИ-агентов, но столкнулись с хаосом: агенты не знают, как устроена компания, у них нет нужных прав, а…
Комментарии