
Как собрать набор знаний для AI агентов по формату OKF от Google
Если вы работаете с ИИ-агентами (программами, которые сами выполняют задачи по вашим указаниям) и замечаете, что агент путает файлы проекта, выдумывает несуществующие функции или забывает договорённости из прошлых сессий, проблема почти всегда в контексте: агент просто не знает ваш проект так, как знаете его вы.
12 июня 2026 года группа инженеров Google Cloud опубликовала открытый формат Open Knowledge Format (OKF), а 24 июля выпустила обновление v0.2 с сигналами доверия и актуальности. Формат описывает, как упаковать знания о проекте так, чтобы и человек, и ИИ-агент читали их одинаково, и агент загружал только нужное, а не весь массив разом.
Разработчик Стас Васильев адаптировал спецификацию OKF под конкретный инструмент Opencode и выложил готовый шаблон. Его подход решает типичную боль: вместо одного раздутого файла инструкций на 500 строк агент получает компактное ядро примерно на 60 строк и больше 25 тематических справочников, которые подгружаются только тогда, когда задача этого требует. Ниже разбираем, как собрать такой набор знаний для своего проекта.
Что понадобится?
- Opencode или другой терминальный ИИ-агент, работающий с файлами проекта. Шаблон ориентирован на Opencode, но структура переносится на любого агента, который умеет читать Markdown.
- Текстовый редактор, поддерживающий Markdown. Подойдёт VS Code, любой редактор на GitHub или даже «Блокнот».
- Git-репозиторий вашего проекта, куда вы положите набор знаний.
- 30 минут на первичную настройку ядра и 1 час, чтобы заполнить тематические файлы под свой проект.
Как устроен набор знаний OKF?
Прежде чем переходить к шагам, полезно понять саму архитектуру. Knowledge bundle (набор знаний) по OKF состоит из обычных Markdown-файлов. В начале каждого файла стоит блок YAML frontmatter (преамбула, несколько строк с метаданными): тип документа, заголовок, описание, теги и дата.
Спецификация OKF намеренно минималистична. Вот её ключевые принципы:
- Только файлы. Можно отправить архивом, положить в любой git-репозиторий, подключить к любой файловой системе.
- Простое форматирование. Читается в любом редакторе, отображается на GitHub, индексируется поиском.
- Только YAML-преамбула для структурированных полей: type, title, description, resource, tags, timestamp.
В обновлении v0.2 добавились необязательные поля, дающие агенту сигналы для оценки источника:
- Provenance (происхождение): откуда взяты данные.
- Trust (доверие): кто создал и проверил информацию, человек или алгоритм.
- Lifecycle & Freshness (жизненный цикл и актуальность): статус документа и дата, после которой знания считаются устаревшими.
- Attestation (подтверждение вычислений): было ли вычисление выполнено заявленным способом.
Сами авторы OKF подчёркивают: эти поля не устраняют галлюцинации (ситуации, когда ИИ уверенно выдумывает то, чего не было) сами по себе, но дают агенту дополнительные сигналы для оценки источника.
Пошаговая инструкция
1. Создайте каталог для набора знаний.
В корне проекта создайте папку, которую будет читать ваш агент. Для Opencode это .opencode/:
mkdir .opencode
2. Создайте точку входа: файл AGENTS.md.
Это не база знаний, а маршрутизатор. Здесь агент узнаёт, что за проект перед ним, и получает ссылки на тематические файлы. Держите его компактным, около 60 строк:
---
type: entry-point
title: "Название вашего проекта"
description: "Краткое описание: что делает проект"
tags: [project, entry]
timestamp: 2026-07-28
---

# Проект: Название

## Стек
- Язык: Go / Python / TypeScript (ваш вариант)
- База: PostgreSQL
- CI: GitHub Actions

## Рабочий процесс
1. Прочитай этот файл.
2. Перед архитектурным решением загрузи `_concepts.md`.
3. Перед написанием кода загрузи `_codestyle.md`.
4. При ошибках загрузи `_troubleshooting.md`.

## Справочники
- [Архитектура](_concepts.md)
- [Настройка окружения](_setup.md)
- [Стиль кода](_codestyle.md)
- [Команды сборки](_commands.md)
- [Безопасность](_security.md)
- [Глоссарий](_glossary.md)
3. Создайте тематические справочники.
Каждый файл с подчёркиванием в имени (_concepts.md, _setup.md, _codestyle.md) отвечает за свою область. Агент загружает их только когда задача попадает в соответствующую тему. Вот минимальный набор:
_concepts.md- архитектура, паттерны, поток данных_setup.md- как запустить проект локально_codestyle.md- линтеры, соглашения, заголовки лицензий_commands.md- команды сборки, тестирования, запуска_glossary.md- термины, специфичные для вашей предметной области_security.md- работа с секретами, отчёты об уязвимостях_troubleshooting.md- диагностика типичных проблем
4. Добавьте YAML-преамбулу в каждый файл.
Без неё агент не получит структурированных метаданных. Пример для _codestyle.md:
---
type: reference
title: "Code Style Guide"
description: "Linting rules, naming conventions, SPDX headers"
tags: [codestyle, linting, conventions]
timestamp: 2026-07-28
---

# Стиль кода

## Именование переменных
...
5. Создайте рабочие директории для процессов.
Для задач, которые появляются и уходят, заведите отдельные папки:
mkdir .opencode/issue .opencode/playbook .opencode/pr .opencode/archive
issue/- текущие задачиplaybook/- пошаговые сценарии для типовых операцийpr/- контекст для код-ревьюarchive/- завершённые задачи для истории
6. Добавьте индексный файл index.md.
Он играет роль оглавления всего набора знаний. По спецификации OKF v0.2 у этого файла нет frontmatter:
# Индекс набора знаний

- [Точка входа](AGENTS.md)
- [Архитектура](_concepts.md)
- [Настройка](_setup.md)
- [Стиль кода](_codestyle.md)
- [Команды](_commands.md)
- [Глоссарий](_glossary.md)
- [Безопасность](_security.md)
- [Решения](_decisions.md)
- [Лог изменений](log.md)
7. Проверьте результат: задайте агенту реальную задачу.
Откройте Opencode в каталоге проекта и попросите его выполнить что-нибудь конкретное, требующее знаний о проекте. Убедитесь, что агент обращается к справочникам, а не выдумывает ответ.
Стас Васильев описывает результат на своём проекте. До OKF-шаблона файл AGENTS.md разрастался до 500 строк, агент терял фокус и «понимал задачи по-своему». После перехода на набор знаний ядро сократилось до примерно 60 строк, а больше 25 тематических файлов подгружаются по мере надобности. Агент стал загружать только тот справочник, который нужен для текущей задачи, а не весь контекст. Идея progressive disclosure (постепенное раскрытие, когда агент движется по дереву знаний шаг за шагом, не загружая весь пакет в контекст) здесь работает буквально: меньше шума в контекстном окне, точнее ответ.
Раздутая точка входа. Если вы свалите всю документацию в AGENTS.md, вы вернётесь к исходной проблеме: агент получит 500 строк и начнёт путаться. Точка входа это маршрутизатор, не энциклопедия.
Пустой frontmatter или его отсутствие. Без полей type, title, tags агент не сможет программно определить, какой файл ему нужен. Заполняйте преамбулу даже если кажется, что «и так понятно».
Устаревшие знания без пометки. Если вы поменяли стек или API, но не обновили _concepts.md, агент будет генерировать код под старую архитектуру. Поле timestamp в преамбуле помогает, но только если вы его обновляете. В OKF v0.2 для этого есть поле Lifecycle, используйте его.
Попытка применить шаблон «как есть» к другому агенту. Шаблон Васильева заточен под Opencode. Если вы используете другого ИИ-агента, проверьте, как он находит и читает файлы: возможно, понадобится другое имя каталога или другой формат ссылок.
Что делать с этим прямо сейчас?
Авторам Дзена и копирайтерам. Принцип OKF работает не только в программировании. Если вы используете ИИ-агентов для генерации текста, заведите набор Markdown-файлов с вашим tone of voice, списком тем, глоссарием терминов, примерами хороших и плохих текстов. Подгружайте нужный файл к промпту (инструкции для модели) вместо того, чтобы каждый раз вставлять всё в одно сообщение.
Разработчикам в РФ. Шаблон Васильева открытый, на русском языке, не привязан к зарубежным платным сервисам. Opencode работает с разными моделями. Формат OKF сам по себе не зависит от провайдера: это просто файлы в git.
Маркетологам и предпринимателям. Если ваша команда уже использует ИИ-агентов в рабочих процессах, обратите внимание на саму идею: структурированные знания снижают расход токенов (единиц текста, за которые вы платите провайдеру модели) и уменьшают количество галлюцинаций. Это прямая экономия бюджета.
Мне нравится в этом подходе одна конкретная вещь: он дёшев в реализации. Никаких платформ, никаких баз данных, только текстовые файлы с понятной структурой. По моим наблюдениям, большинство проблем с ИИ-агентами на практике сводятся именно к контексту: модель не глупая, она просто не знает ваш проект. OKF предлагает формальный способ это исправить. Честная оговорка: сам формат вышел летом 2026 года, экосистема инструментов вокруг него ещё формируется, и пока нет публичных бенчмарков, показывающих, насколько именно OKF снижает процент галлюцинаций. Но идея progressive disclosure для контекста агента выглядит практически здравой, и попробовать её можно за полчаса.
Попробуйте промпт-конструктор dzen.guru
Соберите системный промпт для вашего ИИ-агента с учётом структуры знаний проекта
ПопробоватьСам факт того, что информация по проекту где-то структурированно записана, уже половина успехa. Начните с AGENTS.md на 60 строк и трёх справочников, остальное добавите, когда агент сам начнёт спрашивать.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Сэм Альтман о ИИ: взломы и мошенничество, допустимая цена за выгоды технологии
Почему это важно Глава OpenAI публично назвал взломы и мошенничество допустимой ценой за выгоды ИИ и противопоставил свою позицию подходу Anthropic,…
Selectel показала, как за 2 часа добавить LLM-ассистента в Wazuh SIEM
Компания Selectel опубликовала пошаговую инструкцию, которая позволяет за два часа добавить языковую модель в Wazuh SIEM и дать аналитикам безопасности…
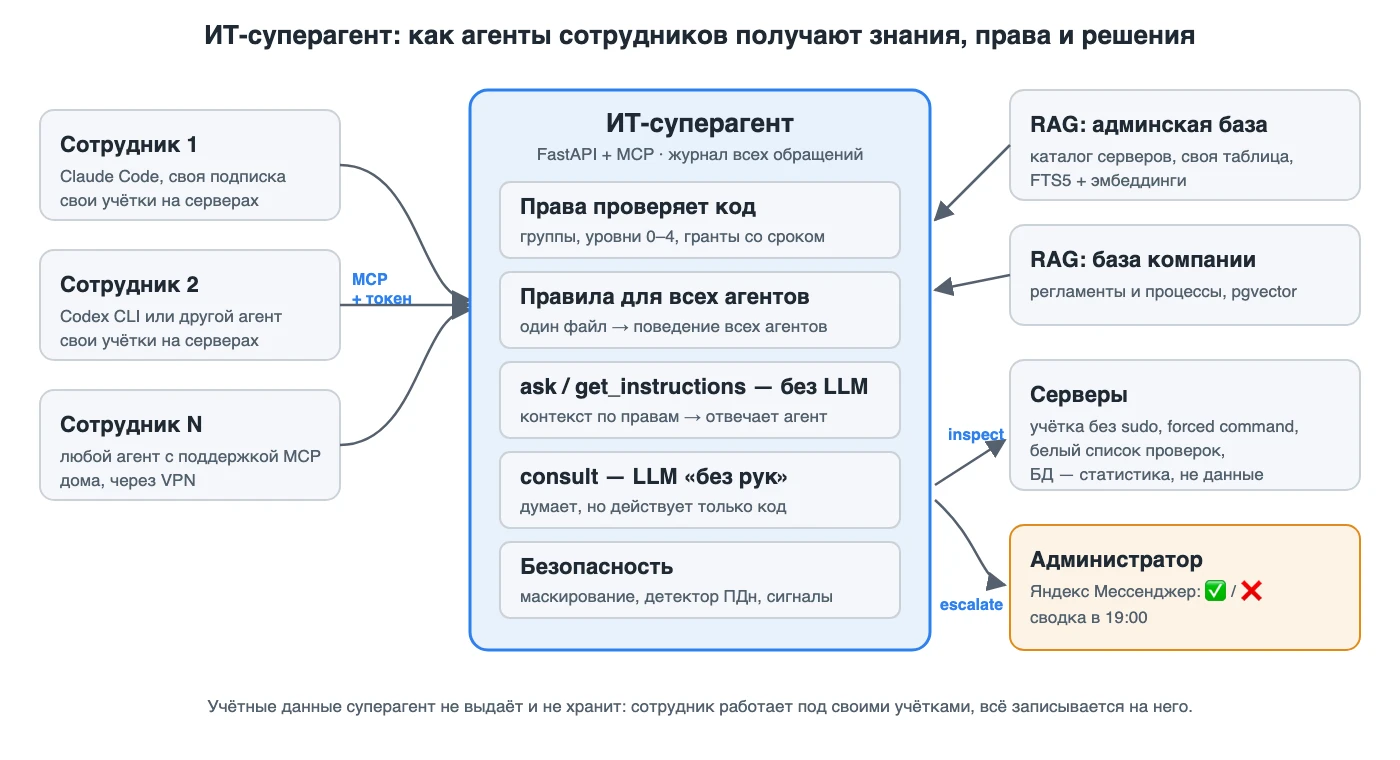
Что такое ИИ-агент на практике: как суперагент на MCP заменил ручную пересылку писем
Разработчики и администраторы уже раздали сотрудникам ИИ-агентов, но столкнулись с хаосом: агенты не знают, как устроена компания, у них нет нужных прав, а…
Комментарии