
Нейросети Liquid AI отвечают за 50 мс: Shopify уже заменяет классические алгоритмы
Почему это важно Впервые движок инференса (исполнения запросов к нейросети) обещает ответ генеративной модели быстрее 50 миллисекунд, это скорость, при которой…
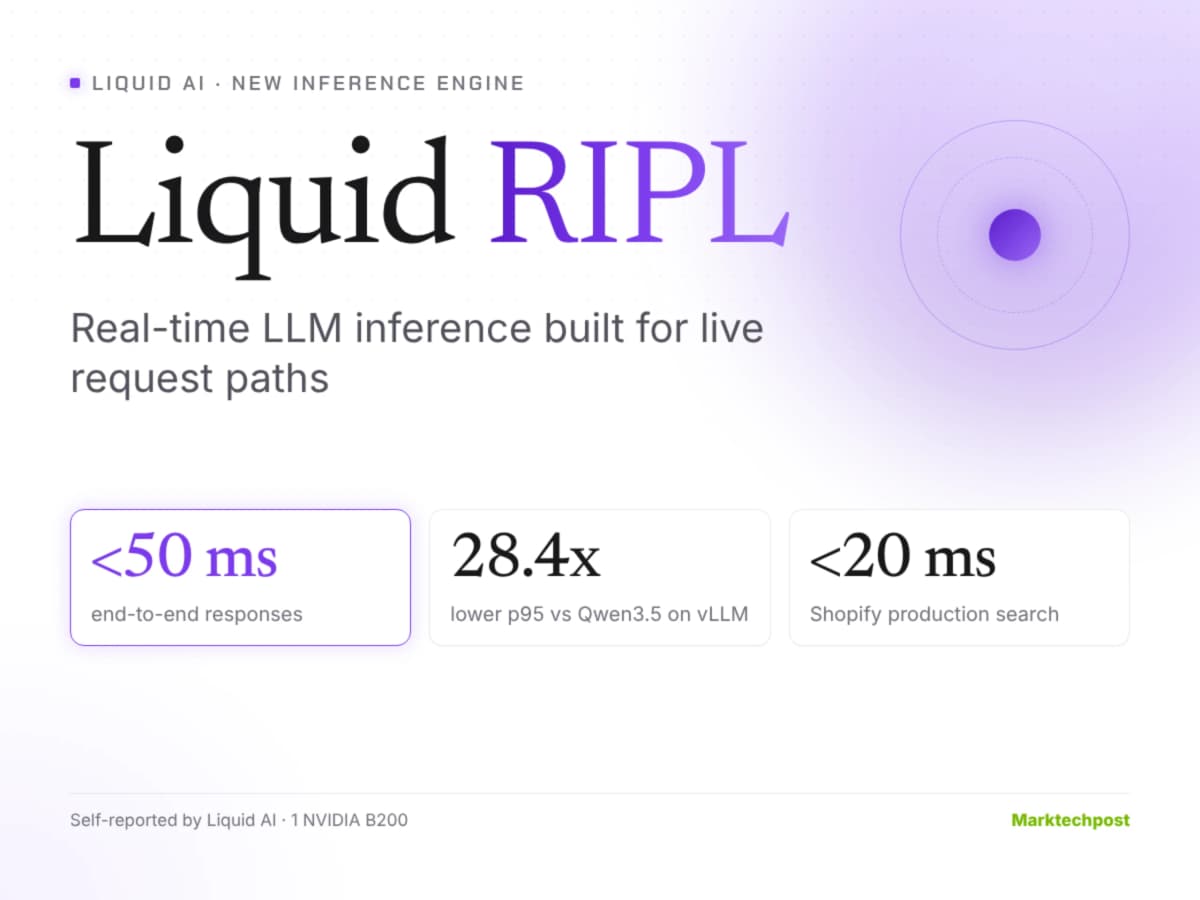
Впервые движок инференса (исполнения запросов к нейросети) обещает ответ генеративной модели быстрее 50 миллисекунд, это скорость, при которой нейросети могут заменить классические алгоритмы в платёжных проверках, поисковой выдаче и рекламных аукционах.
Liquid AI анонсировала RIPL (Real-time Inference Pipeline, конвейер инференса в реальном времени), движок для запуска собственных моделей LFM2.5 с задержкой менее 50 мс на коротких запросах, в момент, когда рынок ищет способы встроить нейросети в процессы, где до сих пор хватало только классического машинного обучения.
Источник новости, блог Liquid AI и обзор Marktechpost. Все приведённые цифры задержек, это собственные замеры компании, о чём Liquid AI заявляет открыто. Независимых подтверждений на момент публикации нет.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| RIPL, движок инференса для моделей LFM2.5 | Июнь 2025 (точную дату Liquid AI не назвала) | Liquid AI | Корпоративные контракты, публичную цену не раскрыли |
Что умеет RIPL и чем отличается от обычных серверов нейросетей?
- Скорость ниже 50 мс на коротких задачах. По собственным тестам Liquid AI, модель LFM2.5-1.2B показала задержку 155,8 мс на уровне p95 (95-й процентиль, то есть 95 запросов из 100 укладываются в это время) при входе 256 токенов (фрагментов текста) и выходе 128 токенов. Для сравнения: модель Qwen3.5-0.8B на движке vLLM показала 4 431 мс, разрыв в 28,4 раза.
- Работает под постоянной нагрузкой. Liquid AI утверждает, что задержка держится, даже когда запросы приходят непрерывно на пиковой нагрузке.
- Обслуживает модели от 230 млн до 2,6 млрд параметров. Линейка LFM2.5 компактнее большинства популярных нейросетей: по данным Liquid AI, модели используют примерно на 50 % меньше параметров, чем альтернативы, при сопоставимом качестве на целевых задачах.
- Гибридная архитектура моделей. LFM2.5-1.2B состоит из 16 слоёв: 10 блоков свёрточных операций с двойным гейтингом и 6 блоков GQA (grouped query attention, способ экономить память при обращении модели к контексту). Модель на 2,6 млрд параметров содержит 30 слоёв: 22 свёрточных и 8 GQA.
- Железо: серверные GPU NVIDIA. Тесты проводились на одном ускорителе B200. Поддерживаются также H100, H200 и RTX PRO 6000.
Где RIPL уже работает?
По заявлению Liquid AI, движок используется в продакшене у Shopify. Нейросети обрабатывают поисковые запросы покупателей с задержкой менее 20 мс. Liquid AI называет это «боевым» подтверждением того, что генеративные модели могут заменить градиентный бустинг (классический алгоритм машинного обучения, который сегодня стоит почти в каждом поисковом ранжировании и скоринге) без потери скорости.
Стоит оговориться: все цифры опубликованы самой Liquid AI, независимого аудита пока нет.
Шесть задач, на которые целится RIPL
Liquid AI описала конкретные сценарии с жёсткими лимитами по времени:
- Переписывание рекламных запросов (adtech): 32 токена на входе, 32 на выходе, бюджет 50 мс.
- Классификация поискового намерения: 128 токенов на входе, 1 на выходе, бюджет 20 мс.
- Переранжирование поисковой выдачи: 1 000 токенов на входе, 1 на выходе, бюджет 30 мс.
- Оценка платёжного риска: 512 на входе, 16 на выходе, бюджет 50 мс.
- Кредитное решение: 8 000 на входе, 64 на выходе, бюджет 150 мс.
- Генерация alt-текста для изображений: картинка 512×512 плюс 64 токена, 16 на выходе, бюджет 100 мс.
Все бюджеты заявлены как выполнимые на одном ускорителе B200.
Как попробовать?
- Перейдите на страницу анонса RIPL в блоге Liquid AI и изучите калькулятор задержек, он позволяет подставить свои параметры (длину входа и выхода) и увидеть расчётное время ответа.
- Ознакомьтесь с карточками моделей LFM2.5: они опубликованы на сайте Liquid AI с описанием архитектуры и ограничений.
- Для развёртывания потребуется корпоративный контракт, публичного API или открытых весов Liquid AI не предлагает.
Есть ли аналоги в России?
RIPL решает узкую задачу: быстрый инференс компактных моделей для встраивания в «горячий путь» запроса. В российской экосистеме прямого аналога нет.
YandexGPT и GigaChat работают через облачные API, но ориентированы на генерацию текста общего назначения с задержками, которые измеряются сотнями миллисекунд и выше. Для задач вроде поискового ранжирования или платёжного скоринга в России по-прежнему используют классическое машинное обучение (CatBoost, LightGBM).
Если Liquid AI подтвердит заявленные цифры независимыми тестами, это может подтолкнуть и российских разработчиков к экспериментам с компактными генеративными моделями вместо градиентного бустинга в «горячих» путях.
Что это значит для вас по ролям?
Автору на Дзене и копирайтеру. RIPL напрямую не влияет на создание контента: движок заточен под серверные задачи, а не под генерацию статей. Но сам тренд, нейросети становятся достаточно быстрыми, чтобы работать «внутри» поиска, означает, что поисковая выдача будет всё сильнее зависеть от ИИ-моделей. Следите за тем, как меняется ранжирование.
Маркетологу. Если вы работаете с рекламными аукционами или персонализацией в реальном времени, технология Liquid AI показывает направление: генеративные модели вместо rule-based логики, без потери скорости. Пока доступно только через корпоративный контракт и только за рубежом.
Разработчику и предпринимателю в РФ. Движок закрытый, серверы требуют GPU NVIDIA последних поколений, санкционные ограничения на поставку этих ускорителей в Россию делают прямое использование RIPL маловероятным. Альтернатива: следить за появлением аналогичных оптимизаций в открытых движках (vLLM, TensorRT-LLM) и тестировать компактные открытые модели на доступном железе.
Цифры выглядят впечатляюще, но я бы не спешил воспринимать их как истину: все замеры сделаны самой Liquid AI, на собственных моделях, на собственном движке. Сравнение с Qwen3.5 на vLLM, это сравнение «наша модель плюс наш движок» против «чужая модель на универсальном движке», то есть выигрыш складывается из двух факторов сразу, и разделить их сложно.
Что действительно ценно: Liquid AI показала, что компактные нейросети (до 2,6 млрд параметров) могут работать в «горячих» путях, где раньше стояли только деревья решений. Если независимые тесты подтвердят хотя бы половину заявленного разрыва, это изменит архитектуру поисковых и платёжных систем.
Для нашей аудитории в РФ практический совет один: не покупайте хайп, но запомните название. Когда открытые движки подтянутся по скорости, а компактные модели появятся с открытыми весами, именно задачи из списка RIPL (ранжирование, скоринг, классификация намерений) станут первыми кандидатами на замену классического ML нейросетями.
Частые вопросы
Можно ли использовать RIPL бесплатно или с открытым кодом?
Нет. RIPL и модели LFM2.5 распространяются только через корпоративные контракты. Открытых весов и публичного API Liquid AI не предлагает. Все компоненты, и движок, и модели, закрытые.
Правда ли, что нейросети RIPL отвечают быстрее 50 мс?
По собственным замерам Liquid AI, на коротких запросах (32 токена на входе и выходе) модель LFM2.5-350M укладывается в 50 мс. На длинных запросах (8 000 токенов на входе) бюджет 50 мс уже не выдерживается, задержка растёт до 150 мс и выше. Независимых подтверждений этих цифр пока нет.
Заменит ли RIPL ChatGPT или YandexGPT для обычных задач?
Нет. RIPL создан для серверных задач с жёсткими лимитами по времени: скоринг, ранжирование, классификация. Модели LFM2.5 компактны (до 2,6 млрд параметров) и не рассчитаны на развёрнутую генерацию текста, диалоги или написание статей, для этого по-прежнему нужны модели на порядки крупнее.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Canva выпустила свою нейросеть: модель учили на дизайнах, а не на фото
Canva выпустила собственную нейросеть для генерации изображений, обученную не на фотографиях, а на дизайнерских шаблонах, и сразу открыла доступ всем…
Что такое ИИ-агент без самоконтроля: AutoHarness запрещает пропускать подготовку
ИИ-агент (программа, которая сама решает, какие шаги предпринять для выполнения задачи) получает всё больше свободы: ищет информацию, ставит расширения, пишет…
Uber подключил ChatGPT для всех 30 000 сотрудников: 80% пилота составили не инженеры
ChatGPT Work, корпоративный ИИ-ассистент от OpenAI, перестал быть пилотным проектом в Uber: компания объявила 5 июня, что все 30 000 сотрудников по всему миру…
Комментарии