
Нейросеть webAI весом 5 ГБ решает математику на домашнем ПК, но не знает русского
Компания webAI выложила в открытый доступ рассуждающую модель TwIL-8B, чья сжатая версия работает даже на обычном процессоре, и сделала ставку на цену одной задачи, а не на размер.
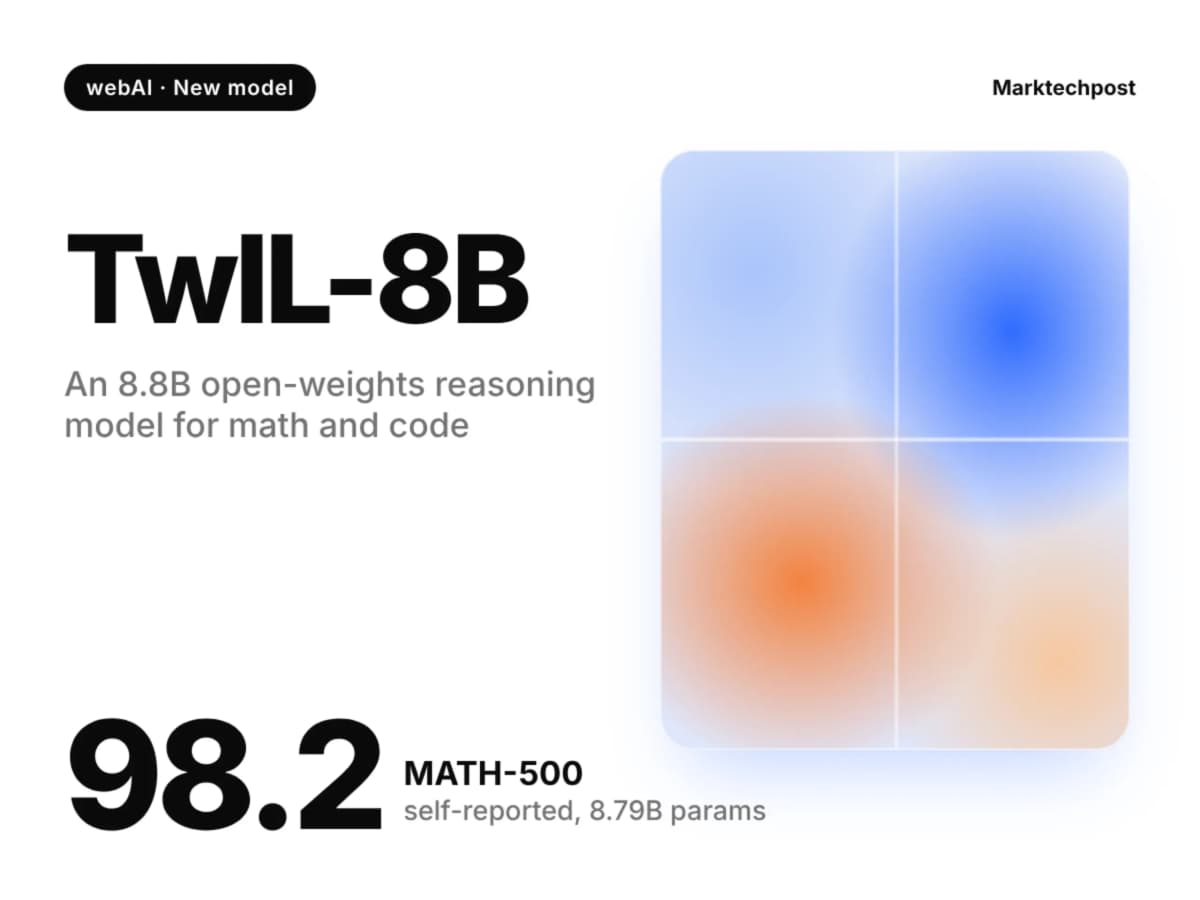
Модель с результатом 98,2 на математическом тесте MATH-500 можно запустить на домашнем компьютере без облачных расходов. Но писать по-русски она не умеет, а лицензия запрещает коммерческое использование.
Как пишет Marktechpost, webAI дообучила TwIL-8B на основе модели IBM Granite 4.2 8B. Свежая нейросеть рассчитана на математику, программный код и точное выполнение инструкций. Веса модели (её «мозги» в виде файла, который можно скачать) лежат на Hugging Face, крупнейшей площадке, где разработчики публикуют модели.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| TwIL-8B, рассуждающая модель на 8,79 млрд параметров | Точную дату релиза источник не указал | webAI | Открытые веса, лицензия только для некоммерческого использования |
Что нового в TwIL-8B?
Рассуждающая модель (reasoning model) перед ответом пишет черновик своих рассуждений, как школьник решает задачу на полях. TwIL-8B выводит такой черновик в отдельном блоке перед каждым ответом.
- Размер. 8,79 млрд параметров. Параметры похожи на внутренние настройки модели: чем их больше, тем она «умнее» и тем тяжелее для компьютера.
- Две версии. Balanced («сбалансированная») идёт по умолчанию и рассуждает короче. Verbose («подробная») думает дольше и нацелена на сложные олимпиадные задачи.
- Длинная память. Контекст 131 072 токена. Токен (token) означает кусочек слова, а контекст показывает, сколько текста модель держит в голове за один раз.
- Математика. 98,2 на MATH-500, лучший результат в сравнении webAI. У Qwen3.5-9B 96,6 по данным стороннего рейтинга.
- Код. 81,6 на тесте LiveCodeBench у подробной версии против 65,6 у Qwen3.5-9B и 80,0 у Gemma 4 31B.
- Инструкции. 74,4 на IFBench, на 9,9 пункта выше Qwen3.5-9B.
- Слабое место. Общие знания: на тесте GPQA Diamond 70,2 против 81,7 у Qwen3.5-9B и 84,3 у Gemma 4 31B.
- Экономия. На задачах AIME 2026 модель тратит около 19,5 тыс. токенов на задачу, а Qwen3.5-9B 31,2 тыс., то есть на 38% меньше. Балл при этом ниже на 4,2 пункта.
Все цифры webAI измерила сама. К результату по коду есть вопрос: версию LiveCodeBench компания не записала, хотя у конкурентов указана шестая. По 13 общим тестам счёт 7:6 в пользу TwIL-8B против Qwen3.5-9B и 3:11 против Gemma 4 31B, которая примерно в 3,5 раза больше.
Как попробовать модель дома?
- Найдите на Hugging Face репозиторий webAI-Official/TwIL-8B.
- Скачайте сжатую сборку Q4_K_M в формате GGUF. Это версия модели с упрощёнными числами внутри, она весит 4,98 ГиБ, чуть больше 5 привычных гигабайт. Полная версия занимает 16,38 ГиБ.
- Запустите файл через llama.cpp, бесплатную программу для работы с моделями на своём компьютере. Подойдёт процессор или видеокарта с небольшой памятью.
- Поставьте большой лимит длины ответа: в примере от webAI это 32 768 токенов. С коротким лимитом модель обрывает рассуждение и решает заметно хуже.
Готового онлайн-сервиса с этой моделью на Hugging Face пока нет, только скачивание.
Модель понимает и пишет только по-английски. Все результаты получены на полной версии, на сжатой ждите небольшого падения качества. Цифры webAI измерила сама, независимой проверки нет. Лицензия запрещает использовать модель для заработка.
Есть ли российская замена?
Из доступных в РФ аналогов это YandexGPT, нейросеть Яндекса, и GigaChat от Сбера. В сравнение webAI их не включала, поэтому цифр «кто сильнее» нет.
Разница в подходе в другом. TwIL-8B живёт у вас на компьютере и ничего не отправляет в облако, зато требует английского и некоторой возни с настройкой.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Для русских текстов модель не подходит. Её можно использовать как домашнего помощника для проверки расчётов и логики, если вы готовы задавать вопросы по-английски.
Маркетологу. webAI сравнивает модели не по размеру, а по числу токенов на задачу. Считайте так же свои расходы на ИИ: при оплате облачных сервисов за объём короткий ответ стоит дешевле.
Предпринимателю. Встроить TwIL-8B в продукт или клиентский сервис нельзя, лицензия некоммерческая. Для бизнес-задач на русском смотрите в сторону YandexGPT и GigaChat.
На мой взгляд, это честный релиз: webAI сама показывает, где модель проигрывает, и не прячет слабость по общим знаниям. Оговорка простая: для русскоязычного автора это игрушка для экспериментов, а не рабочий инструмент. По моим наблюдениям, для текстов на русском практичнее отечественные модели. Что сделать сегодня: если у вас есть свободные 5 гигабайт, скачайте сжатую версию и проверьте, как она решает ваши английские задачи. Так вы на практике поймёте, что умеет локальная нейросеть без интернета.
Что чаще всего спрашивают про TwIL-8B?
Это DeepSeek или нейросеть Яндекса?
Нет. TwIL-8B создала компания webAI на основе модели IBM Granite. К DeepSeek и Яндексу она отношения не имеет.
Умеет ли модель рисовать картинки и писать по-русски?
Нет. Она работает только с текстом и только на английском языке, изображения не создаёт.
Можно ли на ней зарабатывать?
Нет, лицензия разрешает только некоммерческое использование. Учиться, тестировать и сравнивать можно, продавать результат нельзя. Для заработка выбирайте сервис, где коммерческое использование прописано в условиях.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Airbnb пообещала ИИ-агента для путешествий в 2027 году: вместо чата экран с картами
Airbnb в письме акционерам по итогам третьего квартала 2026 года пообещала запустить в первой половине 2027-го ИИ-агента для планирования и бронирования…
Локальный L1-аналитик SOC: 0 ложных эскалаций на синтетике и 39 из 100 в реальном потоке
Автор открытого проекта kezekshi выложил локального ИИ-помощника для дежурных центра киберзащиты, который на синтетике не ошибался, а на 100 живых алертах зря…
Симулятор гидроразрыва пласта помогает добывать нефть, но точность прогноза не раскрыта
Отраслевой аналитик Антон Соколов разобрал по открытым материалам «КиберГРП» и «РН-ГРИД», российские симуляторы гидроразрыва, и показал, как инженер проверяет…
Комментарии