
Нейросеть Flux 3 учат на видео и звуке: одной красивой картинки модели уже мало
Выходцы из Stability AI, авторы Stable Diffusion и нейросети Flux, учат новую FLUX 3 сразу на картинках, видео и звуке, объясняя в подкасте, почему одной красивой картинки модели уже мало.
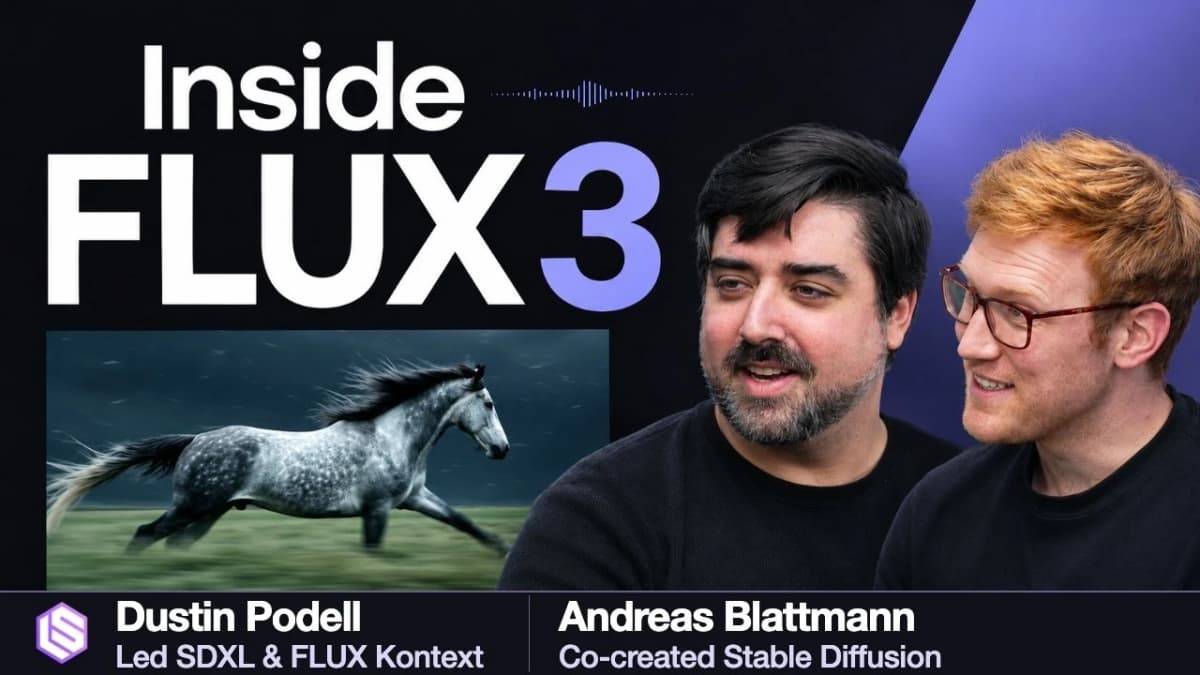
Модель для картинок теперь учат на движении и звуке. Значит, её проверяют не по одному удачному кадру, а по тому, сохраняет ли она лицо, свет и детали от кадра к кадру.
Разговор вышел в подкасте Latent Space. Гостями стали Андреас Блаттман, соавтор Stable Diffusion и метода латентной диффузии (способ генерации, при котором модель рисует не сразу пиксели, а их сжатое описание), и Дастин Поделл, который руководил проектом FLUX Kontext. После того как Stability AI развалилась, основная команда при помощи инвестора Анджа Мидхи ушла в собственную лабораторию BFL и выпустила серию моделей Flux.
Ведущий вспоминает, что когда-то сам ушёл в ИИ из-за Stable Diffusion. По его словам, Поделл тогда же уволился с основной работы. Главный вопрос выпуска: зачем лаборатории, известной картинками, понадобились видео и модели мира.
В чём суть: FLUX 3 учат на трёх сигналах одновременно
Блаттман объясняет идею на бытовом примере. Если вам бросают мяч, рука начинает двигаться раньше, чем мяч долетит, хотя траекторию на бумаге вы не рассчитаете. Такое знание он и называет визуальным интеллектом.
Каждый тип данных даёт модели свою часть этого знания:
- Неподвижный кадр показывает, где находится предмет.
- Видео показывает, как предмет туда попал.
- Звук удара сообщает, когда произошло касание, даже если камера его пропустила.
На этом BFL строит обучение FLUX 3: мультимодальная модель (та, что работает сразу с несколькими типами данных) получает все три сигнала вместе. В демо лаборатории видео и звук генерируются одновременно, и авторы подкаста советуют смотреть их со звуком.
Тем, кто ищет по запросу «flux нейросеть официальный сайт», нужна страница BFL. Там опубликованы обзор запуска FLUX 3, видеодемо и примеры FLUX Kontext.
Аргументы за: движение учит модель держать форму
Первый довод касается камеры. Допустим, камера стоит перед человеком и начинает его облетать. В какой-то момент модель обязана показать затылок. Блаттман считает, что в обычном плоском видео много сведений о том, как предметы выглядят с других сторон.
Второй довод инженерный. Если улучшать резкость каждого кадра ролика по отдельности, кадры по одному выглядят отлично. При воспроизведении детали мерцают, потому что апскейлер (программа, повышающая разрешение) каждый раз решает чуть по-разному. Поэтому видеоапскейлер BFL построен на той же базовой модели FLUX 3: согласованность во времени важна, даже когда пользователь просил лишь файл покрупнее.
Третий довод про редактирование. Поделл предположил, что модель, которая умеет нарисовать собаку в шляпе, уже знает, куда надевают шляпы. Вместе с коллегой он собрал небольшой набор фото с подписанными связями между предметами. Через несколько часов обучения модель научилась ставить логотип на футболку, и из этого эксперимента вырос FLUX Kontext.
Статичный кадр показывает, где находится мяч. Видео показывает, как он туда попал. : Ведущий подкаста Latent Space, пересказ аргумента Андреаса Блаттмана
Аргументы против: понимание физики никто не доказал
Ведущий сам оговаривается: видео не решает спор о том, «понимает ли модель физику». Собеседники возвращаются к этому вопросу несколько раз и к общему ответу не приходят. Облёт камеры даёт лишь более честный тест, чем оценка одного красивого кадра.
Есть и спор о методе. Авторегрессия (модель угадывает следующий кусок изображения по уже готовым, как текстовый чат угадывает следующее слово) учится сразу на всех токенах примера, то есть на всех мелких фрагментах данных. Диффузию команда умеет сжимать до нескольких шагов генерации. Блаттман признаёт за конкурирующим подходом его сильную сторону: выбор зависит от того, что вам дороже, обучение модели или ожидание картинки.
Наконец, первая версия Kontext была сырой. Ей хватило, чтобы показать идею команде, но потом ушли месяцы на данные и модель. Цены, сроки массового доступа и работу из России источник не обсуждает.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Самый жизненный сценарий из выпуска: люди восстанавливали через FLUX старые испорченные семейные фото и показывали их родным. Поделл признался, что такого применения не ожидал. Это готовая тема для рубрики «история семьи» и для обложек к личным материалам.
Маркетологу. Проверяйте генерации ролика по движению, а не по стоп-кадру. Мерцание логотипа или лица товара при воспроизведении убивает доверие к рекламе сильнее, чем мутная картинка.
Предпринимателю в РФ и СНГ. Доступность FLUX 3 в России источник не называет, поэтому до покупки проверьте вход и оплату на сайте BFL. Из доступных в РФ инструментов для картинок есть Шедеврум и Kandinsky.
На мой взгляд, ставка BFL на видео и звук логична: лицо, которое «плывёт» от кадра к кадру, сейчас главная беда генеративных роликов, и обучение на движении бьёт именно в неё. Оговорка: пока это аргументы самих разработчиков, а не независимые замеры. Что сделать сегодня: возьмите одно старое семейное фото и прогоните его через реставрацию в любой доступной вам нейросети. Сравните лицо с оригиналом и решите, узнают ли его родные. Узнают, значит, у вас есть материал для живой публикации.
Дальше спор уйдёт от картинок к действиям. В оглавлении выпуска есть главы про модели мира с действиями и про робототехнику в 2027 году. Думаю, через год модели будут сравнивать по тому, держат ли они человека и предмет при повороте камеры, а не по красоте одного кадра.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Import AI 481: ИИ-агенты учатся тратить деньги, разрыв с человеком сократился до 7,3 очка
Выпуск 481 рассылки Import AI собрал три работы, где ИИ-агенты действуют без человека-посредника: тратят деньги на самоулучшение, учатся заказывать опыты в…
Нейросеть сама не различает порядок слов: модели 2026 года решают это по-разному
Автор технического разбора на Substack выпустил отдельной статьёй объяснение механизма, по которому языковые модели различают порядок слов, как фундамент для…
Дженсен Хуанг уходит с поста главы NVIDIA после 33 лет: компанию временно ведёт финдиректор
NVIDIA объявила об уходе Дженсена Хуанга с постов генерального директора, президента и члена совета директоров после 33 лет руководства, накануне отчётности,…
Комментарии