
Нейросеть сама не различает порядок слов: модели 2026 года решают это по-разному
Автор технического разбора на Substack выпустил отдельной статьёй объяснение механизма, по которому языковые модели различают порядок слов, как фундамент для готовящегося обзора архитектур открытых моделей 2026 года.
Сама по себе нейросеть не знает, где в фразе стоит слово: «лису» в начале и в конце предложения она без подсказки описывает одними и теми же числами. Модели 2026 года добавляют эту подсказку в разных местах, а некоторые обходятся без неё. От этого выбора зависит их устройство.
Источник новости, большая техническая статья на платформе рассылок Substack. Она рассчитана на читателей книги Build a Large Language Model (From Scratch). Автор пишет, что читатели годами просили продолжение: после обучаемых абсолютных позиционных эмбеддингов, которые используются в GPT, разобрать RoPE.
В статье есть наглядные схемы, немного математики и небольшая реализация на PyTorch, популярной библиотеке для сборки нейросетей. Показательно, что текст вышел не самостоятельным материалом, а подготовкой к другому. Автор прямо говорит, что вынес тему отдельно, чтобы будущий обзор трендов не разросся.
В чём суть спора о порядке слов?
Путь текста через большую языковую модель (LLM, нейросеть, которая пишет текст, предсказывая следующее слово) автор описывает так:
- токенизатор режет текст на токены (кусочки текста, обычно слово или часть слова) и присваивает каждому номер;
- слой эмбеддингов переводит номер в набор чисел, своего рода анкету токена; автор называет эти числа признаками;
- трансформерные блоки меняют эти наборы с помощью внимания (attention, механизм, которым модель решает, на какие слова смотреть) и полносвязных слоёв;
- выходной слой выдаёт оценки, которые превращаются в вероятности следующего токена.
Для примера автор берёт две фразы: «Рыжая лиса прыгает через серую лису» и «Серая лиса прыгает через рыжую лису». Слова те же, но прыгает другая лиса. В первой фразе восемь позиций, от 0 до 7. Реальные словари моделей, по данным статьи, насчитывают от 50 до 200 тысяч записей.
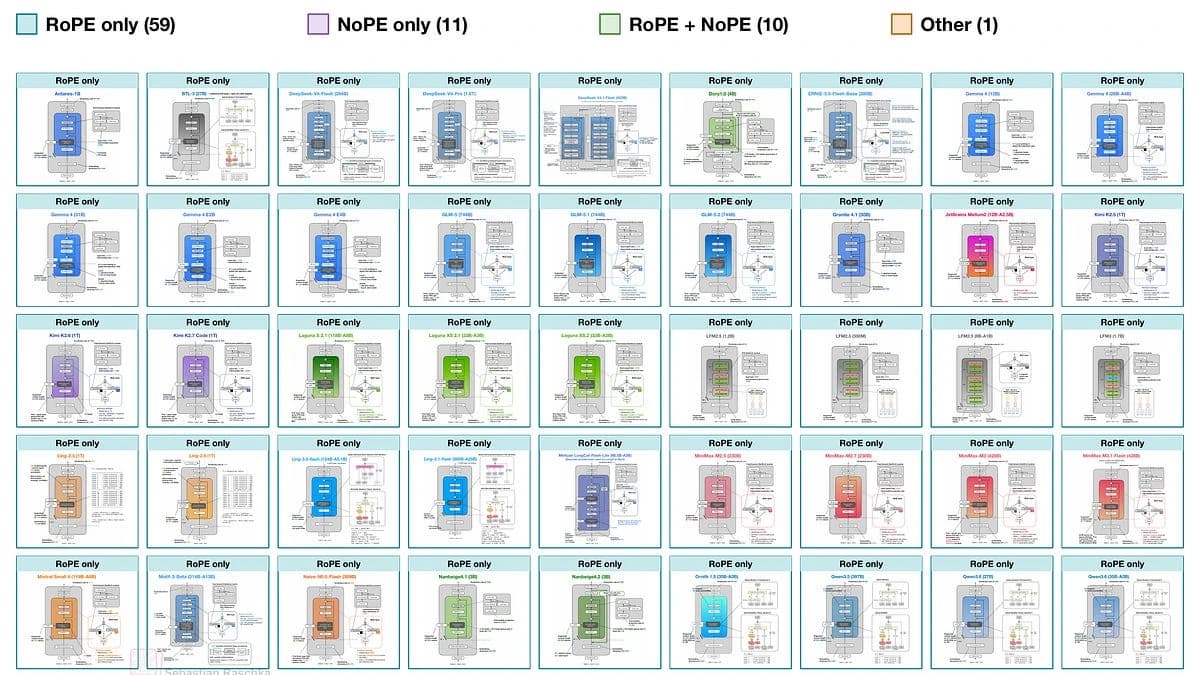
Сведения о позиции модели получают по-разному. GPT-2, относительно классическая модель, прибавляет к эмбеддингу каждого токена вектор позиции до входа в первый блок. MiniMax-M3, вышедшая в этом году, добавляет позицию в каждом блоке, внутри механизма внимания, способом под названием RoPE.
Аргументы за: без позиции модель не поймёт, какая лиса прыгнула
- Слово «лиса» в обеих позициях получает один и тот же номер (в примере автора это 2). Значит, слой эмбеддингов выдаёт для него одинаковый набор чисел, где бы слово ни стояло.
- Если убрать позиционное кодирование и маску, о которой ниже, перестановка слов «рыжая» и «серая» не меняет ни эмбеддинги, ни оценки внимания между парами токенов. Для модели две разные по смыслу фразы становятся одинаковыми.
- И классическая GPT-2, и свежая MiniMax-M3 сведения о позиции добавляют. Различается только место, где это происходит.
Аргументы против: порядок модель частично видит и без подсказки
Модели в стиле GPT используют каузальную маску. Это правило, по которому каждое слово «смотрит» только на себя и на слова перед ним, как читатель, который не заглядывает вперёд. По словам автора, такая маска сама даёт модели неявные сведения о порядке.
В примере с лисами слово «прыгает» в первой фразе видит перед собой «рыжую», а во второй «серую». Поэтому модель с такой маской, как пишет автор, теоретически различит эти фразы и без явных позиционных эмбеддингов. Он отдельно обещает разобрать, как современные архитектуры адаптируют явное позиционное кодирование или отказываются от него.
Есть и довод проще: сам автор называет эту часть модели «довольно второстепенным строительным блоком».
Статья очень техническая и, вероятно, для кого-то слишком подробная. Но мне хотелось, чтобы эта основа была доступна и на неё могли ссылаться будущие статьи. : Автор разбора на Substack
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Пример с лисами объясняет, почему в промпте важен порядок слов: «кто, что делает, с чем» в чёткой последовательности читается моделью однозначнее, чем перевёрнутая фраза. Проверьте это на своей задаче: поменяйте местами части промпта и сравните ответы.
Маркетологу. Когда подрядчик или вендор говорит про «новую архитектуру», спросите, чем модель отличается на деле. Различия между GPT-2 и MiniMax-M3 в схеме автора невелики, и громкое название не всегда означает другой результат.
Предпринимателю из РФ и СНГ. Разбор описывает открытые модели с открытыми весами (весами называют обученные параметры, которые можно скачать и запустить у себя). Для опытов без зарубежных сервисов из доступных в РФ вариантов есть YandexGPT и GigaChat. Какой способ кодирования позиции использует нейросеть Яндекс, статья не сообщает.
Текст рассчитан на тех, кто знаком с устройством моделей: автор сам предупреждает, что он слишком подробный для части читателей. Готовых советов по составлению промптов в нём нет, практические выводы выше сделаны редакцией.
На мой взгляд, автору Дзена не нужно разбираться в формулах RoPE, а вот пример с двумя лисами стоит запомнить. Он объясняет, почему нейросеть иногда путает, кто кого «перепрыгнул» в длинном и запутанном промпте. Оговорка: связь между устройством позиционного кодирования и качеством ответа на русском языке источник не измерял, это моя интерпретация. Что сделать сегодня: перепишите один рабочий промпт короткими фразами в прямом порядке, «подлежащее, сказуемое, дополнение», и сравните результат со старой версией.
Главное начнётся со следующего материала того же автора. Он обещал обзор архитектурных трендов открытых моделей 2026 года и таблицу того, какие из них добавляют сведения о позиции явно, а какие от этого отказываются. Если число отказавшихся окажется заметным, спор «за» и «против» перестанет быть учебным и станет вопросом о том, как будут устроены модели, которыми мы пользуемся.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Дженсен Хуанг уходит с поста главы NVIDIA после 33 лет: компанию временно ведёт финдиректор
NVIDIA объявила об уходе Дженсена Хуанга с постов генерального директора, президента и члена совета директоров после 33 лет руководства, накануне отчётности,…
ArtCraft скопировала Photoshop с помощью ИИ и хочет «перестроить всё»: 17 открытых программ
Основатель ArtCraft Брэндон Томас на конференции AI Engineer Code Summit призвал «перестроить всё» с помощью ИИ, когда его открытые копии Photoshop и других…
Glean, UiPath и Workday показали сценарии с Jev: модели первой системы выбирают, а не пишут
Инженеры Glean, UiPath и Workday на конференции AI Engineer Code Summit показали сценарии с Jev, моделью выбора без генерации текста, и меньше чем за два…
Комментарии