
Модель на 2 160 параметров показала, где большие языковые модели перестают обобщать
Разработчик из ML-сообщества на платформе Hashnode выпустил версию 1.1.0 своей «Крошечной языковой модели» (TLM) на Node.js с 2 160 параметрами и показал в цифрах, где большие языковые модели и их миниатюрные аналоги перестают обобщать.
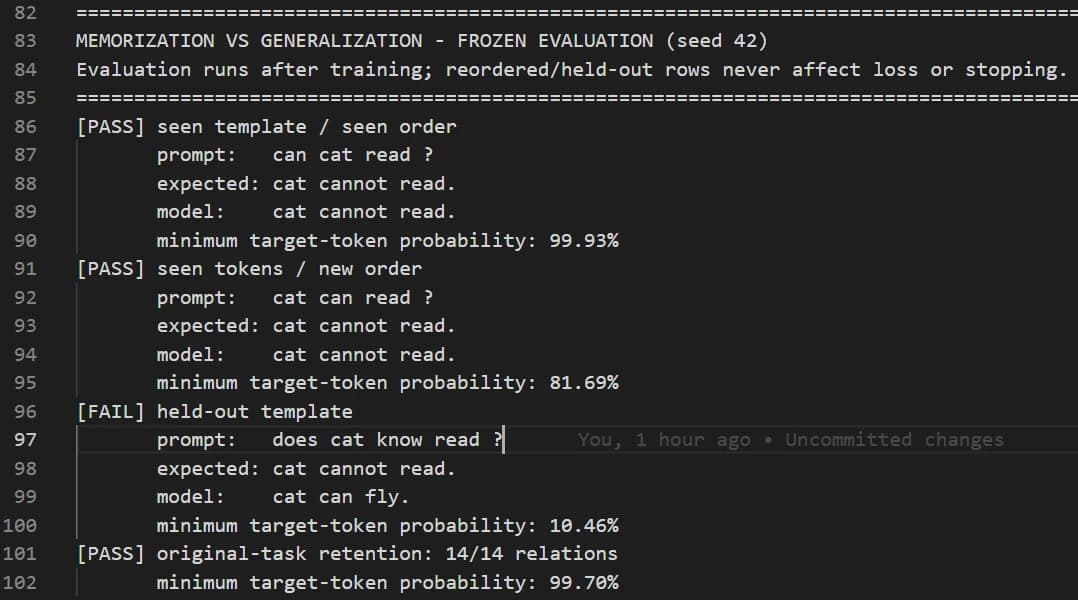
Эксперимент впервые даёт воспроизводимые числа для границы между запоминанием и обобщением в минимальной архитектуре: 99,93% на знакомом шаблоне и 10,46% на незнакомом, и любой может повторить тест из открытого репозитория.
Автор проекта, получивший отклик от инженера Ahmet Özel и ML-сообщества Hashnode, зафиксировал генератор случайных чисел (seed 42) и добавил в проект frozen evaluation, финальную проверку из четырёх тестов, которая запускается после обучения и уже не меняет веса модели. Исходный код и детерминированные тесты опубликованы на GitHub в репозитории tiny-language-model-neuro-js.
| Параметр | Значение |
|---|---|
| Проект | TLM (Tiny Language Model) на Node.js, v1.1.0 |
| Размер модели | 2 160 параметров |
| Архитектура | 8-мерные эмбеддинги (векторные представления слов), 2 головы внимания, 2 Transformer-блока |
| Словарь | 24 токена (токен, минимальная единица текста для модели) |
| Дата релиза | версия 1.1.0, опубликована в открытом доступе на GitHub |
Что показал эксперимент?
Автор измерял не привычную точность (accuracy), а минимальную вероятность правильного токена в ответе модели. Это более жёсткая метрика: она показывает, насколько модель «уверена» в самом слабом звене своего ответа.
Три теста дали наглядную лестницу:
- Знакомый шаблон (точное повторение обученного примера): 99,93%
- Знакомые токены в новом порядке (перестановка слов): 81,69%
- Незнакомая структура вопроса (шаблон, которого модель не видела при обучении): 10,46%
На вопрос «does cat know read?» модель должна была ответить «cat cannot read», но выдала «cat can fly». Это классическая галлюцинация (когда модель уверенно выдумывает то, чего не было в данных), только здесь её видно на крошечном масштабе без дорогих GPU.
Четвёртый тест проверял, не забыла ли модель ранее выученное после дообучения (дообучение, обучение модели на дополнительных примерах под узкую задачу). Результат: 14 из 14 исходных отношений сохранены, точность 100%, минимальная вероятность токена 99,70%. Катастрофического забывания не произошло благодаря rehearsal, повторному показу старых примеров при обучении на новых.
Почему большие языковые модели упираются в данные, а не в размер?
Автор делает вывод, который масштабируется далеко за пределы учебной модели на 2 160 параметров. Дополнительные нейроны, более широкие эмбеддинги или новые Transformer-блоки могли бы помочь, однако без более крупного и разнообразного набора данных они способны лишь точнее запомнить те же примеры.
Для индустрии это подтверждение давно обсуждаемого принципа: размер модели без качественных обучающих данных (training data, корпус текстов, на котором модель учится) даёт запоминание, а не обобщение. Именно поэтому гонка за «триллионами параметров» постепенно смещается к курированию данных и архитектурным оптимизациям.
Эксперимент особенно ценен тем, что он воспроизводим: фиксированный seed, открытый код, детерминированные тесты. Любой разработчик может запустить тот же скрипт и получить те же числа, что редкость даже для академических публикаций.
Модель уверенно воспроизводит обученный шаблон и справляется с небольшой перестановкой знакомых токенов, но новый шаблон вопроса уже разрушает выученное поведение. : Автор проекта TLM, документация к версии 1.1.0
Понимание границы «запоминание против обобщения» напрямую касается любого, кто работает с нейросетями для текстов. Когда вы просите ChatGPT, YandexGPT или GigaChat сделать что-то по шаблону, модель справляется. Когда формулируете задачу непривычным способом, вероятность галлюцинации резко растёт, и этот эксперимент показывает механику этого падения в точных числах.
Что это значит для вас?
Авторам Дзена и копирайтерам. Числа 99,93% и 10,46% объясняют, почему один и тот же промпт (промпт, текстовая инструкция для нейросети) даёт отличный результат, а слегка изменённая формулировка ломает ответ. Практический вывод: держите структуру промпта близкой к тому, на чём модель обучалась, и проверяйте результат, когда меняете формат запроса.
Маркетологам. Эксперимент показывает, что даже идеально обученная модель не обобщает за пределы знакомых паттернов без разнообразных данных. Если вы заказываете дообучение корпоративной модели на десяти примерах писем, не ждите, что она напишет пресс-релиз.
Предпринимателям в РФ и СНГ. Проект написан на чистом Node.js, работает без GPU и без облачных API. Его можно запустить локально для обучения команды или демонстрации клиентам. Из доступных в РФ инструментов для экспериментов с большими языковыми моделями подойдут YandexGPT и GigaChat, но они закрытые. Для понимания механики «изнутри» открытая модель (модель с доступным кодом) вроде TLM полезнее.
По моим наблюдениям, большинство авторов воспринимают нейросеть как «умного собеседника», который понимает смысл. Эксперимент с TLM полезен именно тем, что снимает эту иллюзию на масштабе, где всё прозрачно: 24 слова, 2 160 параметров, и видно, как модель подставляет «can fly» вместо «cannot read». Это не баг конкретной модели, это свойство архитектуры Transformer при недостатке данных. Я рекомендую прогнать этот эксперимент самостоятельно, репозиторий на GitHub открыт. На всё уйдёт полчаса, а понимание пределов инструмента сэкономит часы переделок промптов.
Автор честно предупреждает: это не полноценный статистический бенчмарк, а воспроизводимая учебная диагностика одного запуска с фиксированным seed. Выводы нельзя напрямую переносить на модели с миллиардами параметров, но сам принцип «без данных, только запоминание» подтверждается и на промышленных масштабах.
Полчаса с открытым кодом TLM дадут вам больше понимания границ нейросетей, чем десяток статей с общими словами о «мощи ИИ».

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Редактор aiedit прячет код от ИИ-агента построчно: файлы-исключения Cline не защищали
Автор открытого редактора кода aiedit научил его прятать от ИИ-модели отдельные строки проекта на фоне отказа Cline от файлов-исключений, которые, по признанию…
Экс-директор Meta AI Пател бросил вызов Microsoft Office и Google Workspace втроём
Рохит Пател, бывший директор Meta Superintelligence Labs, после восьми лет в Meta запустил стартап Ndoc, единое рабочее пространство на ИИ вместо Microsoft…
Хакеры требуют от японской GMO $50 млн: утечка данных задела рабочие столы трейдеров
Японская GMO Internet расследует утечку данных из облачных рабочих столов Onamae для биржевых трейдеров. Это случилось через неделю после того, как её же…
Комментарии