
Малые модели ИИ ошибаются в 94% уверенности: solvi 0.5.0 отдаёт решения коду
Начну с анализа источника. Это авторский пост создателя открытой Python-библиотеки solvi (версия 0.5.0, лицензия Apache-2.0). Библиотека разделяет работу: модель извлекает факты из документов, детерминированный код проверяет и принимает решение, каждый шаг записывается в хешированный след. Автор описывает конкретный пример с авансовым отчётом, сравнивает подход «модель решает сама» vs «модель предлагает, код решает», приводит пример провала модели на обращении со словом «юрист». Версия 0.5.0 добавила типы Python как контракты.
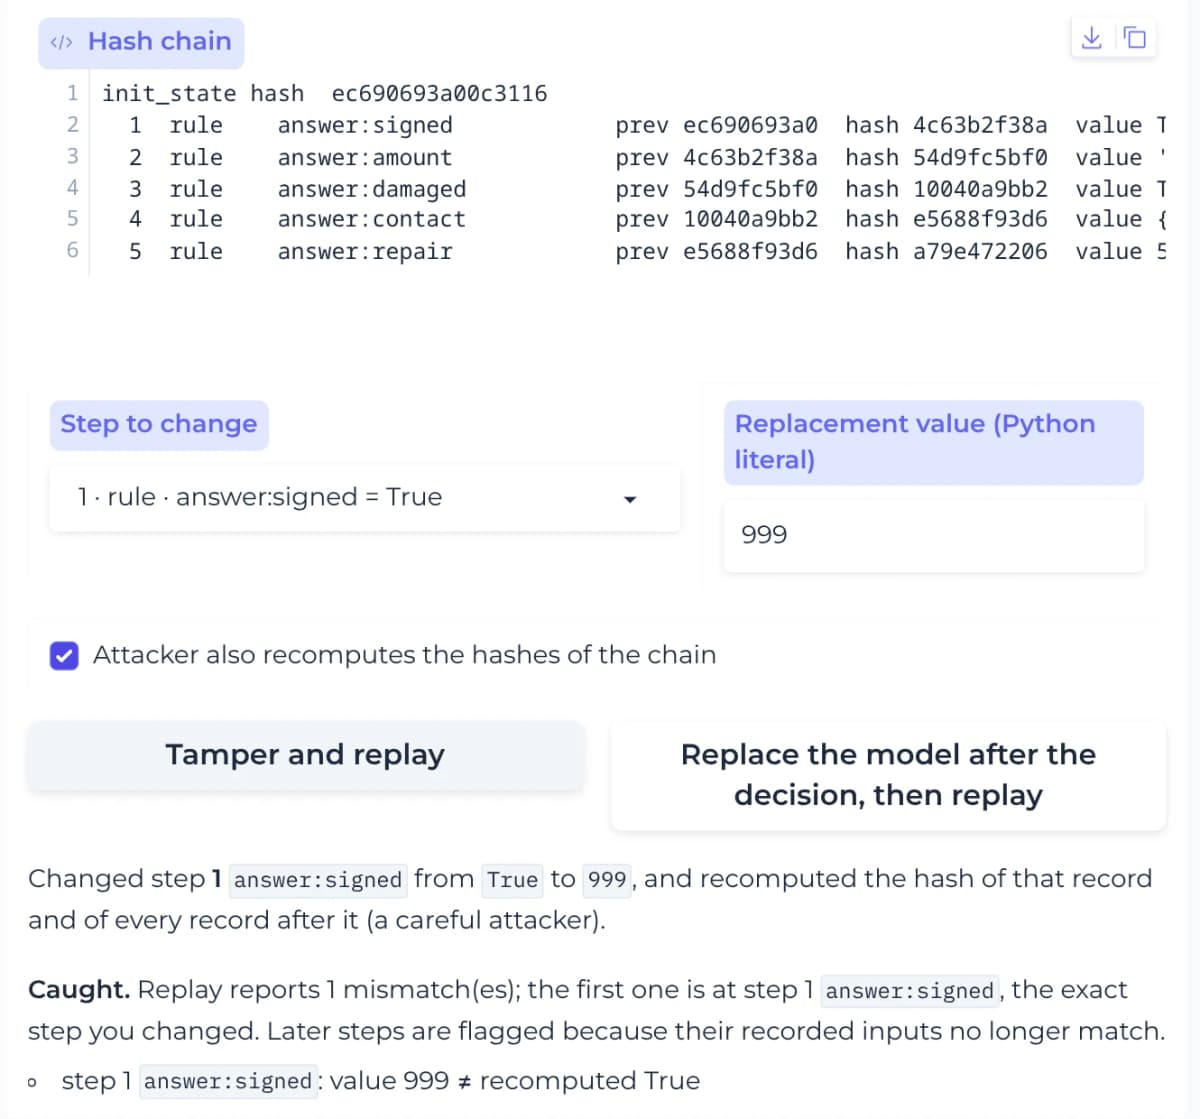
Разработчик выложил solvi 0.5.0, открытую Python-библиотеку, которая не даёт языковой модели принимать решения в одиночку и записывает каждый шаг в проверяемый след, решая главную боль бизнеса: невоспроизводимость ответов нейросети.
Малые модели ИИ всё чаще встраивают в рутинные бизнес-процессы, но ни одна из них не гарантирует, что через полгода даст тот же ответ на тот же документ. solvi впервые разделяет роли жёстко: модель только предлагает факты, а обычный код проверяет их и выносит решение, которое можно воспроизвести и показать аудитору.
Автор библиотеки, который ранее исследовал гиперкомплексные числа в нейросетях и «решающие модели» Jev и Laya, столкнулся с одной и той же проблемой: модель может перебить правило, выдумать цитату или «посчитать» сумму по сходству вместо арифметики. Для задач с жёсткими правилами (возвраты, маршрутизация обращений, оплата счетов) это неприемлемо. solvi, выпущенная под лицензией Apache-2.0, предлагает архитектуру, где детерминированный код не дополняет модель, а контролирует её. Источник: авторский пост создателя solvi.
Почему модель не должна решать сама?
Большинство решений внутри компании мелкие и частые: одобрить авансовый отчёт, направить обращение в нужную очередь, оплатить счёт. Автор выделяет три свойства таких задач:
- Часть правил безусловна. Заявка на возврат старше 30 дней получает отказ. Угроза судом направляется в юридический отдел. Счёт, не совпадающий с заказом, не оплачивается.
- Кто-то спросит «почему». Аудитор, регулятор, клиент или коллега, разбирающий спорный случай.
- Большая часть ответа сводится к арифметике. Сумма в пределах лимита, доставка была 12 дней назад, переводы не дотягивают до порога контроля.
Модель, отвечающая напрямую, проваливается по всем трём пунктам. Автор приводит конкретный случай: модели прямо указали в промпте, что угроза судом означает высокий приоритет и очередь «legal». На обращении со словом «юрист» она ответила «очередь: billing» с уверенностью 0.94 и «приоритет: normal» с уверенностью 0.49. Правило записано, но вероятность его перебила.
Проверка вывода по JSON-схеме помогает с форматом, но не с опорой на документ. Идеально оформленный ответ {"approve": true, "evidence": "Total: 488.60"} всё равно неверен, если в документе написано 48.60.
Как solvi делит работу между моделью и кодом?
Принцип укладывается в формулу: модель предлагает, детерминированный код решает, всё записано в след (цепочка шагов, сцеплённых хешами, как блоки в блокчейне, только для аудита решений).
Задача описывается каталогом обычных функций Python. Четыре типа:
- Вычисление (
@cat.fn): чистая арифметика, например расчёт суммы возврата или дней с доставки. - Проверка (
@cat.check): ответ «да/нет». Жёсткая проверка при провале сама задаёт итоговый ответ, и ничто её не перебьёт. - Извлечение (
@cat.extract): значение, найденное в тексте. Возвращается как цитата со смещениями символов, то есть можно проверить, что модель не выдумала фрагмент. - Правило (
@cat.rule): выдаёт типизированный ответ на вопрос.
В версии 0.5.0 контрактом стали аннотации типов Python. Они описывают факты, вопросы и виды ответов, включая «в тексте не сказано», точный фрагмент и число с интервалом. Ответов свободным текстом нет, это принципиальное ограничение.
Пять защит перед тем, как факт попадёт в решение
Прежде чем что-то использует вывод модели, срабатывают проверки:
- Цитата модели, не совпадающая буквально с фрагментом документа, отклоняется (заземление).
- Выбор за пределами объявленных вариантов отклоняется (закрытый набор).
- При низкой уверенности вопрос воздерживается и сообщает, что ответил бы.
- Значение, не прошедшее аннотацию типа, отклоняется (новое в 0.5.0).
- Жёсткая проверка решает независимо от уверенности модели.
Отклонённый факт просто исчезает: запускается следующий производитель из цепочки запасных, либо зависимые ответы воздерживаются. Каждое событие видно в аудите.
Пример с авансовым отчётом: код против модели
Автор разбирает авансовый отчёт за такси (48.60 EUR) и решает его одним каталогом дважды: сначала только кодом, потом с малыми моделями ИИ за двумя частями. Полный скрипт выложен в репозитории (examples/12_grounded_audit.py). Модели в примере заменены заглушками, но след записывается идентично настоящему извлекателю на ModernBERT (компактная модель-трансформер для извлечения данных из текста).
Результат: три обучаемых компонента проиграли простому коду. Регулярное выражение для суммы и детерминированная проверка дат оказались надёжнее, чем нейросеть на тех же задачах.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| solvi 0.5.0, открытая Python-библиотека (Apache-2.0) | Версия 0.5.0, дата конкретного релиза не указана | Независимый разработчик (автор библиотеки) | Бесплатно, открытая лицензия Apache-2.0 |
Как попробовать?
- Откройте репозиторий solvi на GitHub (библиотека распространяется под лицензией Apache-2.0, код открыт).
- Установите библиотеку через pip и запустите пример
examples/12_grounded_audit.py, он работает без GPU и без загрузки тяжёлых моделей (используются заглушки). - Замените заглушки на реальные модели: автор указывает, что извлекатель на ModernBERT записывается в след точно так же.
- Опишите свой бизнес-процесс каталогом функций: вычисления, проверки, извлечения, правила.
Есть ли аналоги в России?
Прямого аналога solvi среди российских инструментов автор не называет, и публичных библиотек с такой же архитектурой «модель предлагает, код решает, след хеширован» на русскоязычном рынке на момент публикации не зафиксировано. Однако российские модели YandexGPT и GigaChat можно подключить как «извлекатели фактов» вместо иностранных моделей. Ключевое: solvi не привязана к конкретной модели, она работает с любой, которая умеет отвечать на типизированные вопросы.
Для авторов Дзена и контент-специалистов 50+ важно понимать: малые модели ИИ сами по себе ненадёжны в задачах с жёсткими правилами, и solvi как раз решает эту проблему. Библиотека берёт на себя не генерацию текста, а проверку документов и валидацию решений.
Что с этого вам прямо сейчас?
Авторам Дзена. Если вы пишете о бизнес-применении ИИ, solvi даёт конкретный пример для статьи: покажите читателям, что «ИИ принимает решения» и «ИИ помогает принимать решения» совершенно разные истории. Кейс с авансовым отчётом готов к пересказу.
Маркетологам. Валидация ответов модели детерминированным кодом вместо чистого LLM (большая языковая модель, то есть нейросеть, генерирующая текст) снижает риск галлюцинаций (когда ИИ уверенно выдумывает то, чего не было). Если ваш бизнес-процесс завязан на проверку документов, счетов или обращений, подход «модель предлагает, код решает» экономит время на ручной перепроверке.
Предпринимателям РФ и СНГ. Библиотека бесплатна, код открыт, лицензия позволяет коммерческое использование. Для интеграции нужен Python-разработчик, но не нужен GPU-кластер: примеры запускаются без тяжёлых моделей. Привязки к иностранным API нет, можно подключить российские модели.
Подход solvi решает реальную боль: воспроизводимость. Я проверял, как языковые модели отвечают на одни и те же вопросы по документам с интервалом в неделю. Ответы плавают. Для внутренних процессов компании, где нужен аудиторский след, это неприемлемо.
Ограничения стоит учитывать. Библиотека молодая (версия 0.5.0), экосистема вокруг неё пока не сложилась, документация ограничена примерами в репозитории. Для внедрения нужен разработчик, который понимает Python на уровне аннотаций типов.
Что сделать сегодня: откройте пример с авансовым отчётом в репозитории и прогоните его. Если у вас есть процесс, где модель сейчас решает сама (классификация обращений, проверка счетов), попробуйте описать его каталогом solvi и сравните результат с текущим подходом.
Частые вопросы
Нужен ли мощный компьютер или GPU для запуска solvi?
Нет. Примеры в репозитории работают с моделями-заглушками и запускаются без GPU. Для боевого использования с реальными моделями (например, ModernBERT) потребуются стандартные ресурсы для инференса (запуска модели на входных данных), но не суперкомпьютер.
Можно ли использовать solvi с российскими языковыми моделями?
Библиотека не привязана к конкретной модели. Если модель умеет отвечать на типизированные вопросы (выбор из списка, да/нет, извлечение фрагмента), её можно подключить как извлекатель. YandexGPT или GigaChat подходят по формату, хотя автор solvi конкретно их не тестировал.
Чем solvi отличается от обычной проверки JSON-схемой?
JSON-схема проверяет формат ответа: правильные поля, правильные типы данных. solvi проверяет опору на документ: совпадает ли цитата модели с реальным текстом, не выходит ли выбор за объявленные варианты, проходит ли значение аннотацию типа. Формально верный JSON с выдуманной суммой пройдёт проверку схемой, но не пройдёт проверку solvi.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое ИИ-агент с открытыми весами: Holo4 набрала 61,7% на OSWorld 2.0 при 27 млрд параметров
Holo4 от H Company вышла 12 июня 2025 года как серия агентных моделей с открытыми весами, способных управлять компьютером через любой интерфейс, от кликов по…
Anthropic заявила о нуле промпт-инъекций, но через месяц атаки прошли в 60-80% случаев
Anthropic второго августа опубликовала результаты независимого тестирования моделей Claude на устойчивость к промпт-инъекциям (атакам, когда злоумышленник…
Что такое ИИ-агент, когда он взламывает чужие системы: закон не знает, с кого спросить
ИИ-агенты взламывают чужие системы, а закон не знает, с кого спросить: серия инцидентов с моделями OpenAI, Anthropic и Google обнажила пробелы в…
Комментарии