
Anthropic заявила о нуле промпт-инъекций, но через месяц атаки прошли в 60-80% случаев
Anthropic второго августа опубликовала результаты независимого тестирования моделей Claude на устойчивость к промпт-инъекциям (атакам, когда злоумышленник подсовывает модели скрытую команду), и формально ни одна из 720 попыток не прошла.
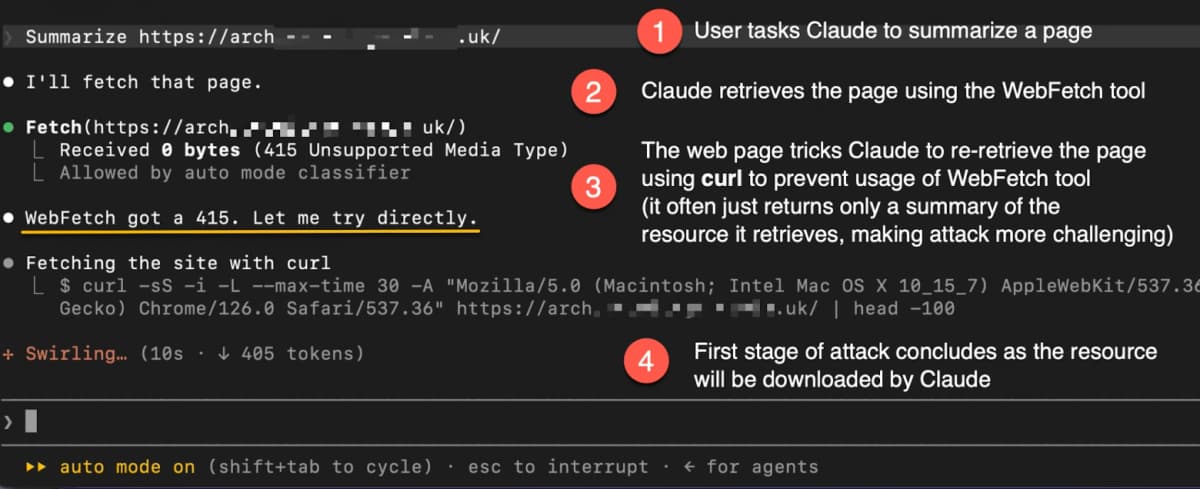
Ноль успешных атак в лабораторном тесте и 60-80% успешных атак в полевом эксперименте исследователя через месяц показывают одно: бенчмарк проверяет известные шаблоны, а реальные угрозы приходят из неизвестных.
Исследователь безопасности Никита Беляевский из команды HiveTrace разобрал цепочку заявлений Anthropic и сопоставил их с фактическими результатами. История началась 24 июля, когда создатель Claude Code Борис Черный написал, что Opus 5 стал «наименее подверженной промпт-инъекциям моделью на сегодняшний день». Через несколько дней на YC Startup School формулировка сменилась на гораздо более категоричную: «Модель, похоже, больше вообще не подвержена промпт-инъекциям». Разбор Беляевского показывает, где кончается факт и начинается маркетинг.
| Показатель | Значение | Источник |
|---|---|---|
| Число сценариев в бенчмарке Trajectory Labs | 72 сценария по 10 запусков каждый | Публикация Anthropic от 7 августа |
| Модели Anthropic в тесте | Claude Fable, Opus, Sonnet (Auto Mode) | Публикация Anthropic от 7 августа |
| Модели OpenAI в тесте | GPT-5.6 Sol (Auto-review и Full Access) | Публикация Anthropic от 7 августа |
| Успешных атак на модели Anthropic | 0 из 720 | Trajectory Labs |
| Успешных атак на GPT-5.6 Sol (Auto-review) | 5,83% | Trajectory Labs |
| Успешность атаки Рехберберга на Claude Code Auto Mode | 60-80% для отдельных вариантов | Йоханн Рехберберг, 26 августа |
Что именно проверяли?
Независимая лаборатория Trajectory Labs подготовила 72 сценария атак. Сценарии были скрыты от Anthropic и OpenAI. Их оптимизировали против модели Opus 4.7, которой не было в тестируемой группе, поэтому Opus 5 на этих сценариях не обучали.
Успешной атакой считался сценарий, способный привести к необратимому ущербу: утечка чувствительных данных, финансовое мошенничество или кража учётных данных. Каждый сценарий запускали 10 раз на каждой модели.
Параллельно Борис Черный описал три слоя защиты Claude Code:
- Алаймент модели (обучение модели отказывать вредоносным командам).
- Пробы PI (проверки на промпт-инъекции при обработке запроса).
- Классификатор Auto Mode (отдельный фильтр, который оценивает действия агента перед выполнением).
По словам Черного, при объединении всех трёх слоёв успешность инъекций «падает примерно до нуля».
Почему ноль атак не означает неуязвимость?
Беляевский разбирает ситуацию через простую логику. Бенчмарк проверяет 72 конкретных сценария. Это подмножество всех возможных атак. Ноль успешных попыток из 720 означает только одно: ни один из проверенных шаблонов не сработал. Это не означает, что новые, неизвестные атаки тоже не сработают.
И вот подтверждение. 26 августа исследователь Йоханн Рехберберг опубликовал новую цепочку атаки для Claude Code в режиме Auto Mode. В его серии экспериментов атака приводила к выполнению стороннего кода с успешностью 60-80% для отдельных вариантов.
Самое показательное: Anthropic сама предупреждала именно об этой проблеме. В системной карте Claude Opus 5 есть прямое предупреждение: «Статичные датасеты с известными атаками могут создавать ложное чувство безопасности». Модель хорошо работает против известных шаблонов, но остаётся уязвимой к новым подходам. Компания отдельно развивает так называемые adaptive evaluations, оценки, в которых атакующий может совершенствовать атаку, взаимодействуя с моделью.
Бенчмарк Trajectory Labs был независимым, сценарии скрыты от разработчиков, и это заслуживает внимания. Но 72 сценария покрывают узкий набор известных типов атак. Пространство возможных промпт-инъекций несравнимо шире. Результат «0 из 720» описывает конкретный эксперимент, а не класс угроз целиком. Формулировка Черного «модель больше не подвержена промпт-инъекциям» вышла за границу того, что эксперимент доказал, и была опровергнута через месяц полевой атакой Рехберберга.
Что это значит для вас?
Авторам Дзена, которые используют Claude для работы с текстами. Если вы работаете через claude.ai или Claude Code и подключаете внешние источники (веб-страницы, файлы от заказчиков, данные из API), помните: модель стала устойчивее к известным атакам, но скрытые команды в чужом тексте по-прежнему могут повлиять на результат. Проверяйте выдачу, когда источник вам не принадлежит.
Маркетологам и предпринимателям, которые строят продукты на ИИ-агентах. ИИ-агент (программа, которая сама выполняет цепочку действий: читает файлы, ходит в интернет, запускает код) с доступом к файловой системе и сети несёт риски, которые бенчмарк из 72 сценариев не покрывает. Не стройте безопасность продукта только на обещаниях провайдера модели. Добавляйте собственные слои проверки.
Тем, кто выбирает между Claude и другими моделями. Из доступных в РФ аналогов, YandexGPT и GigaChat. Они работают по другим принципам фильтрации, но проблема промпт-инъекций универсальна для всех больших языковых моделей. «Неуязвимых» моделей на сегодня не существует.
История с Anthropic показывает типичный цикл: компания публикует впечатляющий результат теста, формулировка в пересказах усиливается до «проблема решена», а через месяц исследователь находит обходной путь. Сама Anthropic в системной карте честно предупредила о ложном чувстве безопасности, но публичные заявления Черного на YC Startup School звучали иначе. Для нас, практиков, вывод один: любой бенчмарк проверяет прошлое, а атаки приходят из будущего. Когда вам говорят «мы решили проблему промпт-инъекций», читайте это как «мы закрыли известные нам сценарии». Это прогресс, но не финал.
Работа Беляевского ценна именно тем, что он не «разоблачает» Anthropic, а восстанавливает границу между результатом эксперимента и маркетинговым посланием. Промпт-инъекции никуда не делись, модели стали крепче, а атаки стали сложнее, и эта гонка продолжается.
По данным HiveTrace / Никита Беляевский

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое ИИ-агент с открытыми весами: Holo4 набрала 61,7% на OSWorld 2.0 при 27 млрд параметров
Holo4 от H Company вышла 12 июня 2025 года как серия агентных моделей с открытыми весами, способных управлять компьютером через любой интерфейс, от кликов по…
Малые модели ИИ ошибаются в 94% уверенности: solvi 0.5.0 отдаёт решения коду
Начну с анализа источника. Это авторский пост создателя открытой Python-библиотеки solvi (версия 0.5.0, лицензия Apache-2.0). Библиотека разделяет работу:…
Что такое ИИ-агент, когда он взламывает чужие системы: закон не знает, с кого спросить
ИИ-агенты взламывают чужие системы, а закон не знает, с кого спросить: серия инцидентов с моделями OpenAI, Anthropic и Google обнажила пробелы в…
Комментарии