
Лучшие нейросети сентября 2026: разрыв между лидерами сжался до нескольких баллов
Почему это важно Впервые за один месяц вышли сразу четыре флагмана от разных лабораторий, и китайские модели встали в ту же ценовую и качественную линейку, что…
Впервые за один месяц вышли сразу четыре флагмана от разных лабораторий, и китайские модели встали в ту же ценовую и качественную линейку, что и западные, а DeepSeek при этом отдаёт веса бесплатно.
В сентябре 2026 года рынок больших языковых моделей (LLM, программ, которые понимают и генерируют текст) получил сразу несколько флагманов: SpaceXAI выложила Grok 4.7, OpenAI выпустила GPT-6 Astra, Anthropic обновила линейку Claude Opus 5 и Claude Fable 5.1, а китайские лаборатории добавили Qwen3.8 Max, Kimi K3, GLM-5.3 и DeepSeek V4.
Агрегатор Artificial Analysis, который гоняет все модели в одной обвязке по десяти направлениям, зафиксировал разрыв между лидером (Astra) и остальными всего в несколько баллов. Для тех, кто ищет лучшие нейросети 2025 года и дальше, это означает: выбирать модель «по имени» больше нельзя, нужно смотреть на задачу и цену.
| Что | Когда | Кто выпустил | Цена (вход / выход за 1 млн токенов) |
|---|---|---|---|
| Grok 4.7 | 21 сентября 2026 | SpaceXAI (xAI) | $2 / $6 |
| GPT-6 Astra | 3 сентября 2026 | OpenAI | стандарт + $20/$75 при входе длиннее 272 тыс. токенов |
| Claude Opus 5 | 24 июля 2026 | Anthropic | $5 / $25 |
| Claude Fable 5.1 | 1 сентября 2026 | Anthropic | $10 / $50 |
| Qwen3.8 Max | снимок 2 сентября 2026 | Alibaba | $2 / $6 |
| Kimi K3 | сентябрь 2026 | Moonshot | тариф в консоли Moonshot, не в долларовой сетке |
| DeepSeek V4 Flash | сентябрь 2026 | DeepSeek | вдвое дешевле в ночное время и выходные |
Что изменилось в этом поколении?
-
Контексты выросли до миллиона токенов (токен, это примерно три четверти слова). GPT-6 Astra берёт на вход 1,05 млн токенов, Claude Opus 5 и Fable 5.1 по миллиону, DeepSeek V4 Flash тоже миллион. Grok 4.7 пока 500 тысяч.
-
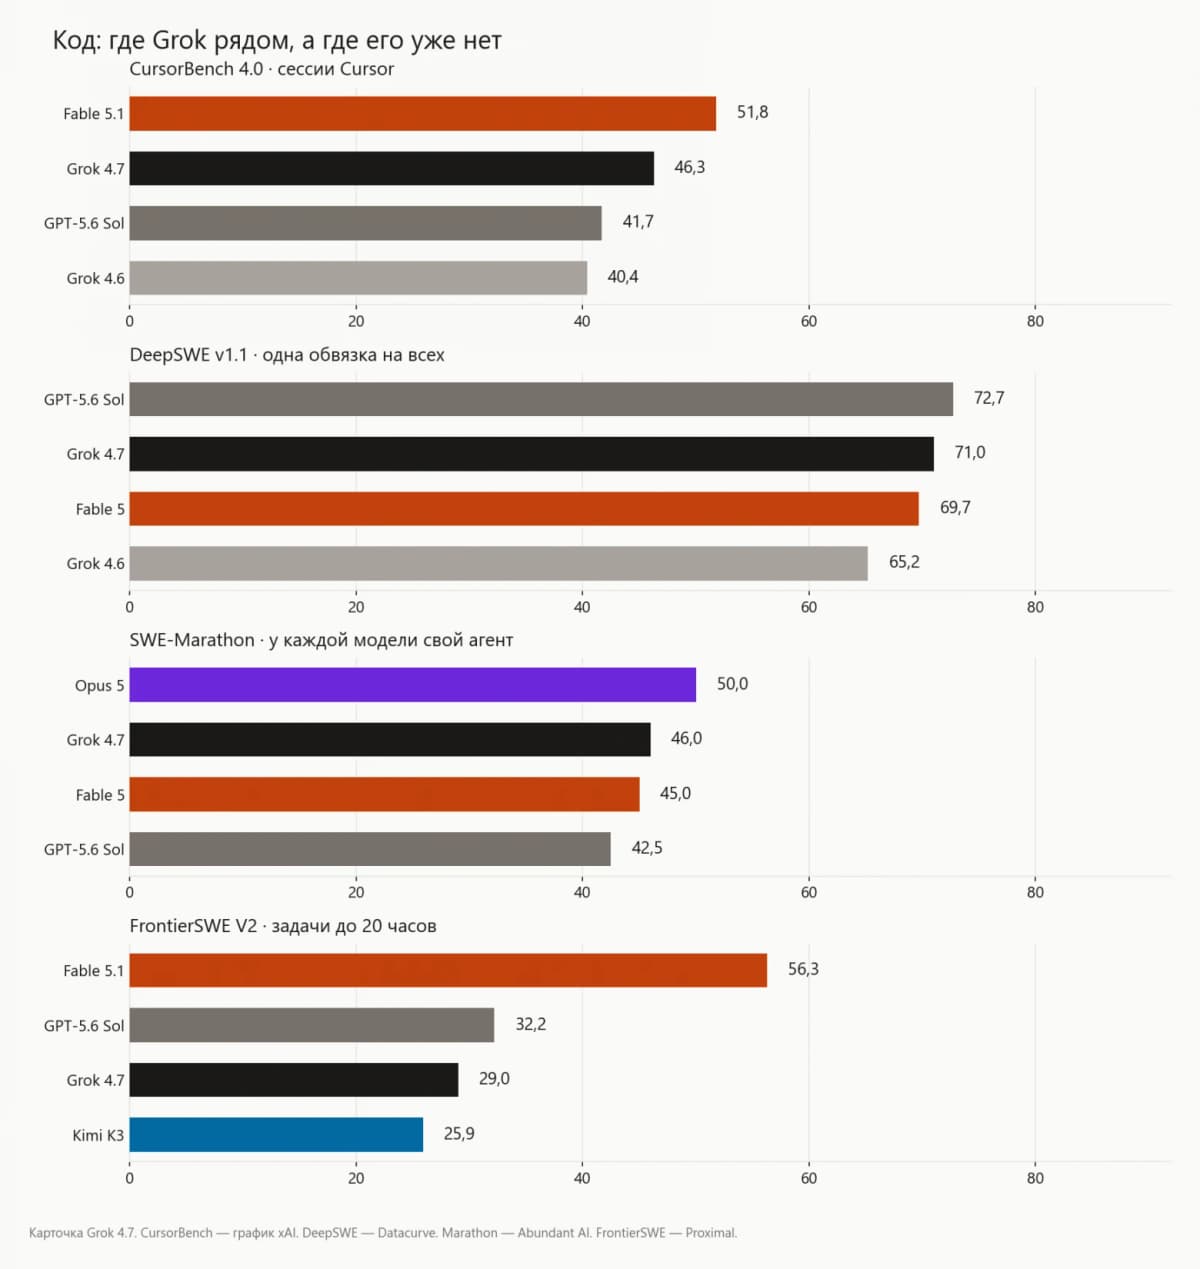
Grok 4.7 учили на реальных сессиях программистов. SpaceXAI прямо указала в карточке модели: для кода Grok дополнительно тренировали на обезличенных траекториях из редактора Cursor. Это значит, что результаты Grok на бенчмарке CursorBench нельзя считать «экзаменом на незнакомом материале».
-
GPT-6 Astra получила статус Critical по кибервозможностям. OpenAI первой среди своих моделей присвоила Astra такой уровень и усилила проверки на действия без явного разрешения пользователя.
-
Claude Fable 5.1 всегда «думает». Рассуждающий режим (когда модель проговаривает шаги перед ответом) включён постоянно, глубину регулируют параметром effort. Сама Anthropic рекомендует: Opus 5 для большинства задач, Fable подключать, когда Opus не справляется с вашими конкретными замерами.
-
Китайские модели вышли на тот же уровень цен и качества. Qwen3.8 Max стоит ровно столько же, сколько Grok ($2/$6), и отстаёт от него на общем индексе Artificial Analysis всего на один балл. Kimi K3 на суточных инженерных задачах показывает результат в том же коридоре, что и Grok.
-
DeepSeek V4 Flash: 284 млрд параметров, 13 млрд активных, лицензия MIT. Это открытые веса (open weights, модель можно скачать и запустить у себя), контекст миллион токенов, выход до 384 тысяч. Среди лучших нейросетей с открытым доступом к весам Flash занимает одну из верхних строк.
Бенчмарки расходятся вдвое: кому верить?
На индексе Artificial Analysis v4.3.2 GPT-6 Astra лидирует. Между Astra и Grok 4.7 семь баллов. По словам аналитиков Artificial Analysis, на этом индексе такой разрыв отделяет флагман от крепкого второго ряда.
Но Astra и Fable 5.1 набирают одинаковые 53 балла, и эта «ничья» обманчива. Astra сильнее на задачах в терминале и автоматизации интерфейсов. Fable впереди на офисных делах (AA-Briefcase), профессиональных задачах (GDPval), научном коде (SciCode) и экзамене Humanity's Last Exam.
Terminal-Bench 4.0, 66 тяжёлых сценариев в реальном терминале с бюджетом до восьми часов, показал разброс, который трудно объяснить «погрешностью». Grok 4.7 в собственной обвязке Grok Build набирает 38 %. В обвязке Artificial Analysis те же веса получают 26 %, и даже DeepSeek Flash оказывается на процент выше. При этом GPT-6 Astra на том же бенчмарке Artificial Analysis набирает около 60 %, Fable около 55 %.
Прогресс самого Grok при этом реален: у предыдущей версии 4.6 было 20,3 % в той же карточке.
Как попробовать?
-
Grok 4.7 доступен через API xAI, в редакторе Cursor на всех тарифах, в Grok Build как модель по умолчанию, в надстройках Word, PowerPoint и Excel, а также через OpenRouter, Vercel и Cloudflare. В обычный чат Grok и в X модель обещают позже.
-
GPT-6 Astra работает через API OpenAI. Учитывайте: при длине входа больше 272 тысяч токенов цена вырастает до $20/$75.
-
Claude Opus 5 и Fable 5.1 доступны через API Anthropic. Для Fable глубину рассуждений регулируйте параметром effort.
-
DeepSeek V4 Flash можно скачать (лицензия MIT) и запустить локально, если есть подходящее железо, или использовать через API DeepSeek.
Китайские модели и доступные в России аналоги
Для авторов и предпринимателей из России и СНГ ситуация двоякая. Западные API (OpenAI, Anthropic, xAI) требуют обходных путей для оплаты. Китайские модели доступнее: DeepSeek можно скачать бесплатно, Qwen и Kimi имеют свои консоли.
Из российских аналогов работают YandexGPT и GigaChat от Сбера. По моим наблюдениям, они пока не дотягивают до уровня флагманов из этой таблицы по длине контекста и кодовым задачам, но для текстовых задач на русском языке (посты, письма, сценарии) остаются самым простым вариантом без VPN и иностранных карт.
| Критерий | Западные и китайские флагманы | YandexGPT / GigaChat |
|---|---|---|
| Доступность в РФ без VPN | ограничена (кроме DeepSeek и китайских) | полная |
| Оплата рублями | нет | да |
| Контекст | 500 тыс. и 1 млн токенов | значительно меньше |
| Открытые веса | DeepSeek V4 Flash (MIT), GLM-5.3 Flash | нет |
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Если вы используете нейросеть для черновиков, попробуйте DeepSeek V4 или Qwen3.8 Max: качество на уровне западных флагманов, а стоимость ниже. Для русского языка по-прежнему удобнее YandexGPT, дополнительная настройка не нужна.
Маркетологу. Fable 5.1 сильнее на офисных и профессиональных задачах (брифы, аналитика, юридические тексты). Astra лучше для автоматизации интерфейсов и терминальной работы. Выбирайте по задаче, а не по рейтингу.
Предпринимателю в РФ и СНГ. DeepSeek V4 Flash с лицензией MIT можно развернуть на своём сервере и не зависеть ни от санкций, ни от курса доллара. Это реальная альтернатива закрытым API для компаний, которым важно хранить данные внутри периметра.
Я тестирую каждое поколение моделей с 2023 года, и впервые не могу назвать одного победителя. Astra формально лидирует по сводному индексу, но Fable обходит её на половине подтестов. Grok растёт быстро, однако его результаты на чужой обвязке вдвое ниже, чем на своей, и это повод для осторожности, а не восторга.
Главная новость сентября для меня не в западных флагманах, а в китайском ряду. Qwen3.8 Max за те же $2/$6 отстаёт от Grok на один балл. DeepSeek V4 Flash с открытыми весами и лицензией MIT позволяет запустить модель у себя. Для российских пользователей это снимает вопрос «а что, если API отключат».
Оговорка: все бенчмарки чувствительны к обвязке агента. Разница между 38 % и 26 % у Grok на одном и том же Terminal-Bench это доказывает. Не доверяйте одной таблице, проверяйте на своих задачах.
Что сделать сегодня: возьмите три свои типичные рабочие задачи (черновик поста, таблица, письмо клиенту) и прогоните их через DeepSeek V4 и через ту модель, которой пользуетесь сейчас. Сравните результат и стоимость. Это займёт полчаса и покажет больше, чем любой рейтинг лучших нейросетей.
Частые вопросы
Какая модель лучше для текстов на русском языке?
Среди флагманов сентября 2026 года ни одна модель не заточена специально под русский язык. Для текстовых задач на русском проще всего использовать YandexGPT или GigaChat. Если нужен уровень западных флагманов, попробуйте DeepSeek V4 или Qwen3.8 Max: они понимают русский, хотя основной фокус разработчиков на английском и китайском.
Можно ли доверять бенчмаркам при выборе модели?
Осторожно. Artificial Analysis гоняет все модели в одной обвязке, и это честнее, чем цифры из карточек самих лабораторий. Но даже у Artificial Analysis результаты Terminal-Bench для Grok 4.7 расходятся с данными xAI почти вдвое. Лучший бенчмарк, ваша собственная задача: прогоните черновик, таблицу или код через две-три модели и сравните результат.
DeepSeek V4 Flash правда бесплатный?
Веса модели можно скачать бесплатно, лицензия MIT разрешает коммерческое использование. Но для запуска нужно серверное оборудование с достаточным объёмом видеопамяти. Если своего железа нет, DeepSeek предлагает API, стоимость зависит от времени суток: в будни дороже, ночью и в выходные вдвое дешевле.
Сентябрь 2026 года показал, что гонка моделей перестала быть соревнованием двух-трёх американских лабораторий. Китайские команды стоят в той же таблице, по тем же ценам, а DeepSeek ещё и отдаёт веса. Для тех, кто работает в России, это не абстрактная конкуренция, а конкретный выбор: скачать модель, развернуть у себя и не зависеть ни от чьего API.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Meta Muse AI набрала до 4,3 млн загрузок за две недели, обогнав темпы ChatGPT
Meta вложила рекламные бюджеты уровня топ-10 брендов в продвижение своего ИИ-приложения Muse, которое за две с половиной недели после запуска 8 сентября…
Искусственный интеллект в медицине обошёлся в $942 млн: ИИ завышает диагнозы ради страховых выплат
Ассоциация Blue Cross Blue Shield (крупнейшее объединение медицинских страховщиков в США) подсчитала, что использование искусственного интеллекта в медицине…
Аугментация данных в AugLy от Meta: как за вечер проверить устойчивость модели к Unicode-атакам
Аугментация данных (искусственное расширение обучающей выборки за счёт модификаций исходных примеров) для мультимодальных моделей (работающих одновременно с…
Комментарии