
Локальные нейросети за 7 500 ₽: энтузиаст собрал ИИ-сервер из б/у железа
Microsoft и OpenAI здесь ни при чём: энтузиаст из России собрал ИИ-сервер на б/у комплектующих за копейки и выложил подробный отчёт, как всё повторить.
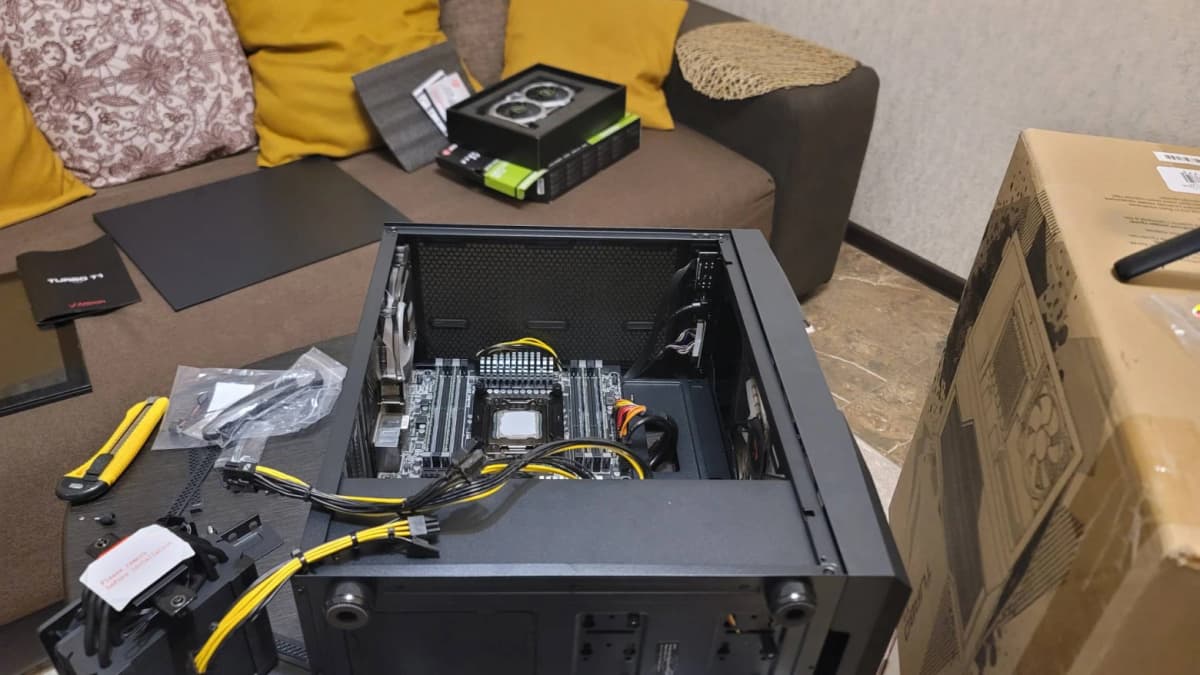
Локальные нейросети перестают быть привилегией владельцев дорогих видеокарт: две GTX 1660 Super с вторички, старая серверная плата и бесплатный софт дают рабочий текстовый ИИ на русском языке без подписок и без отправки данных на чужие серверы.
Русскоязычный разработчик опубликовал пошаговый отчёт о сборке домашнего ИИ-сервера на бюджетном, частично устаревшем железе. Проект интересен не мощностью, а воспроизводимостью: каждый компонент можно найти на российских досках объявлений, а весь софт бесплатный и открытый. Для аудитории, которая слышала про локальные нейросети, но считала, что для запуска нужна видеокарта за сто тысяч, это наглядное опровержение.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Домашний ИИ-сервер на двух GTX 1660 Super с моделью Qwen 2.5 7B | Дата публикации не указана | Независимый разработчик (автор проекта INFERNUM) | Около 7 500 ₽ за плату с процессором плюс стоимость второй видеокарты на вторичке |
Что удалось запустить на старом железе?
-
Две бюджетные видеокарты вместо одной дорогой. Автор объединил две Nvidia GTX 1660 Super (по 6 ГБ видеопамяти каждая, итого 12 ГБ VRAM). VRAM (видеопамять) напрямую определяет, какого размера модель поместится в карту. Утилита Ollama (бесплатный инструмент для запуска локальных нейросетей) сама разделила модель между картами поровну, по 4,5 ГБ на каждую, без ручной настройки.
-
Серверная плата с барахолки за 7 500 рублей. Gigabyte GA-X79-UP4 на сокете LGA2011 с процессором Intel Core i7-3930k (6 ядер, 12 потоков). Платформа старая, поддерживает только DDR3, но для задачи это не критично: вся работа модели идёт в видеопамяти, а не в оперативной.
-
Модель Qwen 2.5 7B для русского языка. Автор выбрал именно эту открытую модель, потому что она, по его словам, хорошо обучена русскому и помещается в 12 ГБ видеопамяти с запасом под контекст.
-
Режим работы на полной скорости шины. После перестановки карт местами обе заработали в режиме PCIe Gen3 x16. В простое карты сбрасывают частоту шины до Gen1 ради энергосбережения, под нагрузкой выходят на полную скорость автоматически.
-
Интеграция с сайтом через пять Python-скриптов. Автор подключил нейросеть к веб-сайту: ИИ получает сообщения пользователей, парсит (собирает) новостные заголовки и отвечает в рамках заданной роли. Всё работает в один поток, параметр OLLAMA_NUM_PARALLEL выставлен в 1, потому что ресурсы ограничены.
Как попробовать самому?
-
Найдите видеокарту с достаточным объёмом VRAM. Для модели на 7 миллиардов параметров нужно от 6 ГБ видеопамяти. Автор использовал две GTX 1660 Super (суммарно 12 ГБ). Одной карты с 8 ГБ тоже хватит для старта, но модель займёт почти всю память.
-
Установите Ubuntu и драйверы Nvidia. Автор использовал Ubuntu 24.04, отключил графическую оболочку и поставил проприетарные драйверы Nvidia. Это важно: без правильных драйверов Ollama не увидит видеокарту.
-
Установите Ollama и скачайте модель. Ollama ставится одной командой с официального сайта. Запуск модели:
ollama run qwen2.5:7b. Утилита сама скачает модель и распределит её по доступным видеокартам. -
Проверьте распределение нагрузки. Утилита nvtop покажет, как загружены карты и на какой скорости работает шина PCIe. Если одна из карт работает в урезанном режиме, попробуйте поменять карты местами в слотах, автору это помогло.
Чем отличается от облачных сервисов в России?
| Локальные нейросети (сборка из отчёта) | YandexGPT / GigaChat | |
|---|---|---|
| Где работает | На вашем компьютере, данные не уходят в сеть | Облако, запросы уходят на серверы компании |
| Стоимость | Разовые затраты на железо, софт бесплатный | Бесплатный лимит, затем подписка |
| Цензура и фильтры | Нет встроенных ограничений, вы сами решаете | Запросы фильтруются на стороне сервиса |
| Настройка «характера» | Полная: системный промпт (инструкция, задающая роль и стиль ответов модели) любой длины и содержания | Ограниченная, в пределах интерфейса |
| Скорость ответа | Зависит от вашего железа, на двух GTX 1660 Super текст генерируется с заметной задержкой | Быстро, мощные серверы |
| Русский язык | Зависит от модели, Qwen 2.5 7B справляется, по словам автора | Обучены специально под русский |
Для автора Дзена или предпринимателя, которому критична конфиденциальность, локальный вариант даёт контроль. Для быстрых задач вроде «перепиши абзац» облачные сервисы пока удобнее.
Этот отчёт ценен не технологическим прорывом, а честностью: автор показывает реальное железо, реальные проблемы (урезанная шина, капризы старой платы) и реальные решения. По моим наблюдениям, большинство гайдов по локальным нейросетям написаны владельцами RTX 4090 и бесполезны для человека с бюджетом до 15 000 рублей.
Оговорка: модель на 7 миллиардов параметров не заменит GPT-4o или Claude по качеству ответов. Для сложных задач (длинные аналитические тексты, работа с нюансами) облачные модели пока сильнее. Но для конкретной задачи автора (текстовый диалог с заданным характером на сайте) этого хватает.
Что сделать сегодня. Если у вас есть видеокарта Nvidia с 6 ГБ памяти или больше, поставьте Ollama и запустите Qwen 2.5 7B одной командой. Это займёт 20 минут и покажет, нужен ли вам вообще локальный ИИ, прежде чем вы потратите деньги на вторую карту.
Частые вопросы
Обязательно ли две видеокарты?
Нет. Одна карта с 8 ГБ VRAM потянет модель Qwen 2.5 7B. Две карты дают запас: модель занимает меньше памяти на каждой, остаётся место под контекст (историю диалога, которую модель «помнит» в рамках сессии). Автор выбрал две, потому что одна GTX 1660 Super у него уже была, а вторую нашёл недорого на вторичке.
Можно ли запустить локальную нейросеть на Windows?
Ollama работает и на Windows. Но автор отчёта использовал Ubuntu 24.04, отключив графическую оболочку, чтобы видеокарты отдавали всю память модели, а не тратили её на отрисовку рабочего стола. На Windows часть VRAM уйдёт на интерфейс системы, и для карт с 6 ГБ это может стать проблемой.
Зачем старая серверная плата, если можно взять обычную?
Обычная игровая плата чаще всего имеет один полноскоростной слот PCIe x16. Второй слот работает в урезанном режиме x4 или x8. Для распределения модели между двумя картами важна пропускная способность шины: чем она выше, тем быстрее карты обмениваются данными. Gigabyte GA-X79-UP4 даёт два слота в режиме x16, поэтому автор и выбрал её, несмотря на устаревшую память DDR3.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Amex показала, что такое ИИ-агент без права на ошибку: покупку блокируют до списания
Почему это важно American Express первой из платёжных гигантов предложила механизм, который фиксирует намерение покупателя до того, как ИИ-агент спишет деньги,…
Что такое ИИ-агент на практике: код пишется быстрее, но до продакшена едет дольше
Microsoft, Faros AI, CircleCI и DORA независимо друг от друга зафиксировали один и тот же парадокс: ИИ-агенты (автономные помощники, которые пишут код по…
Character AI подала на банкротство: 20 млн пользователей не спасли от убыточной модели
Character.AI, платформа для общения с ИИ-персонажами, 3 июня 2025 года подала заявление о банкротстве по главе 11 американского закона, спустя всего пять лет…
Комментарии