
Kimi K3.1 Pro с 2,8 трлн параметров догоняет Claude в коде, но проваливается в науке
Китайская Moonshot AI 10 июня выпустила Kimi K3.1 Pro, рассуждающую модель с 2,8 триллиона параметров и контекстным окном в миллион токенов, которая на ряде тестов программирования обошла сильные закрытые модели.
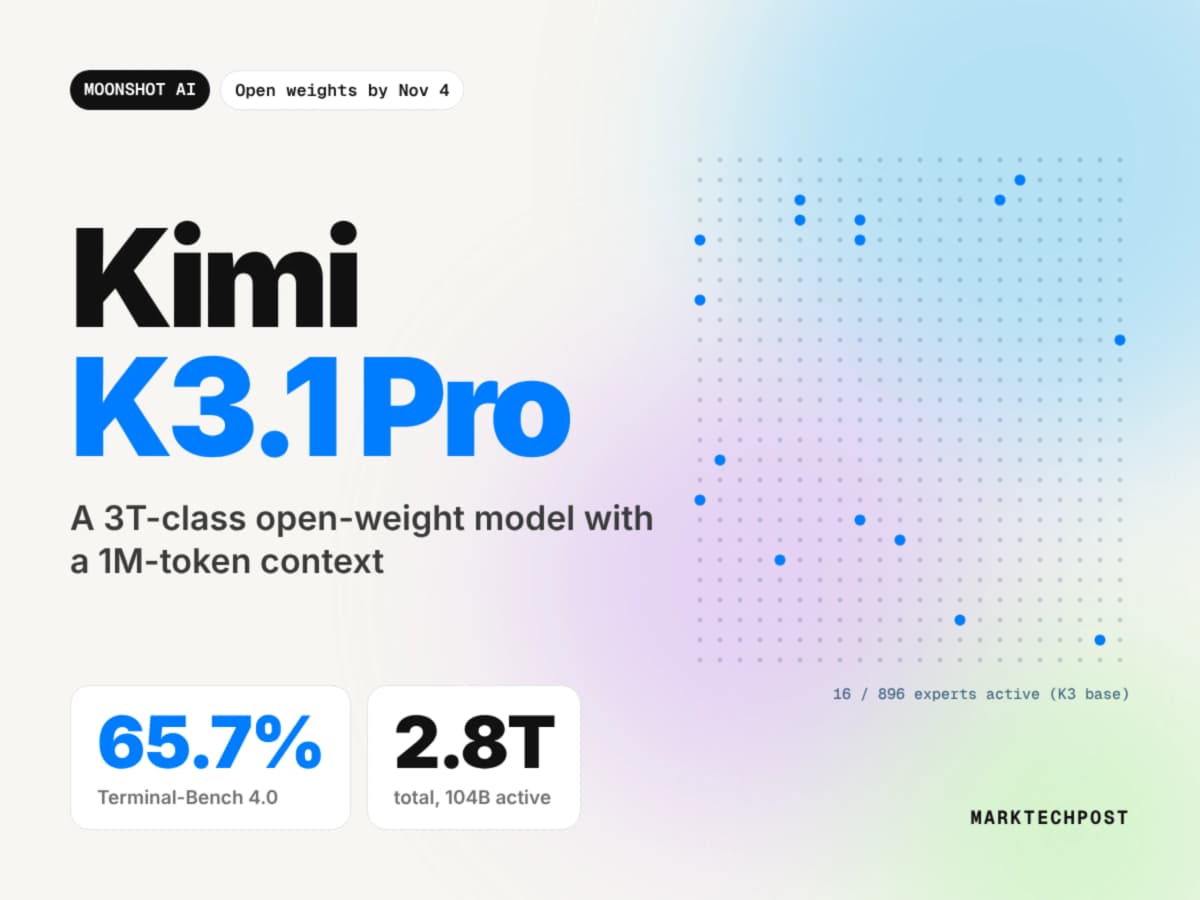
Kimi K3.1 Pro заявлена как модель с открытыми весами (open weights), но веса опубликуют только в ноябре 2026 года. Сегодня модель доступна лишь через API, а её результаты на бенчмарках заявлены самой Moonshot AI и не подтверждены независимо.
Moonshot AI позиционирует Kimi K3.1 Pro как прямого конкурента лучших закрытых моделей от OpenAI и Anthropic. Модель построена на архитектуре MoE (Mixture of Experts, «смесь экспертов», когда из сотен блоков-специалистов на каждый запрос активируются лишь нужные): из 896 экспертов одновременно работают только 16, что даёт 104 миллиарда активных параметров вместо полных 2,8 триллиона. Это позволяет держать огромную модель, не перегружая вычисления на каждом запросе. Источник данных о бенчмарках и ценах: официальный технический блог Moonshot AI и документация к API.
| Показатель | Значение | Источник |
|---|---|---|
| Общий размер модели | 2,8 трлн параметров | Moonshot AI, техблог |
| Активные параметры | 104 млрд (MoE) | Moonshot AI, техблог |
| Контекстное окно | 1 млн токенов (единиц текста, которые модель «видит» за один раз) | Moonshot AI, техблог |
| Terminal-Bench 4.0 (код) | 65,7% | Moonshot AI, самоотчёт |
| SWE-Marathon (код) | 51,7 | Moonshot AI, самоотчёт |
| Terminal-Bench Science 0.1 | 38,1 (у GPT-6 Astra: 68,1) | Moonshot AI, самоотчёт |
| Галлюцинации (Kimi Hallu Bench Hard) | 8,3% против 23,4% у K3 | Moonshot AI, самоотчёт |
| Цена API (вход / выход) | $2 / $10 за млн токенов | Moonshot AI, документация |
| Дата публикации открытых весов | ноябрь 2026 (ожидается) | Moonshot AI, техблог |
Что измеряли?
Moonshot AI протестировала Kimi K3.1 Pro на нескольких группах задач при максимальном уровне рассуждения, в основном через инструмент Claude Code harness.
- Программирование. Terminal-Bench 4.0 проверяет, как модель пишет и отлаживает код в терминале. SWE-Marathon оценивает способность решать длинные инженерные задачи.
- Наука. Terminal-Bench Science 0.1 тестирует научные рассуждения в терминальном режиме.
- 3D и CAD. BenchCAD проверяет работу с трёхмерными моделями и инженерными чертежами.
- Финансы. OfficeQA Pro v2 и Frontier Finance измеряют навыки финансового анализа.
- Галлюцинации. Kimi Hallu Bench Hard, внутренний стресс-тест Moonshot AI, считает долю ложных утверждений на уровне отдельных фактов (claim-level).
Все результаты заявлены самой компанией. Независимой проверки на момент публикации нет.
Где Kimi K3.1 Pro впереди, а где отстаёт?
- Лидер в марафонном коде. На SWE-Marathon модель набрала 51,7 балла. Для сравнения, Claude Opus 5.5 набрал 46,3 балла в той же таблице Moonshot AI.
- Почти на уровне лучших в обычном коде. Terminal-Bench 4.0: 65,7% у Kimi K3.1 Pro против 66,4% у Claude Opus 5.5 (разница 0,7 процентного пункта).
- Галлюцинации снизились. С 23,4% у предыдущей версии K3 до 8,3% у K3.1 Pro, по данным внутреннего теста Moonshot AI. Однако GPT-6 Astra показывает 5,5% на том же тесте.
- Провал в науке. Terminal-Bench Science 0.1: 38,1 у K3.1 Pro против 68,1 у GPT-6 Astra и 63,3 у Opus 5.5. Разрыв составляет 25 и более баллов.
- Финансы: заявлен лучший результат. 64,4 балла на OfficeQA Pro v2, по данным Moonshot AI.
Все цифры взяты из таблицы сравнения, опубликованной самой Moonshot AI, а не из независимых замеров. Ряд побед достигнут на внутренних бенчмарках компании (Kimi Code Bench, Kimi Hallu Bench Hard), которые сторонние исследователи пока не воспроизвели. Результаты конкурентов (Claude Opus 5.5, GPT-6 Astra) в таблице Moonshot AI тоже не подтверждены на страницах самих конкурентов. Модель с 2,8 триллиона параметров требует кластеров из 64 и более ускорителей, запустить её на домашнем железе невозможно.
Сколько стоит и как получить доступ?
Kimi K3.1 Pro доступна через Kimi API, а также на платформах Kimi.ai, Kimi Work и Kimi Code. Эндпоинт (точка подключения) совместим с форматом OpenAI, то есть разработчику не придётся переписывать код, если он уже работал с API OpenAI.
Цены за миллион токенов:
- Kimi K3.1 Pro: $2 на входе, $10 на выходе. Кэшированные запросы стоят $0,20.
- Kimi K3.1 Pro Highspeed (быстрая версия, по данным Moonshot AI работает в 2-3 раза быстрее): $4 на входе, $20 на выходе.
- Для сравнения: предыдущая Kimi K3 стоила $3 и $15.
То есть K3.1 Pro дешевле предшественницы при заявленном росте качества. Доступ открывается после минимального пополнения в $1.
Режим рассуждений включён всегда. Уровни: low, high, max (по умолчанию max). Максимальный вывод может достигать 1 048 576 токенов, фактически модель способна генерировать текст размером с книгу за один запрос.
Что это значит для вас?
Автору Дзена и копирайтеру. Kimi K3.1 Pro интересна прежде всего окном контекста в миллион токенов. На практике это значит: можно загрузить в модель длинный документ, серию статей или рукопись целиком и работать с ними без разбивки на куски. Если вы уже используете API нейросетей для генерации черновиков или рерайта, эта модель может обрабатывать объёмы, которые другие модели «забывают» на середине. Но режим рассуждений включён принудительно, и при простых задачах модель может «думать» дольше, чем нужно, и тратить больше токенов.
Маркетологу. Заявленные результаты в финансовом анализе и длинном коде выглядят сильно, но зависимость от API Moonshot AI и размещение данных на серверах китайской компании могут быть барьером для корпоративного использования в РФ. Из доступных в России аналогов с большим контекстным окном: YandexGPT (до 32 тысяч токенов) и GigaChat, оба значительно меньше по контексту.
Разработчику и предпринимателю. Совместимость с форматом OpenAI снижает порог входа. Цена $2/$10 за миллион токенов ниже, чем у многих западных моделей сопоставимого уровня. Но открытые веса обещаны только на ноябрь 2026 года, до этого момента самостоятельный хостинг невозможен, а значит, вы полностью зависите от API Moonshot AI.
Я вижу здесь два факта, которые важнее любых бенчмарков. Первый: китайские модели вышли на уровень, где разница с лидерами от Anthropic и OpenAI измеряется десятыми долями процента на кодовых задачах. Второй: «открытые веса в ноябре 2026» это не открытая модель сегодня, это обещание через полтора года. Для тех, кто работает в РФ, Kimi K3 пока остаётся моделью, доступной только через API китайской компании, без гарантий стабильности доступа. Пробовать стоит, привязывать к ней продукт пока рискованно.
Провал на научных задачах (38,1 против 68,1 у GPT-6 Astra) честно показывает: универсальной модели «лучше всех во всём» по-прежнему не существует, и выбирать инструмент нужно под конкретную задачу, а не по общему рейтингу.
По данным Marktechpost

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
SDD наоборот: плагин SlimSpec получает спецификации на сдачу и экономит 35% токенов
Компания Claude Code (Anthropic) получила плагин SlimSpec от независимого разработчика, который переворачивает привычный подход к спецификациям в…
Технический долг в легаси-коде: как «Совкомбанк Технологии» отдала рефакторинг ИИ-агенту
Технический долг (technical debt), то есть накопленные компромиссы в коде, которые замедляют разработку, копится в любом проекте, но в легаси-системах…
Теория мертвого интернета в цифрах: до 80% контента в отдельных нишах уже пишут нейросети
Производство контента дешевеет с каждым месяцем, и вопрос «сколько вокруг нас настоящего, человеческого» перестал быть философским и стал вполне практическим,…
Комментарии