
Как работает искусственный интеллект: 5 компонентов стека, которые путают даже разработчики
Искусственный интеллект в 2025 году перестал быть экспериментом, но разработчики, которые внедряют его в реальные проекты, регулярно спотыкаются на одних и тех же граблях: путают LLM с агентом, думают, что RAG решит любую проблему одним махом, и не видят, как связаны между собой компоненты стека.
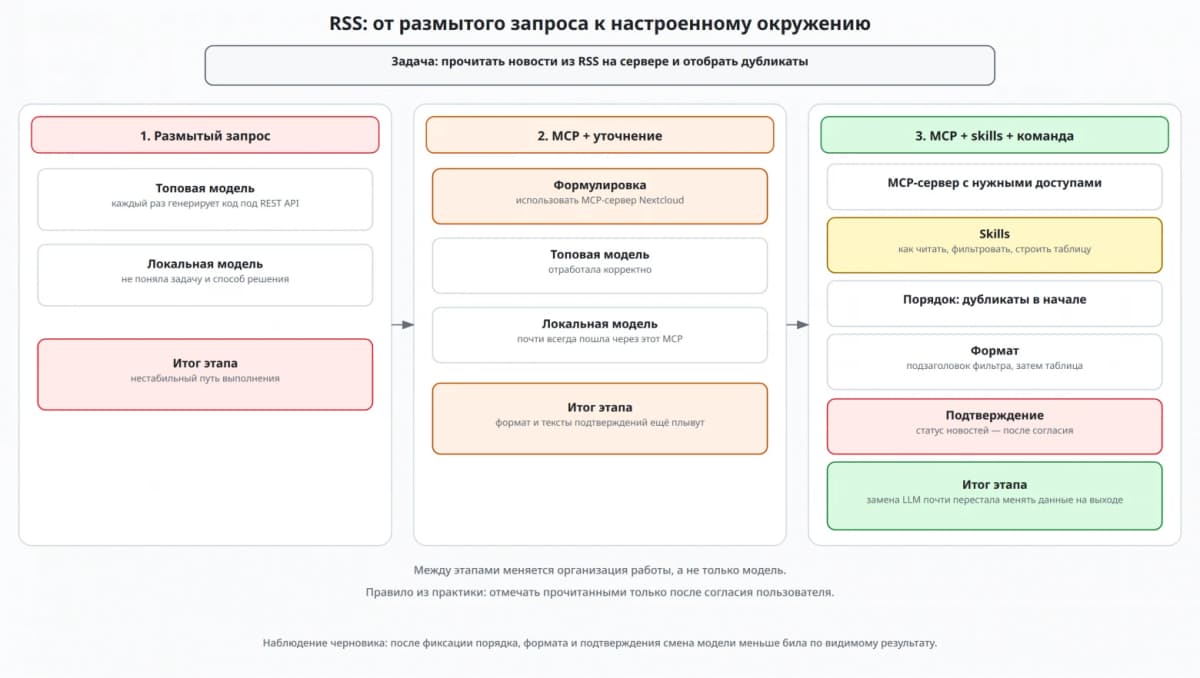
Без чёткой карты «что из чего состоит» команда тратит недели на решение, которое не работает, потому что выбран не тот инструмент: добавляют RAG там, где нужен скрипт, или строят агента там, где хватает одного промпта.
Автор оригинала, практик с 15+ годами опыта работы с нейросетями и бэкграундом от системного администратора до CTO, систематизировал знания, которые обычно разбросаны по десяткам англоязычных источников. Ниже я адаптировал его подход для тех, кто внедряет искусственный интеллект в рабочие задачи прямо сейчас и хочет перестать путаться в терминах.
Что понадобится
- Доступ к любой LLM онлайн: ChatGPT, Claude, GigaChat, YandexGPT или локальная модель через Ollama
- Блокнот или Notion для фиксации собственной карты терминов
- 30 минут на первое прочтение и ещё 15 на практику с промптами
- Желание разобраться, а не просто «попробовать и забыть»
Пять компонентов ИИ-стека и как они связаны между собой
Разберём каждый элемент по порядку. Именно этот порядок важен: каждый следующий компонент опирается на предыдущий.
1. LLM: мозг без рук
LLM (Large Language Model, большая языковая модель) понимает и генерирует текст, держит нить рассуждения в рамках контекста и следует инструкциям. Но сама по себе LLM не агент. Это «сильный инженер без доступа к цеху», как формулирует автор оригинала: он разберёт задачу и объяснит решение, но чтобы что-то сделать во внешнем мире, нужны инструменты и агентная обвязка.
Проверьте себя: когда вы пишете промпт (prompt, текстовая инструкция для модели) в ChatGPT и получаете ответ, вы работаете именно с LLM. Никаких внешних действий она сама не совершает.
2. ИИ-агент: помощник с мозгом, памятью и инструментами
ИИ-агент (agent) не ограничивается ответом. Он сам раскладывает задачу на шаги, подключает инструменты и доводит дело до результата. При этом могут быть заранее заданы блокеры: контрольные точки, где агент обязан спросить человека, или ограничения, которые он не может обойти.
Пример из оригинала: задача «найди причину перегрева станка и поставь его на паузу». Агент смотрит телеметрию, выбирает вероятную причину, останавливает станок. LLM в одиночку на это не способна.
3. RAG: генерация с опорой на найденные данные
RAG (Retrieval-Augmented Generation, генерация с опорой на найденные данные) работает так: модель не отвечает только из того, что запомнила при обучении. Сначала она достаёт нужную информацию из внешнего источника и потом строит ответ на основе найденного.
Цепочка выглядит так:
- Вопрос пользователя
- Поиск релевантных документов
- Извлечение нужных фрагментов
- LLM формирует ответ на их основе
Критически важный момент, на котором спотыкаются практики: RAG это не дообучение (fine-tuning, обучение модели на ваших примерах под узкую задачу). И векторная база данных для RAG не обязательна. Это лишь самый частый способ организовать поиск.
4. MCP: универсальный разъём для внешнего мира
MCP (Model Context Protocol, протокол контекста модели) задаёт единый способ подключать модели к внешним источникам и инструментам: API, базам данных, файлам, сервисам. Через него LLM получает контекст и вызывает внешние действия.
На практике, как отмечает автор, у агента есть три пути к одной и той же задаче (например, чтение RSS-ленты):
- Каждый раз генерировать код под REST API. Дорого и непредсказуемо.
- Взять готовый MCP-сервер и через него читать, помечать, сортировать новости.
- Написать скрипт для конкретной задачи. Фактически провести разработку.
Выбор зависит от задачи. Разовая задача может обойтись дешевле за счёт одноразового кода. Повторяющаяся требует MCP.
5. Skills: рецепты для агента
Skill (навык ИИ-агента) это повторно используемая инструкция или набор инструкций, которые объясняют агенту, как решать задачи конкретного класса.
Аналогия из оригинала: готовить агент уже умеет, skill говорит, как именно приготовить конкретное блюдо. Единого жёсткого стандарта skills пока нет, но де-факто стандартом стали инструкции в формате Markdown. Инструменты вроде Cursor, OpenCode, OpenClaw и Hermes опираются на эту идею.
Практичный совет из оригинала: универсальные указания храните отдельно, MCP и инструменты отдельно. Тогда один и тот же «рецепт» проще переносить между средами.
Откуда вообще взялся искусственный интеллект?
Короткая хронология помогает понять, почему всё ускорилось именно сейчас:
- 1943 год. Маккаллок и Питтс создают математическую модель искусственного нейрона.
- 1958 год. Mark I Perceptron. Систему не программировали вручную, а обучали на примерах. По данным Smithsonian, Mark I стал «электронным воплощением» идеи обучающейся машины. Это уже машинное обучение в миниатюре.
- 1960-е по 1990-е. Главное ограничение: вычислительная мощность. Доминирует символьный ИИ, правила задают вручную. Экспертные системы, языки Lisp и Prolog.
- 2017 год. Архитектура Transformer становится основой современных больших языковых моделей.
Разрыв между 1958 и 2017 годом объясняет, почему многие воспринимают искусственный интеллект онлайн как нечто внезапное: десятилетиями не хватало вычислительных мощностей, а потом прорыв случился за считанные годы.
Что делать с этим прямо сейчас, по ролям
Разработчику, который внедряет ИИ в проект. Прежде чем добавлять RAG, честно ответьте: проблема в устаревших данных модели или в плохом промпте? Автор оригинала прямо описывает типичный диалог: «добавим RAG и порядок». Нет, не порядок. Сначала карта компонентов, потом выбор инструмента.
Автору Дзена и контент-маркетологу. Разобравшись в пяти компонентах, вы сможете корректно писать про искусственный интеллект онлайн, не путая агента с моделью. Это повышает доверие аудитории и снижает количество правок от редактора.
Предпринимателю в РФ и СНГ. Все пять компонентов доступны через российские сервисы: GigaChat и YandexGPT работают как LLM, MCP-серверы устанавливаются локально, RAG можно развернуть на собственной инфраструктуре. Ограничение: агентные возможности у российских моделей пока уступают Claude и GPT-4o, но для большинства бизнес-задач их достаточно.
Задача: нужно, чтобы ИИ-агент каждое утро собирал новости по вашей отрасли из RSS и присылал короткую сводку.
Неправильный путь: просить LLM «следи за новостями» (она не имеет доступа к внешнему миру без инструментов).
Правильная цепочка: 1. LLM как мозг, понимает запрос и формирует сводку. 2. MCP-сервер для RSS, даёт агенту доступ к лентам новостей. 3. ИИ-агент как оркестратор, каждое утро запускает чтение RSS через MCP, передаёт найденное в LLM, получает сводку и отправляет вам. 4. Skill, инструкция «как именно фильтровать и форматировать сводку».
RAG здесь не нужен, данные свежие и приходят напрямую. Это и есть осознанный выбор компонента вместо «добавим всё сразу».
«RAG решит всё». RAG полезен, когда модели не хватает актуальных или специфических данных. Если проблема в плохо составленном промпте, RAG добавит шума, а не точности.
Путаница LLM и агента. Если вы просите ChatGPT «зайди на сайт и скачай файл», вы ожидаете агентного поведения от чистой LLM. Без инструментов и обвязки она этого не сделает.
Один термин, два смысла. Автор оригинала отмечает: два человека используют одни и те же слова, но говорят о разном. Договоритесь о терминах до начала проекта, иначе один думает про дообучение, а другой про RAG, и оба считают, что согласны.
Избыточная архитектура. Не каждой задаче нужен MCP-сервер. Разовую операцию дешевле решить одноразовым скриптом, как прямо указано в оригинале.
Я давно заметил, что большинство ошибок при внедрении искусственного интеллекта в реальные проекты начинаются не с кода, а с терминологии. Человек говорит «нам нужен ИИ-агент», а имеет в виду «хочу чат-бот, который отвечает по базе знаний». Это два разных продукта с разным бюджетом.
Карта из пяти компонентов, которую систематизировал автор оригинала, на мой взгляд, лучший способ навести порядок в голове до того, как открыт первый IDE. Распечатайте, повесьте рядом с монитором, сверяйтесь при каждом техническом решении.
Честная оговорка: эта карта описывает текущее состояние стека. Через полгода появятся новые протоколы и подходы. Но базовая логика «мозг отдельно, руки отдельно, данные отдельно, рецепты отдельно» останется актуальной.
Попробуйте ИИ-инструменты dzen.guru
Применяйте полученные знания на практике: тестируйте промпты, стройте контент-стратегии с опорой на ИИ и разбирайтесь в новых инструментах вместе с сообществом.
Перейти к инструментамГлавное, что стоит забрать из этого разбора: прежде чем писать код или покупать подписку на очередной сервис искусственного интеллекта онлайн, нарисуйте свою карту из пяти компонентов и честно отметьте, какой из них решает вашу конкретную задачу. Один правильно выбранный элемент стека экономит больше времени, чем пять неправильно собранных.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
DeepSeek AI хранит чаты в 7 уровнях JSON: как извлечь 5 000+ сообщений за 10 минут
DeepSeek AI хранит историю чатов в формате JSON, и при объёме свыше 5 000 сообщений скопировать текст вручную невозможно, но открытая утилита позволяет извлечь…
Разработка логотипа с помощью нейросети ни при чём: джун с ИИ против сеньора в битве за код
Разработка логотипа с помощью нейросети тут ни при чём: речь о коде, и ставки выше, чем кажутся. Канал «Вайбкодер» предложил эксперимент, который наконец…
Нейросеть для написания кода сэкономила часы, но проект растянулся на два месяца: почему
Нейросеть пишет код за часы, но 90% времени всё равно уходит на решения, которые она принять не может: русский разработчик разбирает реальный проект с…
Комментарии